
大模型应用开发 / 系统课时
使用查询改写
使用查询改写
查询改写用于解决用户问题表达不完整、口语化或依赖上下文导致检索效果不佳的问题。本节将学习如何把原始问题转换为更适合知识库检索的独立查询,提高召回结果的相关性。
学习目标
- 理解查询改写在 RAG 检索链路中的作用。
- 掌握基于规则和模型的查询改写方式。
- 能够实现一个简单的查询改写流程并验证效果。
理解查询改写解决的问题
用户输入通常面向人类交流,而检索系统需要结构明确、信息完整的查询。例如用户输入“它怎么配置?”时,系统无法知道“它”指向什么对象,也无法直接匹配知识库中的文档标题。
查询改写会在检索前增加一个转换步骤,将用户问题补充必要上下文,生成语义完整的检索请求。
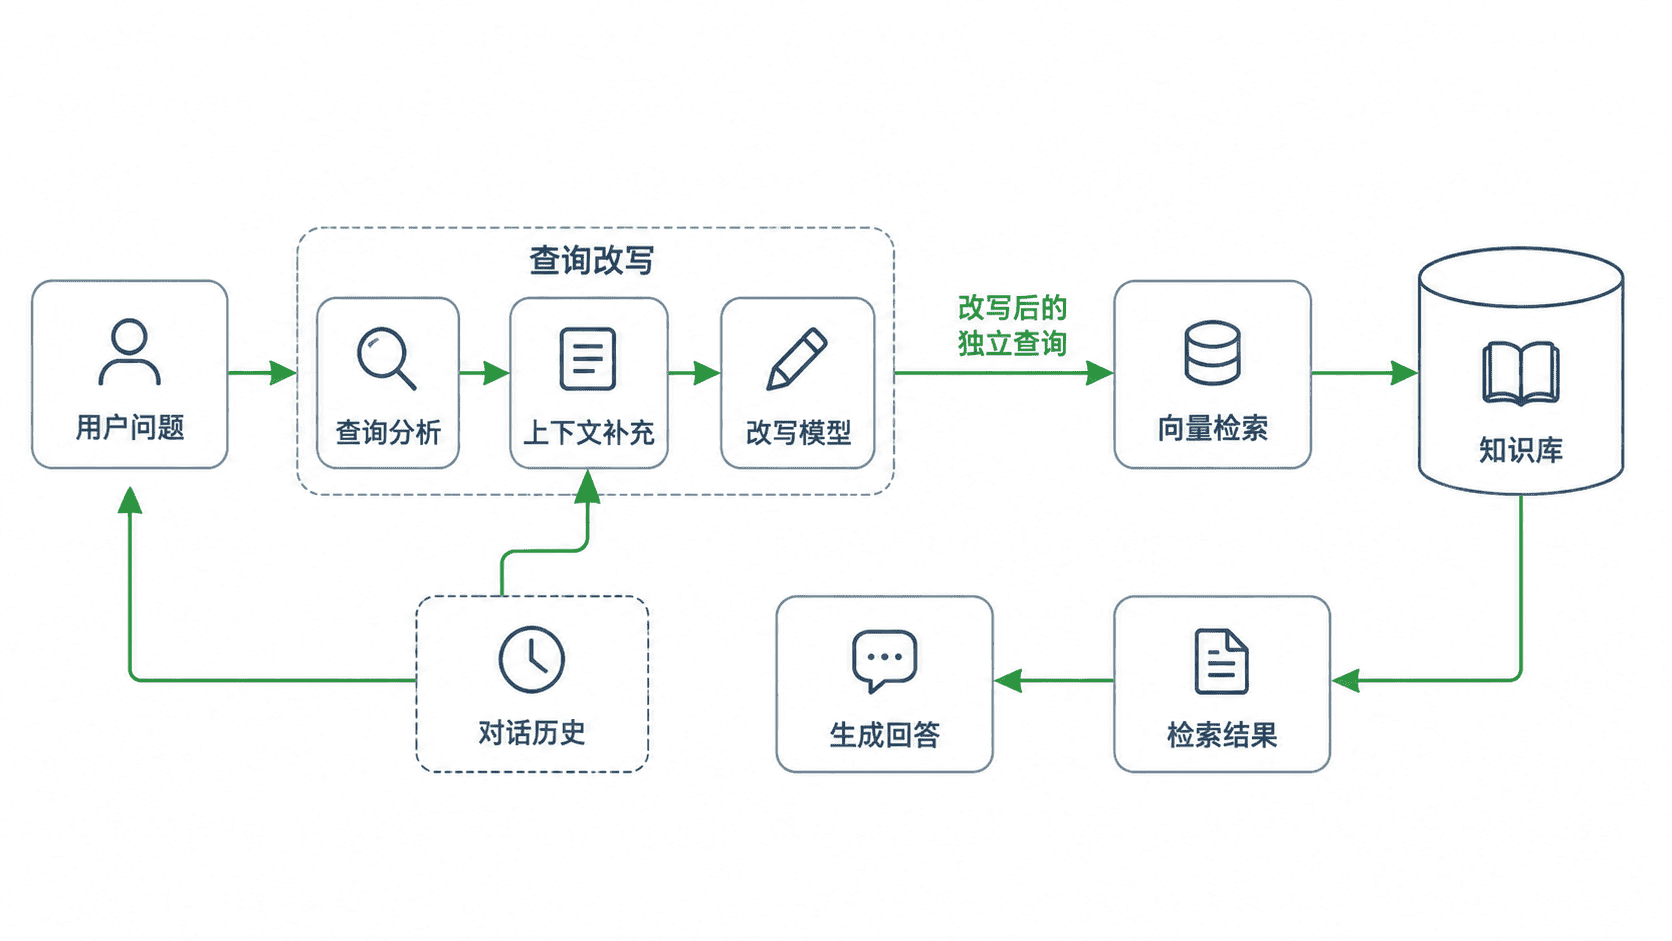
查询改写的常见方式
规则改写适用于固定格式的问题,例如根据会话历史替换代词、补充产品名称。它实现简单、成本低,但面对复杂表达时能力有限。
模型改写则利用大语言模型理解用户意图,将问题重新组织。例如:原问题:“上一条说的那个接口怎么调用?”。改写后:“用户认证接口的调用方式和请求参数是什么?”。改写后的查询包含明确对象,更容易命中知识库内容。
实现一个简单的查询改写流程
下面示例使用 Python 模拟一个基于上下文补充的改写器。在实际项目中,可以将改写函数替换为大模型调用。
python
from dataclasses import dataclass

@dataclass
class QueryContext:
    previous_topic: str

def rewrite_query(query: str, context: QueryContext) -> str:
    # 简单处理指代词,实际项目可替换为 LLM 改写
    if "它" in query or "那个" in query:
        return f"{context.previous_topic} {query.replace('它', '').replace('那个', '')}".strip()
    return query

context = QueryContext(previous_topic="用户认证接口")
result = rewrite_query("它怎么调用?", context)
print(result)
预期输出
text
用户认证接口 怎么调用?查询改写的边界
查询改写并不是越复杂越好。如果改写过程改变了用户真实意图,可能导致检索偏离。例如用户询问“Redis 如何删除缓存”,改写成“Redis 集群故障排查”会降低准确性。
实际系统通常需要保留原始查询,并将改写结果作为辅助检索条件。当改写置信度不足时,可以同时检索原问题和改写问题,再合并结果。
按自己的节奏,确认真正理解。