
Linux 与服务器运维 / 系统课时
完成一次线上故障综合演练
完成一次线上故障综合演练
复合故障最容易让排查顺序失控:服务不可用、磁盘增长和连接异常同时出现时,如果边猜边改,往往会丢失证据或扩大影响。本篇用一套固定处置顺序完成演练,并把关键检查沉淀成可复用的现场清单。
学习目标
- 能按影响确认、取证、止损、定位、修复、验证和复盘的顺序处置复合事故
- 能同时收集服务、磁盘与网络三类最小证据
- 能把一次演练转化为可重复执行的故障处理检查清单
先在隔离环境构造故障
不要直接在生产主机制造磁盘打满、断网或杀死真实业务进程。下面的演练只在 /tmp 创建一个小文件,用本地 HTTP 服务模拟应用,再用未监听端口模拟下游连接失败,不改防火墙规则。
WORKDIR="/tmp/anystack-incident-drill"
APP_PORT=18080
DOWNSTREAM_PORT=18081

mkdir -p "$WORKDIR"
dd if=/dev/zero of="$WORKDIR/growing.log" bs=1M count=32 status=none

python3 -m http.server "$APP_PORT" --bind 127.0.0.1   >"$WORKDIR/app.log" 2>&1 &
APP_PID=$!

sleep 1
curl -fsS "http://127.0.0.1:$APP_PORT/" >/dev/null
echo "service=ok file_size=$(du -h "$WORKDIR/growing.log" | awk '{print $1}')"

kill "$APP_PID"
sleep 1

curl --connect-timeout 1 "http://127.0.0.1:$APP_PORT/" || true
curl --connect-timeout 1 "http://127.0.0.1:$DOWNSTREAM_PORT/" || true
预期输出
service=ok file_size=32M
curl: (7) Failed to connect to 127.0.0.1 port 18080: Connection refused
curl: (7) Failed to connect to 127.0.0.1 port 18081: Connection refused
不同 curl 版本的错误文案可能略有差异。此时已经同时具备三个调查线索:服务不可用、文件持续占用空间的风险、连接目标不可达。
按固定顺序完成处置
复合事故不要先追求“找到唯一根因”,而要先控制影响。推荐把操作顺序固定为七个阶段:确认影响、收集证据、止损、定位根因、实施修复、验证恢复、复盘沉淀。只有当新的操作不会破坏关键证据时,才进入下一阶段。
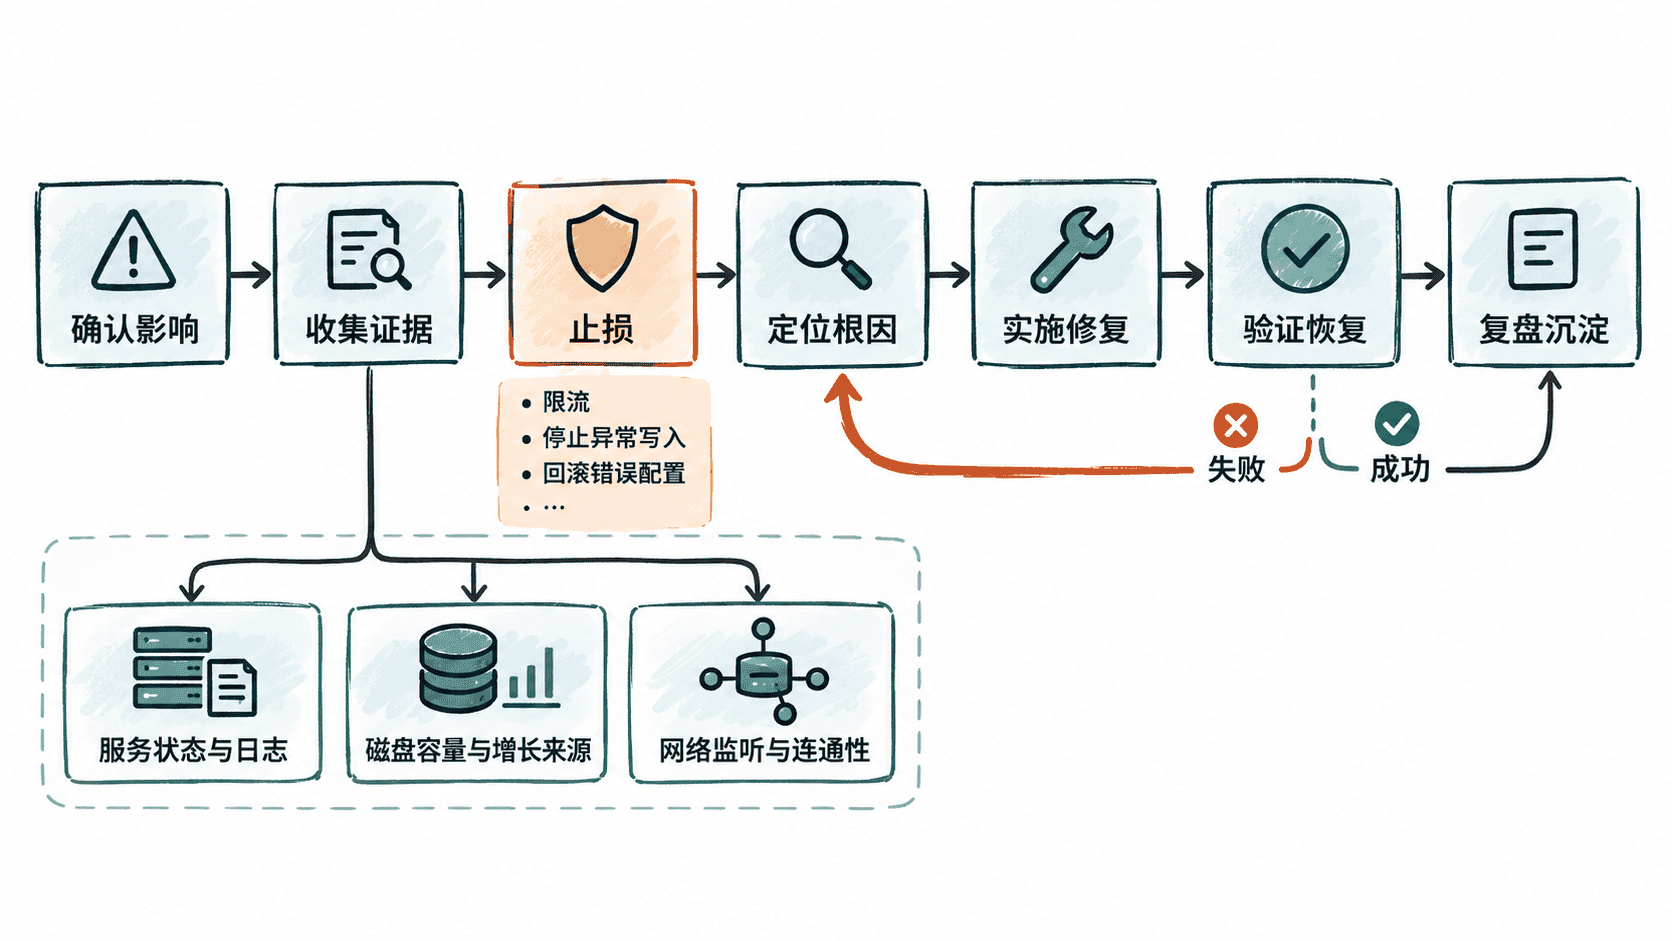
确认影响时先回答“谁受影响、影响多大、从什么时候开始”。服务完全不可用与单个接口变慢的处置优先级不同;磁盘使用率上涨也要区分容量已经触顶还是仍有安全余量。这个阶段只建立事故边界,不急着改配置。
取证完成后再止损。若日志异常增长,先限制增长源或临时降级,而不是直接删除未知文件;若服务因错误配置持续重启,可先停止重启风暴;若下游地址错误,应优先回滚最近变更。止损目标是减少新增损失,不是一次性修完所有问题。
收集最小证据集
真实现场中,把服务名和端口替换成实际值。以下命令从同一时间点采集主机负载、systemd 状态、近期日志、磁盘容量、inode、监听端口与健康检查,便于后续把不同症状放到同一时间线上比较。
SERVICE="myapp.service"
PORT=8080

date -Is
hostname
uptime
systemctl status "$SERVICE" --no-pager -l
journalctl -u "$SERVICE" --since "-10 min" --no-pager | tail -n 80
df -hT
df -ih
ss -lntp
curl -sS -o /dev/null   -w 'http=%{http_code} time=%{time_total}\n'   "http://127.0.0.1:$PORT/health"
预期输出
<TIME>
<HOST>
<TIME> up <TIME>,  <ID> users,  load average: ...
...
Filesystem     Type  Size  Used Avail Use% Mounted on
...
LISTEN ... :8080 ... users:(("myapp",pid=<ID>,fd=<ID>))
http=200 time=<TIME><TIME>、<HOST>、<ID> 以及磁盘数值都随现场变化。如果健康检查失败,不要只记录“curl 失败”,还要同时保留当时的监听状态和应用日志;如果磁盘紧张,则继续用 du、find 或日志系统自身的工具定位增长来源。
止损后分别定位三条故障线
服务不可用先判断是进程没启动、进程反复退出,还是进程正常但健康检查失败;磁盘增长要区分块空间不足与 inode 耗尽,再定位具体目录和写入者;网络异常则按本机监听、路由/DNS、远端端口和上游策略逐层确认。
三个症状可能属于一个根因,也可能只是同时发生。比如错误配置既可能让应用绑定了错误端口,也可能触发大量错误日志导致磁盘增长;但也可能是磁盘满与下游故障两个独立事件。只有时间线和证据能证明关联,不能因为“同时出现”就默认它们来自同一个原因。
修复后做三层验证
验证不能只看“页面能打开”。至少检查服务层、资源层和依赖层:服务状态稳定且无重启风暴;磁盘使用率停止异常增长并留有余量;监听端口和关键依赖恢复,健康检查连续成功。
SERVICE="myapp.service"
PORT=8080

systemctl is-active "$SERVICE"
systemctl show "$SERVICE" -p NRestarts
df -h /
ss -lntp "sport = :$PORT"
curl -sS -o /dev/null   -w 'http=%{http_code} time=%{time_total}\n'   "http://127.0.0.1:$PORT/health"
journalctl -u "$SERVICE" --since "-5 min" --no-pager | tail -n 30
预期输出
active
NRestarts=<ID>
Filesystem      Size  Used Avail Use% Mounted on
...
LISTEN ... :8080 ... users:(("myapp",pid=<ID>,fd=<ID>))
http=200 time=<TIME>
...
把验证结果与事故开始时的证据对照:如果服务恢复但磁盘仍持续增长,事故还没有真正结束;如果 HTTP 已经 200,但 NRestarts 仍在增加,也应继续定位稳定性问题。
把演练沉淀成现场清单
复盘的产物应能在下一次故障中直接使用,而不是只写一句“加强监控”。至少固化以下检查项:影响范围和开始时间是否明确;关键命令输出是否留存;止损动作是否可回滚;每个根因是否有证据支撑;修复后是否完成服务、资源、网络三层验证;是否补上导致发现过晚或恢复过慢的监控、告警和 Runbook。
完成演练后删除临时目录即可清理模拟文件。
rm -rf /tmp/anystack-incident-drill
test ! -e /tmp/anystack-incident-drill && echo "drill workspace removed"
预期输出
drill workspace removed真正可复用的能力不是记住某条命令,而是在压力下仍保持顺序:先确认影响并保全证据,再止损、定位和修复,最后用多层验证证明业务已经稳定恢复。