
Linux 与服务器运维 / 系统课时
用 vmstat 判断资源压力
用 vmstat 判断资源压力
vmstat 的价值不是给出某个“利用率”,而是把运行队列、阻塞进程、换页、块设备 I/O、上下文切换和 CPU 时间放在同一张快照里。本篇给出一套固定观察顺序,用连续样本区分 CPU 饱和、内存紧张和磁盘等待,避免被单一指标误导。
学习目标
- 能读懂
r、b、si、so、in、cs、id、wa等关键字段。 - 能结合 CPU 数量和连续样本判断 CPU、内存或 I/O 压力。
- 能根据
vmstat结果选择下一步验证工具,而不是直接下结论。
先采连续样本
先取得逻辑 CPU 数量,再每秒采样一次。vmstat 第一行通常是自系统启动以来的平均值,判断当前压力时应主要看后续行。
printf 'cpus='
nproc
vmstat 1 5
预期输出
cpus=<N>
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
<N> <N> <N> <N> <N> <N> <N> <N> <N> <N> <N> <N> <N> <N> <N> <N> <N>
...
<N> 代表现场采样值,实际数字会不同。真正有意义的是后续多行是否持续呈现同一种模式,而不是某一秒突然出现尖峰。
按固定顺序读字段
先看 r 和 b。r 是正在运行或等待 CPU 的任务数量;当后续样本里的 r 长时间明显高于逻辑 CPU 数,且 id 接近 0、wa 又不高时,CPU 饱和的可能性较大。b 表示不可中断睡眠中的任务,常见于等待块设备 I/O。
再看 si、so 与 swpd。swpd 只说明已经使用了多少交换空间,单独非零并不能证明正在内存抖动;更值得警惕的是 si、so 在连续样本中持续大于 0,说明系统正在频繁换入换出。此时应继续看进程内存、页错误和 OOM 记录。
最后看 CPU 列与系统活动。id 是空闲 CPU,wa 是等待 I/O 的 CPU 时间比例;us、sy 分别表示用户态和内核态消耗。in、cs 是每秒中断和上下文切换次数,明显升高时只能说明系统活动密集,仍要结合工作负载和历史基线判断。
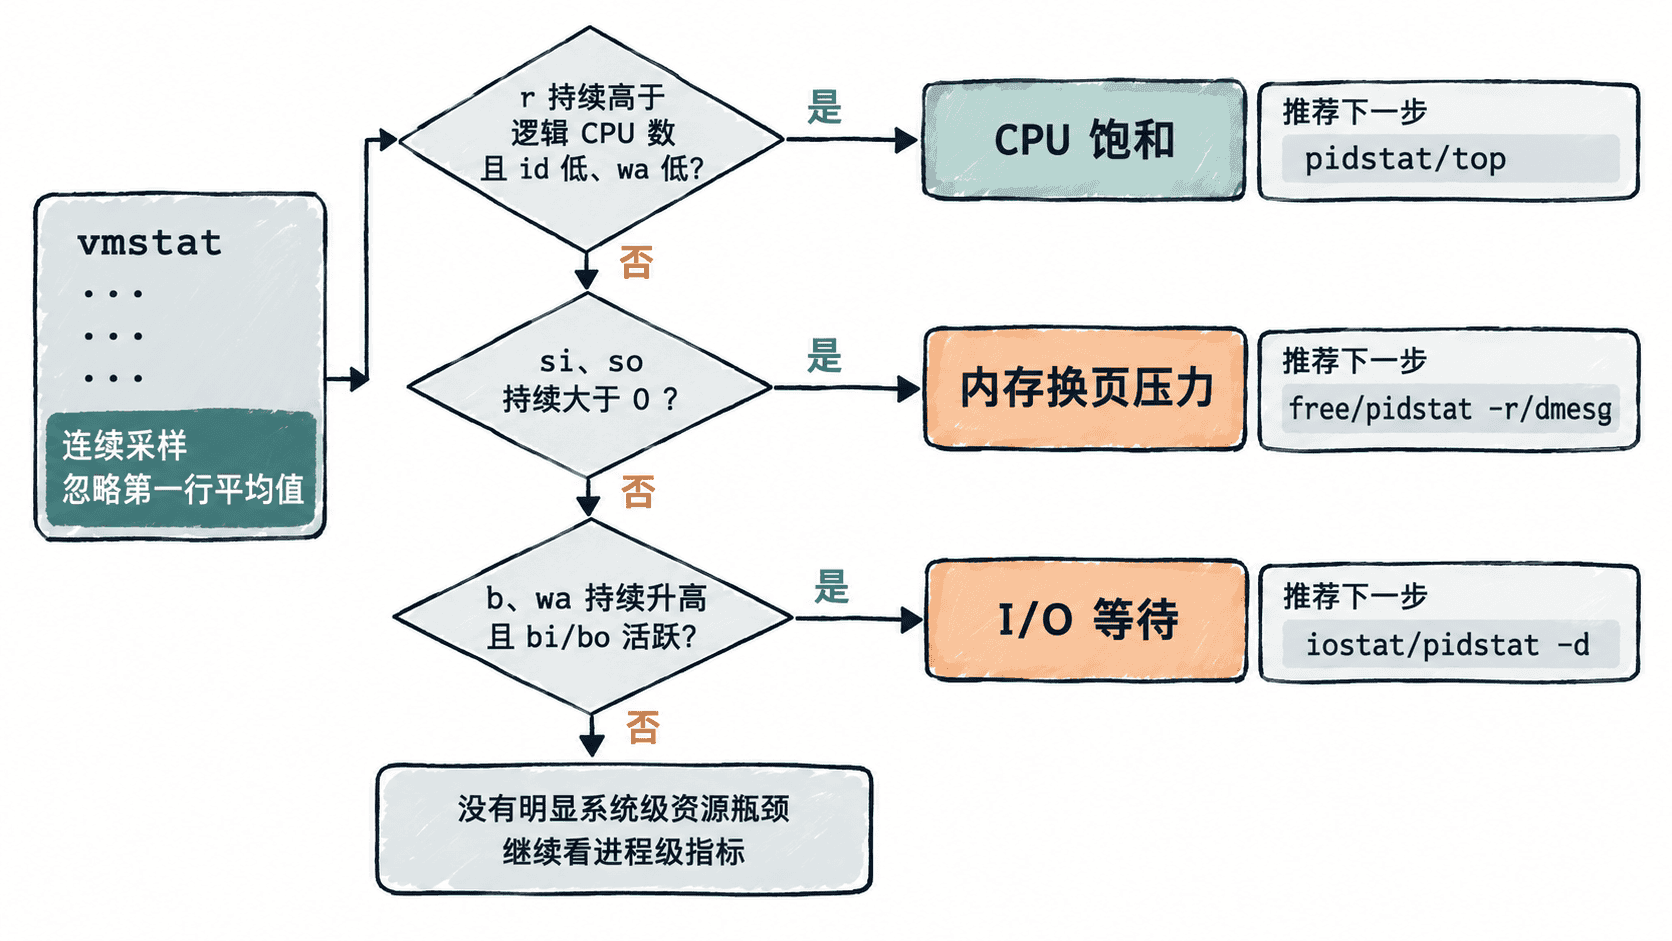
用组合特征区分三类压力
不要用“某字段超过固定百分比”作为通用阈值,机器规格和负载模型不同,绝对数字必须结合基线。更可靠的是识别字段组合。
| 现象 | 典型组合 | 优先解释 |
|---|---|---|
| CPU 饱和 | r 持续高于 CPU 数,id 很低,wa 不高 |
可运行任务争抢 CPU |
| 内存紧张 | si、so 持续非零,常伴随回收和延迟上升 |
活跃内存超过可承受范围 |
| I/O 等待 | b 增多,wa 持续高,bi/bo 活跃 |
任务在等待块设备完成 I/O |
例如 id 很低但 wa 很高时,不应直接说“CPU 算力不足”,因为 CPU 可能大部分时间在等 I/O。反过来,free 很小也不等于内存不足,Linux 会主动使用内存做缓存,必须结合交换活动和更完整的内存指标。
根据模式继续定位
vmstat 适合做系统级分流,不负责告诉你“哪个进程”或“哪块磁盘”是根因。确认 CPU 争用后,可用 pidstat -u 1 3 或 top 找消耗 CPU 的进程;确认换页后,用 pidstat -r 1 3、free -h 和 dmesg 检查进程内存与 OOM 迹象;确认 I/O 等待后,用 iostat -xz 1 3 或 pidstat -d 1 3 继续下钻到设备与进程。
这些工具的具体数值都必须结合业务基线。排障时先用 vmstat 判断“压力属于哪一类”,再用进程级或设备级工具验证根因,比盯着单一 CPU 或内存百分比更稳定。