
Linux 与服务器运维 / 系统课时
用 iostat 定位磁盘 I/O 瓶颈
用 iostat 定位磁盘 I/O 瓶颈
本篇用 iostat 建立一条可复用的磁盘排障路径:先看设备延迟、队列、吞吐和利用率,再下钻到进程与文件证据,判断延迟究竟来自小块随机 I/O、顺序吞吐压力,还是存储设备本身异常。
学习目标
- 能用扩展设备指标判断磁盘是否正在排队或响应变慢。
- 能把设备级异常继续关联到具体进程和打开的文件。
- 能区分随机小 I/O、顺序大 I/O 与存储侧异常的典型证据组合。
先建立设备级基线
iostat 来自 sysstat。排障时不要只看 CPU 的 %iowait,因为它只能说明 CPU 空闲期间存在未完成 I/O,不能告诉你是哪块设备、延迟多高,也不能单独证明磁盘已饱和。
先连续采样,而不是只看一次累计值:
iostat -dxz -y 1 5预期输出(节选,字段会随 sysstat 版本略有差异):
Device            r/s    rkB/s  rareq-sz     w/s    wkB/s  wareq-sz  await  aqu-sz  %util
nvme0n1       <READ_IOPS> <READ_KIB> <READ_SIZE> <WRITE_IOPS> <WRITE_KIB> <WRITE_SIZE> <AWAIT> <QUEUE> <UTIL>
这里 -d 只看设备,-x 打开扩展指标,-z 隐藏完全空闲的设备,-y 跳过“自开机以来”的首份累计报告。实际数值会随负载变化。
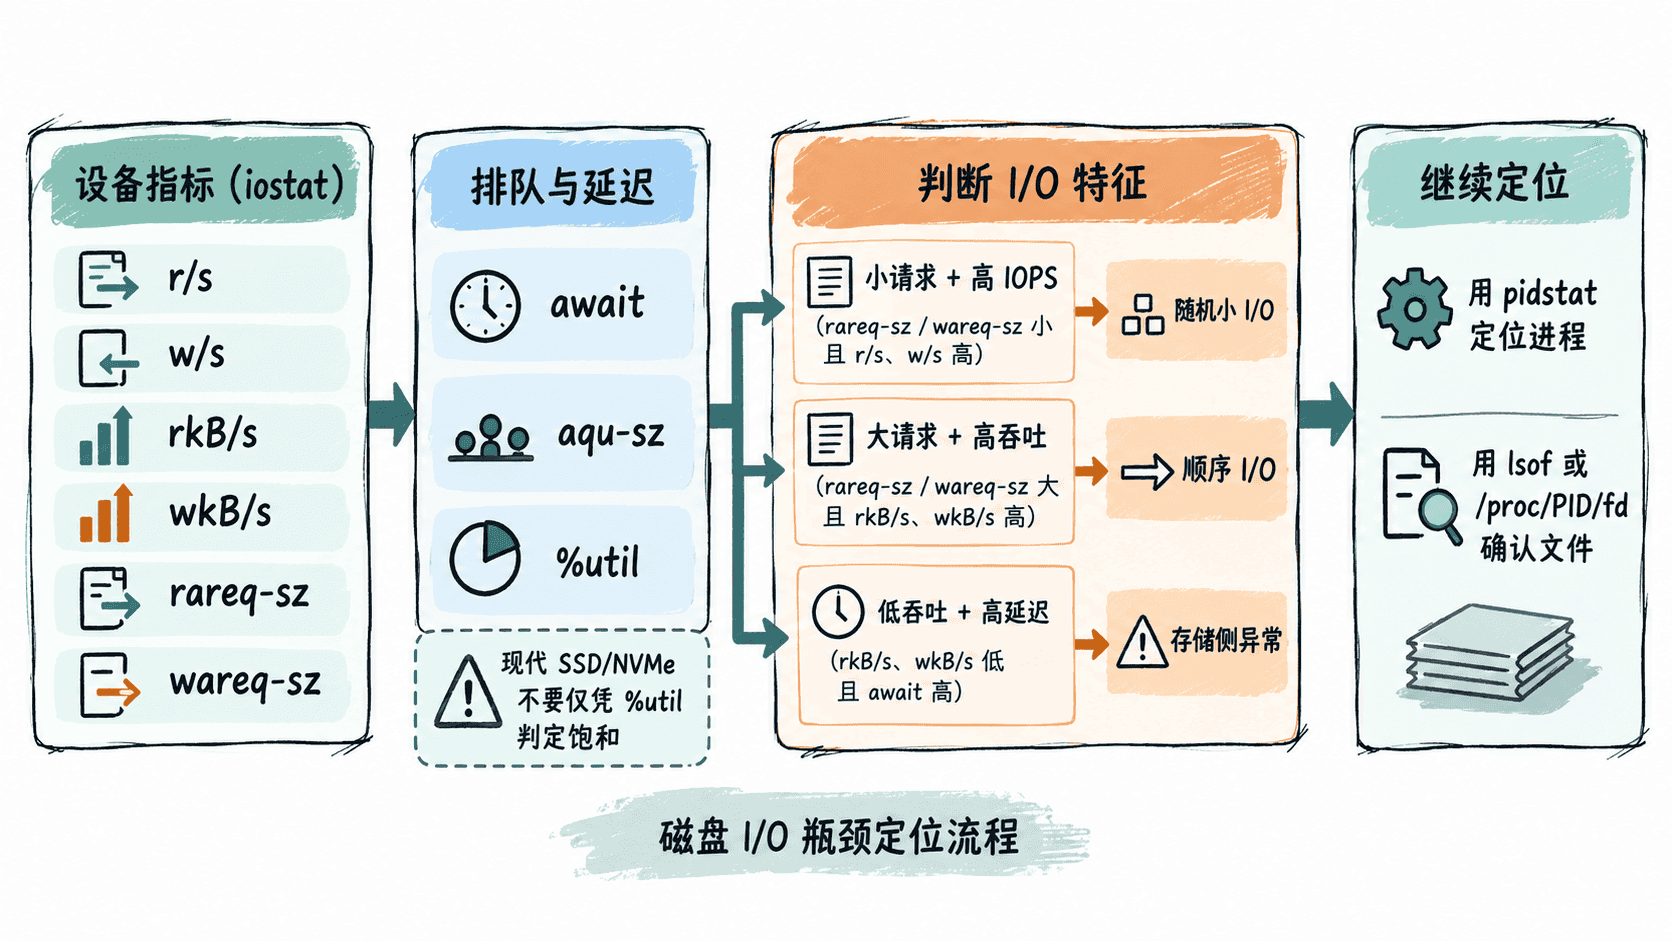
重点把指标按“量、排队、延迟”组合起来看:r/s、w/s 是 IOPS,rkB/s、wkB/s 是吞吐;rareq-sz、wareq-sz 反映平均请求大小;aqu-sz 代表平均队列长度;await 包含排队与服务时间。%util 接近 100% 对串行设备很有参考价值,但 RAID、NVMe 和其他可并行设备不能仅凭这一项判定已经到性能上限。
用指标组合判断瓶颈形态
单个阈值很容易误判,应先看组合趋势。高 await 与持续增长的 aqu-sz 同时出现,通常说明请求正在排队;如果吞吐已经接近设备历史高位,可能是容量上限。如果吞吐并不高却延迟突然抬升,则要怀疑设备抖动、云盘限速、路径异常或底层存储问题。
随机与顺序 I/O 也不要只凭“感觉”判断。小 rareq-sz、wareq-sz 配合较高 IOPS,更像大量小块访问;较大的请求尺寸配合高吞吐,更像顺序读写。iostat 只能给出设备侧形态,仍需要进程和文件证据确认真实工作负载。
下钻到进程与文件
确认某个设备异常后,下一步不是立刻调内核参数,而是找出谁在产生 I/O。假设已经从业务或进程列表中确定 PID,把 <PID> 替换为真实值:
PID=<PID>
pidstat -d -p "$PID" 1 3
sudo lsof -p "$PID" | grep ' REG ' | head -n 20
预期输出(节选):
UID        PID   kB_rd/s   kB_wr/s kB_ccwr/s iodelay  Command
<UID>    <PID>   <READ>    <WRITE>   <CANCEL> <DELAY>  <PROCESS>

<PROCESS> <PID> <USER> <FD> REG <DEV> <SIZE> <ID> <PATH>
pidstat -d 能证明某个进程正在持续读写,lsof 则把进程关联到实际文件。若数据库数据文件、日志、临时文件或备份目标恰好位于异常设备上,就能把“设备慢”收敛成可处理的业务原因。若进程 I/O 很低而设备 await 仍持续异常,应进一步查看多路径、虚拟化宿主机、云盘限额和存储端健康状态。
修复后重新验证
修复必须回到同一组指标验证,而不是只看业务“好像恢复了”。重新执行相同采样,确认 await 与 aqu-sz 回落,吞吐和 IOPS 回到可解释范围,同时检查请求延迟是否同步恢复。
如果瓶颈来自小块随机 I/O,可优先从索引、缓存、合并写、并发度与数据布局入手;如果是顺序吞吐打满,则考虑错峰、限速、扩容或更高带宽存储;如果吞吐很低但设备延迟高,优先处理存储链路或设备异常,而不是继续给应用加并发。