
Linux 与服务器运维 / 系统课时
设置主机告警与容量阈值
设置主机告警与容量阈值
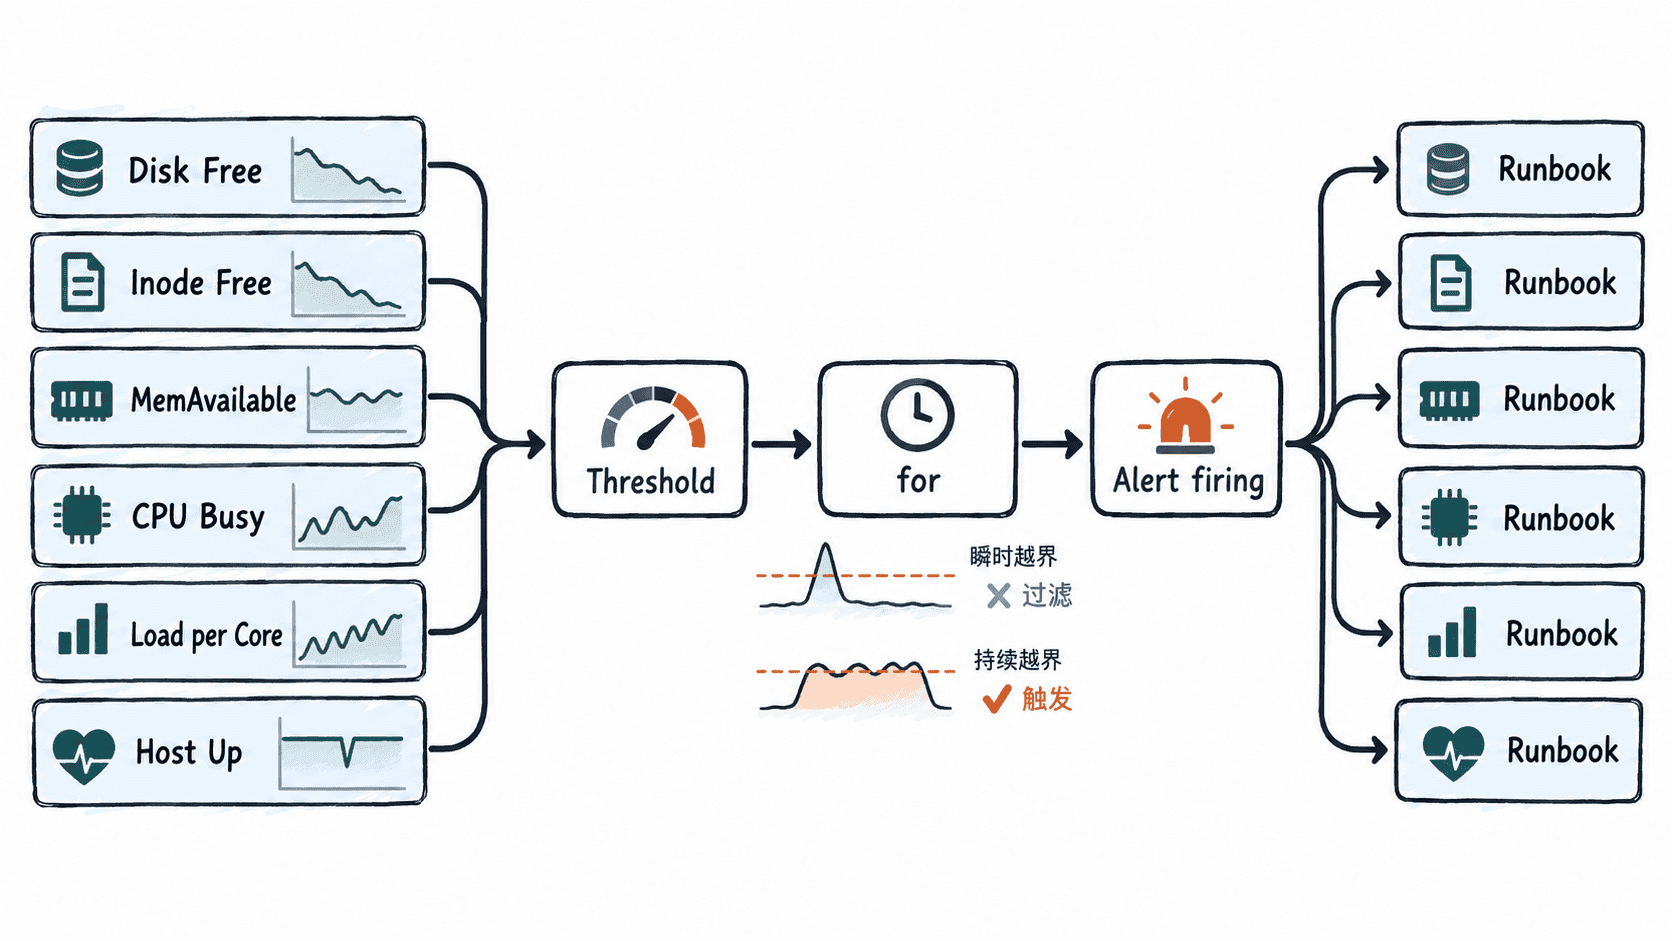
主机告警的目标不是“指标一超线就报警”,而是把容量风险变成可执行信号:什么指标越界、持续多久才算问题、触发后先查哪里。本节用 node_exporter 与 Prometheus 规则覆盖磁盘、inode、内存、CPU、负载和主机存活,并给出可落地的排查入口。
学习目标
- 为六类主机风险选择可解释的阈值和持续时间
- 使用 Prometheus 告警规则区分瞬时波动与持续风险
- 为每条告警绑定明确的第一排查入口,并能验证规则语法
先把阈值写成可执行条件
容量告警至少包含“信号、阈值、持续时间、排查入口”四部分。阈值不是行业固定答案,下面是一组适合作为起点的基线;上线后应再结合业务峰值、历史分位数和扩容周期调整。
| 风险 | 起始告警条件 | 持续时间 | 第一排查入口 |
|---|---|---|---|
| 根分区剩余空间 | 可用比例 < 15% | 15 分钟 | df -hT,再查大目录与日志增长 |
| inode 耗尽 | 可用比例 < 10% | 15 分钟 | df -i,再查小文件密集目录 |
| 内存压力 | MemAvailable < 10% |
10 分钟 | free -h、vmstat 1,再定位 RSS 与换页 |
| CPU 饱和 | 非 idle 比例 > 90% | 10 分钟 | top 或 pidstat 1,定位高占用进程 |
| 负载过高 | 15 分钟负载 / CPU 核数 > 1.5 | 15 分钟 | uptime,再区分 CPU 等待与 I/O 等待 |
| 主机不可达 | 抓取目标 up == 0 |
2 分钟 | 先查网络、node_exporter,再查主机状态 |
for 是避免瞬时尖峰造成噪声的关键。CPU 在发布瞬间冲到 95% 不一定要叫醒值班人员;磁盘持续低于安全水位 15 分钟,则说明清理或扩容窗口正在缩小。
用 Prometheus 把阈值落成规则
片段示例:假设 node_exporter 以 job="node" 被 Prometheus 抓取,根文件系统挂载点为 /。将下列内容保存为 alert-rules.yml,再把该文件加入 Prometheus 的 rule_files。
groups:
  - name: host-capacity
    rules:
      - alert: HostDown
        expr: up{job="node"} == 0
        for: 2m
        labels:
          severity: critical
          runbook: host-down

      - alert: RootDiskFreeLow
        expr: node_filesystem_avail_bytes{job="node",mountpoint="/",fstype!~"tmpfs|overlay"} / node_filesystem_size_bytes{job="node",mountpoint="/",fstype!~"tmpfs|overlay"} < 0.15
        for: 15m
        labels:
          severity: warning
          runbook: host-disk-space

      - alert: RootInodeFreeLow
        expr: node_filesystem_files_free{job="node",mountpoint="/"} / node_filesystem_files{job="node",mountpoint="/"} < 0.10
        for: 15m
        labels:
          severity: warning
          runbook: host-inodes

      - alert: MemoryAvailableLow
        expr: node_memory_MemAvailable_bytes{job="node"} / node_memory_MemTotal_bytes{job="node"} < 0.10
        for: 10m
        labels:
          severity: warning
          runbook: host-memory

      - alert: CpuBusyHigh
        expr: 1 - avg by (instance) (rate(node_cpu_seconds_total{job="node",mode="idle"}[5m])) > 0.90
        for: 10m
        labels:
          severity: warning
          runbook: host-cpu

      - alert: LoadPerCoreHigh
        expr: node_load15{job="node"} / on(instance) count by (instance) (node_cpu_seconds_total{job="node",mode="idle"}) > 1.5
        for: 15m
        labels:
          severity: warning
          runbook: host-load
这里把 runbook 作为稳定的排查入口标识。告警平台收到事件后,可以按该值跳到对应的内部运行手册;不要只写“CPU 高”而不给下一步,因为值班人员真正需要的是第一条可执行动作。
在加载前验证规则
先验证规则文件,再让 Prometheus 加载。下面的命令只有在 promtool 校验成功时才打印 rules-ok,因此适合放进变更检查流程。
promtool check rules alert-rules.yml >/dev/null 2>&1 && echo "rules-ok"预期输出:
rules-ok如果没有输出,应先直接运行 promtool check rules alert-rules.yml 查看报错行,不要继续 reload。常见问题是 YAML 缩进错误、PromQL 括号不配对或指标名拼错。
告警触发后按资源类型进入排查
磁盘空间告警先判断“哪个挂载点、增长速度多快、谁在写”;inode 告警则不要只看剩余 GB,因为大量小文件可能在空间充足时先把 inode 用完。内存告警优先看 MemAvailable,不要把 Linux 正常使用页缓存误判成内存泄漏。
CPU 与负载必须分开理解。CPU 高说明处理器忙,负载高却可能来自大量不可中断 I/O 等待;因此高负载时还要结合 vmstat 1 的运行队列与 I/O 等待、pidstat 1 的进程级消耗判断瓶颈位置。主机不可达则先排除监控链路故障,再判断是否真的是主机宕机。
阈值真正可用的标志不是“从此不再报警”,而是每次告警都代表持续风险,并且接手的人能从告警名称直接进入正确的第一排查路径。