
Linux 与服务器运维 / 系统课时
排查内存压力与 OOM 终止
排查内存压力与 OOM 终止
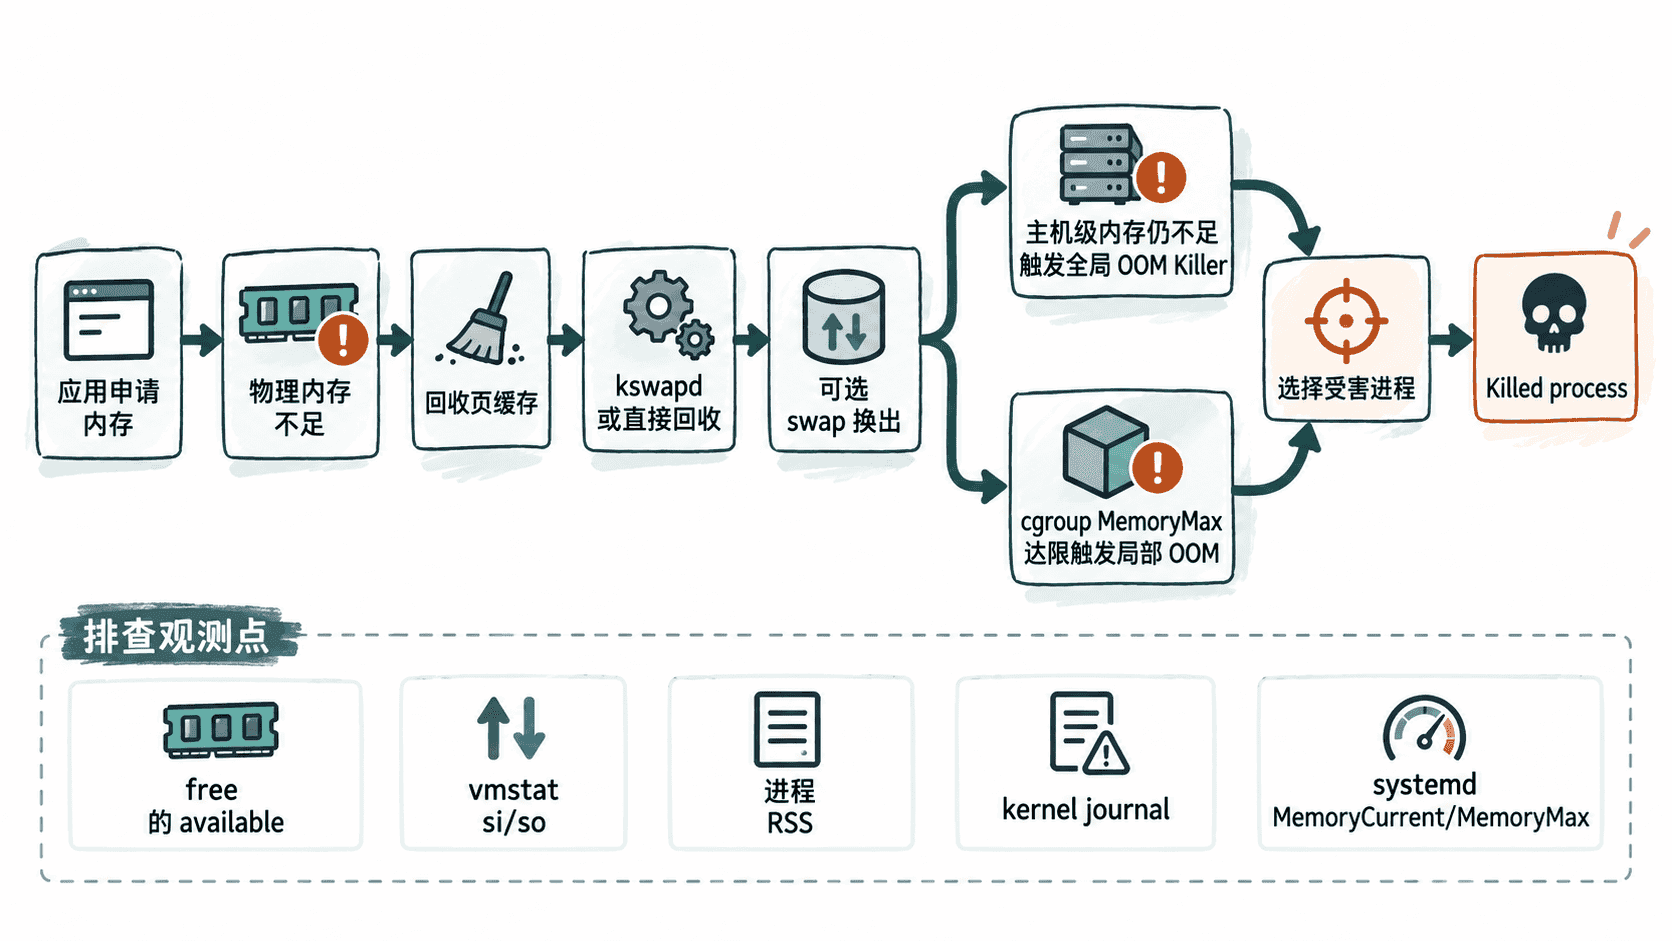
内存告警最容易被“free 很少”误导。正确方法是先看可用内存和回收行为,再观察 swap 与进程 RSS,最后用内核日志确认 OOM 是否发生以及谁被终止,并进一步区分缓存占用、持续泄漏和 cgroup 或服务资源限制。
学习目标
- 能用
free、vmstat和进程 RSS 判断主机是否处于真实内存压力 - 能从内核日志识别 OOM Killer 的触发与受害进程
- 能区分缓存可回收、持续内存增长与资源限制导致的 OOM
先判断是真紧张还是缓存很多
Linux 会尽量利用空闲内存做页缓存,所以 free 列很小并不代表马上 OOM。优先看 available:它估算在不明显触发 swap 的前提下还能提供给新进程的内存。
执行一组连续诊断:
free -h
vmstat 1 5
ps -eo pid,comm,rss,vsz,%mem --sort=-rss | head
journalctl -k -g 'Out of memory|oom-kill|Killed process' -n 20 --no-pager
预期输出会因主机状态不同而变化,重点关注这些字段:
               total        used        free      shared  buff/cache   available
Mem:           <MEM>        <MEM>       <MEM>       <MEM>       <MEM>       <MEM>
Swap:          <MEM>        <MEM>       <MEM>

procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
 <R> <B> <...>  <...>  <...>  <...> <SI> <SO> <...> <...> <...> <...> <...>

    PID COMMAND           RSS    VSZ %MEM
   <ID> <COMMAND>      <RSS>  <VSZ> <MEM>

<TIME> kernel: Out of memory: Killed process <ID> (<COMMAND>) ...
如果 available 仍充足、buff/cache 很大且系统没有持续换页,通常只是缓存利用积极;如果 available 长时间很低,si、so 持续出现,进程分配开始变慢,才是更明确的内存压力信号。
观察压力是瞬时还是持续增长
vmstat 的 si 和 so 分别表示从 swap 换入和换出。偶发非零并不一定是故障,但持续换页并伴随延迟抖动说明物理内存不足,系统正在用磁盘换时间。
进程级要看 RSS 的趋势,而不是只看某一次排名。一个服务的 RSS 随请求量上升后能够回落,可能是正常缓存;如果业务负载稳定而 RSS 持续单调增长,且回收后仍不下降,更像泄漏、无界缓存或队列堆积。此时应结合应用运行时的 heap、arena、对象或缓存指标继续定位。
从内核日志确认谁触发了 OOM
OOM Killer 的日志比“进程突然消失”更可靠。日志中的 Killed process 指出受害进程,但受害者不一定就是最早制造压力的进程;内核会综合 oom_score 等因素选择回收收益较高的目标。
若日志同时出现 oom_memcg、memory cgroup 等信息,要优先怀疑容器、systemd 单元或其他 cgroup 的内存上限。此时主机可能还有大量空闲内存,但该服务自己的配额已经耗尽。
检查服务级资源限制
对 systemd 管理的服务,把 <UNIT> 替换成实际单元名,例如 myapp.service:
systemctl show <UNIT> -p MemoryCurrent -p MemoryMax -p MemorySwapMax预期结果类似:
MemoryCurrent=<BYTES>
MemoryMax=<BYTES>
MemorySwapMax=<BYTES>
MemoryMax 若是一个明确的有限值,而 MemoryCurrent 长期逼近它,就要把“主机内存不足”和“服务配额不足”分开处理。若 MemoryMax=infinity,则该单元没有通过这个属性设置硬上限。
按根因选择修复方式
缓存占用高但 available 充足时通常不需要手工清缓存,强制清理只会让后续 I/O 更慢。真正应处理的是导致工作集过大的应用、查询或批任务。
持续泄漏或无界增长要修应用本身,同时给缓存、队列、连接或批次设置可控上限。单纯加内存只能延后故障,并不能消除增长趋势。
资源限制过小则应在确认服务真实工作集后调整 cgroup、systemd 或容器限制,并保留安全余量。若主机总体容量确实不足,还应同时评估 swap 策略、并发度和同机服务密度,而不是只提高某一个进程的上限。
修复后验证恢复是否稳定
验收至少要同时满足三个条件:available 不再持续下探,si、so 不再长时间活跃,内核日志没有新的 OOM 记录。对曾被限制的服务,还应确认 MemoryCurrent 与 MemoryMax 留有稳定余量;对疑似泄漏的进程,则必须观察一段完整业务周期,确认 RSS 不再无界增长。