
API 设计 / 系统课时
完成生产性能治理综合实践
完成生产性能治理综合实践
这次实践把前面的 Schema、Resolver、N+1、查询成本、缓存、压测和可观测性收束成一次生产验收。你要得到的不是“某个优化有效”,而是一组可重复执行的门槛:正常流量能达标,异常查询被提前拦截,故障发生时能快速定位到具体层级。
学习目标
- 把 Schema、Resolver、数据访问、缓存和资源保护串成可验收链路。
- 用真实操作分布建立延迟、错误率和吞吐回归门槛。
- 通过指标、日志和追踪完成一次受控故障定位。
定义综合验收目标
先选一个真实高频操作作为主链路,例如商品列表同时读取价格、库存和评价摘要。不要用“Hello World”压测,它无法暴露跨 Subgraph 扇出、DataLoader 批量、缓存键和数据库索引问题。验收数据集也要固定,否则每次结果不可比较。
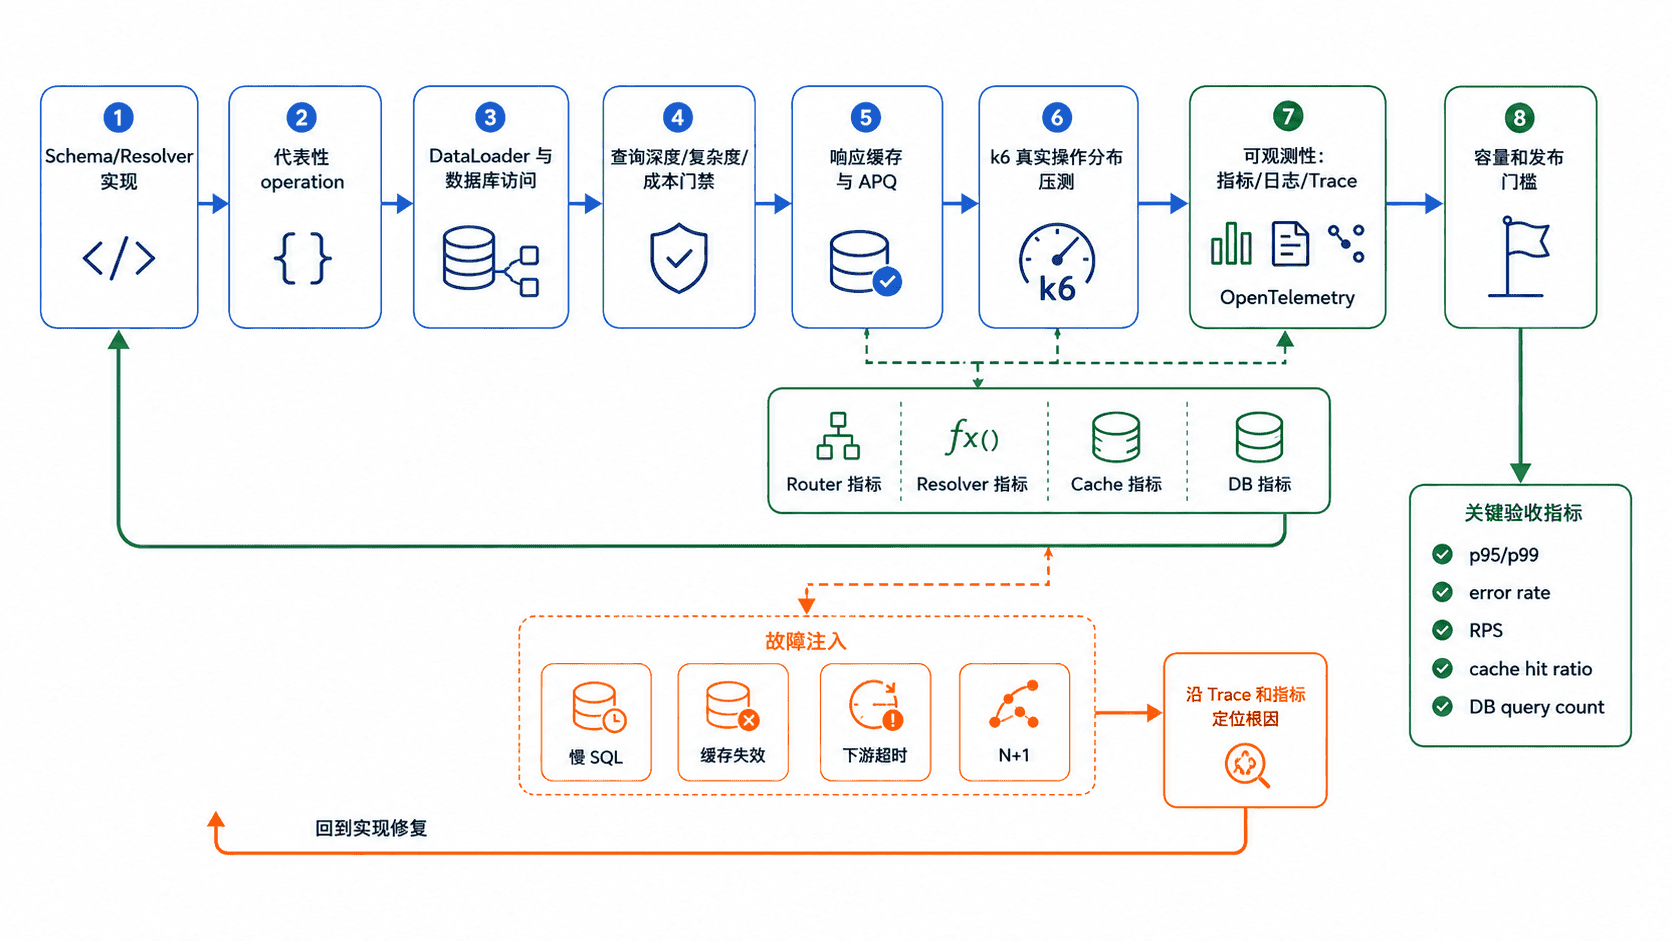
可以把验收项分成七个关口:Schema 可组合且无意外 breaking change;代表性 Resolver 正确;列表场景没有随条数线性增长的 SQL;超成本操作在执行前被拒绝;缓存身份和授权域隔离正确;固定负载下性能达标;最后必须能用观测证据解释一次故障。
先把正确性和数据访问做稳
从代表性 operation 反推 Schema 和 Resolver。对列表字段记录父级返回数量、Resolver 调用次数和数据库查询次数;修复 N+1 后,查询次数应主要由“批次数”决定,而不是由列表元素数量决定。DataLoader 必须请求级创建,写操作后要清理或更新同请求缓存,避免读到旧值。
对数据库再检查两个边界:排序和 cursor 条件是否命中稳定复合索引;GraphQL 未选择的大字段是否仍被数据库读取。性能治理不能只盯 Resolver 计时,如果 SQL 仍全表扫描或读取大对象,应用层批量化也救不了尾延迟。
然后验证错误语义。参数非法、无权限、资源不存在和下游失败应能区分;非空字段产生错误时,要确认 Null Bubbling 范围与客户端预期一致。只有功能结果稳定,后面的性能数字才有比较意义。
验证成本门禁和缓存边界
查询保护应发生在昂贵 Resolver 执行之前。准备一个明显超深或超复杂的测试 operation,确认它被深度、复杂度或静态成本规则拒绝,同时追踪中不应出现真实数据库和下游调用。若请求先打到数据库再被限流,门禁位置就是错的。
缓存验收要同时覆盖“命中”和“隔离”。相同 operation signature、规范化 variables 与相同 auth scope 才能共享响应;不同用户、租户或权限域不能因为 query 文本相同而共用私有数据。Mutation 或后台数据变更后,还要验证相关 tag 或实体失效会让下一次读取重新计算。
用压测建立自动回归门槛
压测脚本应复用生产中的代表性操作和变量分布。下面给出一个可直接运行的 k6 主示例,默认以 20 个虚拟用户持续 30 秒,并把 p95、p99、请求失败率和 GraphQL 业务检查一起纳入阈值。示例阈值只是起点,应替换成你自己的 SLO。
import http from 'k6/http';
import { check, sleep } from 'k6';

// 阈值应来自团队 SLO;这里给出可运行的示例门槛。
export const options = {
  scenarios: {
    steady: {
      executor: 'constant-vus',
      vus: 20,
      duration: '30s',
    },
  },
  thresholds: {
    http_req_duration: ['p(95)<300', 'p(99)<800'],
    http_req_failed: ['rate<0.01'],
    checks: ['rate>0.99'],
  },
};

// 使用固定代表性 operation,避免压测结果被请求形态变化污染。
const query = `
  query ProductList($first: Int!) {
    products(first: $first) {
      nodes {
        id
        name
        price
      }
    }
  }
`;

export default function () {
  const response = http.post(
    `${__ENV.BASE_URL}/graphql`,
    JSON.stringify({ query, variables: { first: 20 } }),
    { headers: { 'Content-Type': 'application/json' } },
  );

  let body = {};
  try {
    body = response.json();
  } catch (_) {
    body = {};
  }

  // GraphQL 即使返回 HTTP 200 也可能携带 errors,因此要双重检查。
  check(response, {
    'HTTP 200': (r) => r.status === 200,
    'GraphQL 无 errors': () => !body.errors,
    '返回 products': () => Boolean(body.data && body.data.products),
  });

  sleep(0.2);
}
保存为 perf.js 后执行;把 <PORT> 替换为测试环境实际端口。
# 替换 <PORT> 后对固定测试环境执行同一份脚本。
BASE_URL='http://127.0.0.1:<PORT>' k6 run perf.js
预期输出
checks.........................: <PASS_RATE>
http_req_duration..............: p(95)=<VALUE>ms p(99)=<VALUE>ms
http_req_failed................: <ERROR_RATE>
当所有阈值满足时,k6 进程应以退出码 0 结束;实际的 <PASS_RATE>、<VALUE> 和 <ERROR_RATE> 取决于环境。若阈值失败,先按 operation signature 拆分热点,再比较 Router 总耗时、Resolver 耗时、缓存命中和数据库 span,不要只凭平均响应时间猜原因。
用观测证据完成故障演练
选择非生产或专门的演练环境,注入一种明确故障,例如让某个下游延迟增加。然后从客户端失败开始反向定位:请求日志先确认 requestId、operationName、operationSignature 与错误类别;Trace 再确认时间消耗在 Router 查询计划、具体 Subgraph、Resolver、数据库还是 HTTP 上游;最后用指标判断它是单请求慢,还是已经造成并发槽、连接池或 CPU 饱和。
不同根因应留下不同证据。N+1 会表现为同一 trace 下大量形状相同的 DB span;缓存失效会同时出现 hit ratio 下降和下游调用放大;慢 SQL 通常集中在少数数据库 span;上游超时则会在对应 HTTP span 接近超时预算。定位必须能用这些证据闭环,而不是只说“接口变慢了”。
故障修复后重新执行同一压测脚本,并比较修复前后的 p95、p99、错误率、数据库查询数和资源利用率。只有同样输入下恢复门槛,才能证明修复有效。
最终把人工判断改造成发布条件:composition 检查通过;核心 operation 的功能测试通过;N+1 查询数不回退;超成本请求能在 Resolver 前拒绝;缓存隔离测试通过;k6 阈值通过;日志、指标与 Trace 能互相定位;故障演练能在规定时间内找到根因。
这组门槛应进入 CI/CD 或发布清单,并保留本次基线数据。以后每次 Schema、Router、Resolver、数据库索引或缓存策略变化,都用同一套 operation mix 重跑。性能治理真正完成的标志,是团队可以用证据判断“能不能发布”和“为什么变慢”,而不是依赖某个人的经验。