
API 设计 / 系统课时
设计服务端响应缓存
设计服务端响应缓存
服务端响应缓存的难点不是“把 JSON 存起来”,而是确定哪些请求可以共享、缓存键必须包含什么,以及数据变化后如何准确失效。本课用一个可运行示例把身份、变量、TTL 与标签失效连成完整闭环。
学习目标
- 能按操作、变量与身份作用域设计安全的响应缓存键
- 能区分可共享响应与必须隔离的个性化响应
- 能用 TTL 与标签失效共同控制陈旧数据风险
先确定响应能否共享
GraphQL 的一个 HTTP 入口可以承载大量语义完全不同的操作,因此不能只按 /graphql 路径缓存。判断响应是否可复用时,至少要同时看 操作身份、变量、认证作用域和失效边界。
匿名、只读、对所有用户结果一致的查询最适合共享缓存。带用户偏好、权限裁剪、租户数据或实验分组的查询,即使查询文本相同,也必须进入不同作用域;如果无法证明两个请求能安全共享,就按更窄的作用域缓存,甚至直接跳过响应缓存。
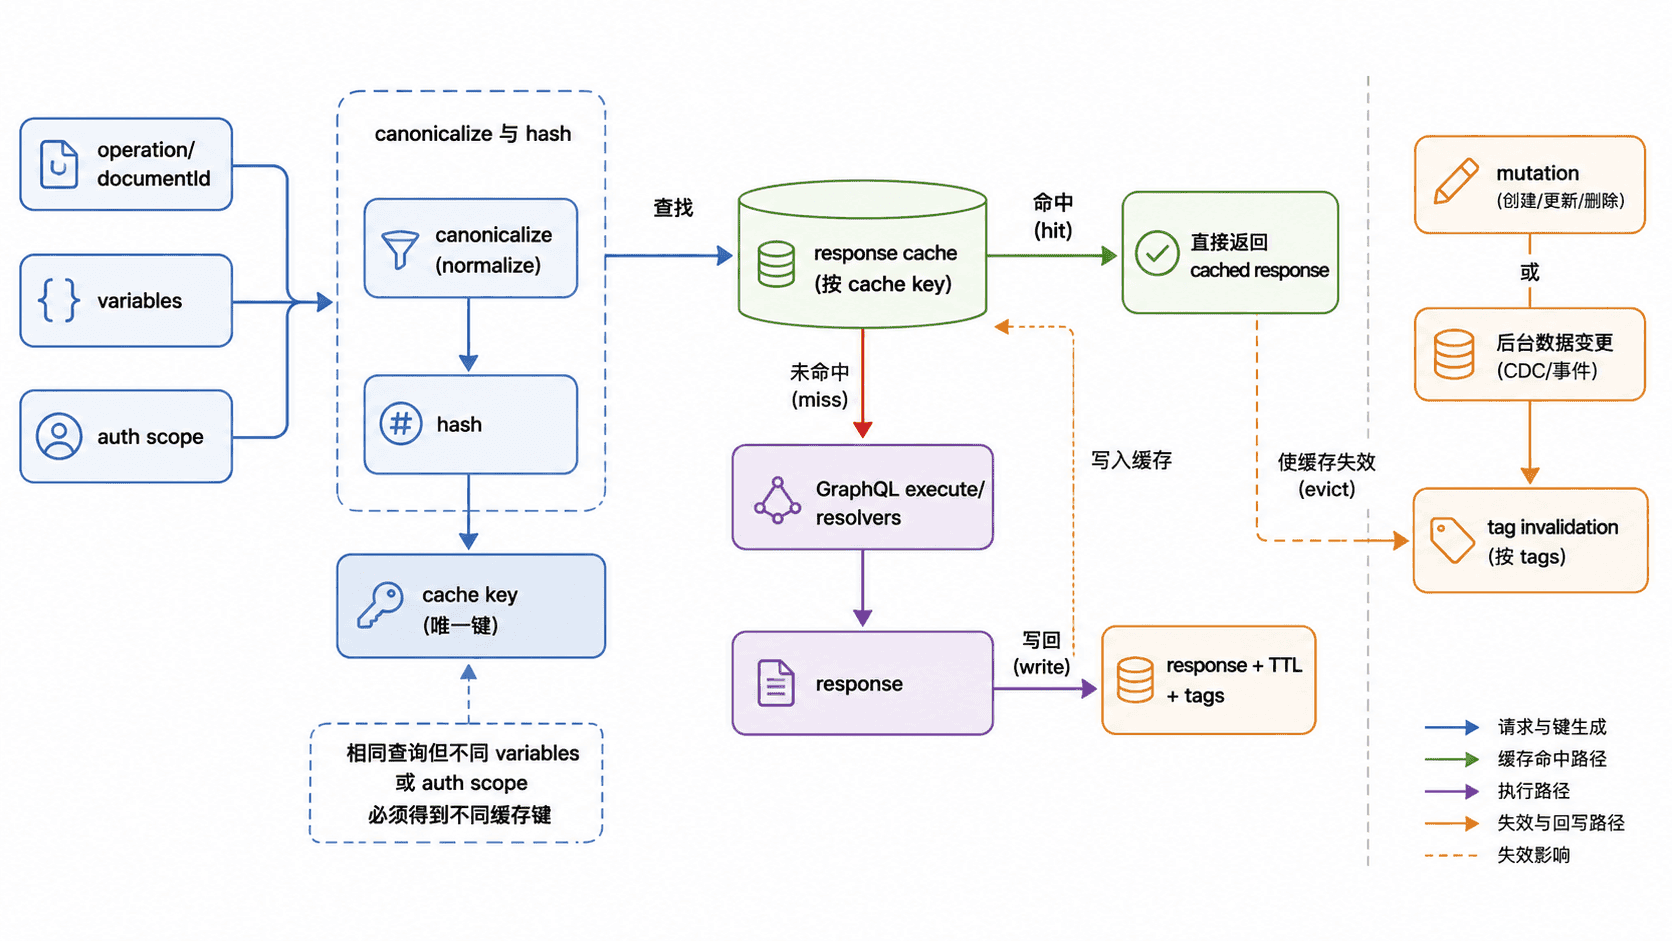
让缓存键表达完整请求语义
生产环境通常优先使用持久化操作 ID 或规范化后的文档哈希作为“操作身份”,再把变量做稳定序列化。对象变量的键顺序不能影响最终缓存键,否则 {a:1,b:2} 与 {b:2,a:1} 会产生无意义的重复缓存。
下面的示例实现了稳定变量序列化、作用域隔离、TTL 和标签失效。保存为 cache-demo.mjs 后执行 node cache-demo.mjs。
import { createHash } from "node:crypto";

const cache = new Map();
let executions = 0;

function stable(value) {
  if (Array.isArray(value)) return `[${value.map(stable).join(",")}]`;
  if (value && typeof value === "object") {
    return `{${Object.keys(value).sort().map(
      (key) => `${JSON.stringify(key)}:${stable(value[key])}`
    ).join(",")}}`;
  }
  return JSON.stringify(value);
}

function cacheKey({ documentId, operationName, variables, scope }) {
  const raw = [documentId, operationName, stable(variables), scope].join("|");
  return createHash("sha256").update(raw).digest("hex");
}

async function getOrCompute(input, { ttlMs, tags }, compute) {
  const key = cacheKey(input);
  const hit = cache.get(key);

  if (hit && hit.expiresAt > Date.now()) {
    return { source: "HIT", value: hit.value };
  }

  const value = await compute();
  cache.set(key, { value, expiresAt: Date.now() + ttlMs, tags: new Set(tags) });
  return { source: "MISS", value };
}

function invalidateTag(tag) {
  for (const [key, entry] of cache) {
    if (entry.tags.has(tag)) cache.delete(key);
  }
}

const request = {
  documentId: "sha256:product-query-v1",
  operationName: "Product",
  variables: { id: "p-42" },
  scope: "tenant:t1:role:member"
};

const loadProduct = async () => ({ id: "p-42", revision: ++executions });

console.log(JSON.stringify(await getOrCompute(request, { ttlMs: 60_000, tags: ["product:p-42"] }, loadProduct)));
console.log(JSON.stringify(await getOrCompute(request, { ttlMs: 60_000, tags: ["product:p-42"] }, loadProduct)));

invalidateTag("product:p-42");

console.log(JSON.stringify(await getOrCompute(request, { ttlMs: 60_000, tags: ["product:p-42"] }, loadProduct)));
预期输出:
{"source":"MISS","value":{"id":"p-42","revision":1}}
{"source":"HIT","value":{"id":"p-42","revision":1}}
{"source":"MISS","value":{"id":"p-42","revision":2}}
这里的 revision 只是为了证明第二次请求没有重新执行数据加载,标签失效后才再次计算。真实服务中,compute 应包住 GraphQL 的执行阶段,并只对符合缓存策略的只读操作生效。
用 TTL 与主动失效控制陈旧窗口
只有 TTL 的实现简单,但它把“数据已变化”和“缓存仍有效”之间的时间完全交给过期时间决定。价格、库存、权限等变化敏感的数据,更适合在短 TTL 之外再绑定实体标签,例如 product:p-42、tenant:t1;写操作成功后立即失效相关标签。
反过来,也不要追求“每次 mutation 精确删除所有受影响查询键”。GraphQL 查询组合多、变量空间大,逐键维护依赖图成本很高。标签或版本号通常比枚举具体缓存键更稳健;对低价值数据则可以仅使用较短 TTL,接受短暂陈旧。
明确哪些响应不进入缓存
包含不可稳定复用的错误、一次性令牌、权限敏感字段或高度实时数据时,应直接绕过响应缓存。对于部分成功的 GraphQL 响应,如果 data 与 errors 同时存在,也应先定义明确策略,而不是默认缓存整个响应。
缓存命中率也不能单独作为优化目标。至少同时观察命中率、执行耗时、陈旧数据投诉和缓存占用;如果为了提高命中率而扩大共享作用域,最终可能得到更快但错误的响应。安全的缓存边界永远优先于命中率。