
API 设计 / 系统课时
定位 Resolver 延迟热点
定位 Resolver 延迟热点
当一次 GraphQL 请求变慢时,只看整次请求耗时无法判断时间花在哪个字段。本课把总延迟拆成 Resolver 依赖链、字段计时与上游调用,最终能区分串行等待、慢上游和高成本字段。
学习目标
- 用字段坐标和耗时记录定位关键 Resolver。
- 从追踪时间线识别串行等待、N+1 与慢上游。
- 建立低基数、可持续采样的 Resolver 性能观测。
从总耗时拆到关键路径
GraphQL 查询按字段树执行。父字段必须先产出对象,子字段才能继续;同一层互不依赖的查询字段通常可以并发等待。因此,请求耗时更接近“最长依赖链 + 解析、校验和网络等开销”,而不是所有 Resolver 耗时简单相加。
定位时先找关键路径:如果 Query.products 等上游列表字段很慢,先查它背后的数据库或 HTTP 调用;如果父字段很快,但大量 Product.inventory 反复出现,则更像列表扇出或 N+1;如果一个 Resolver 内部连续等待两个彼此独立的上游,则是可疑的串行瀑布。
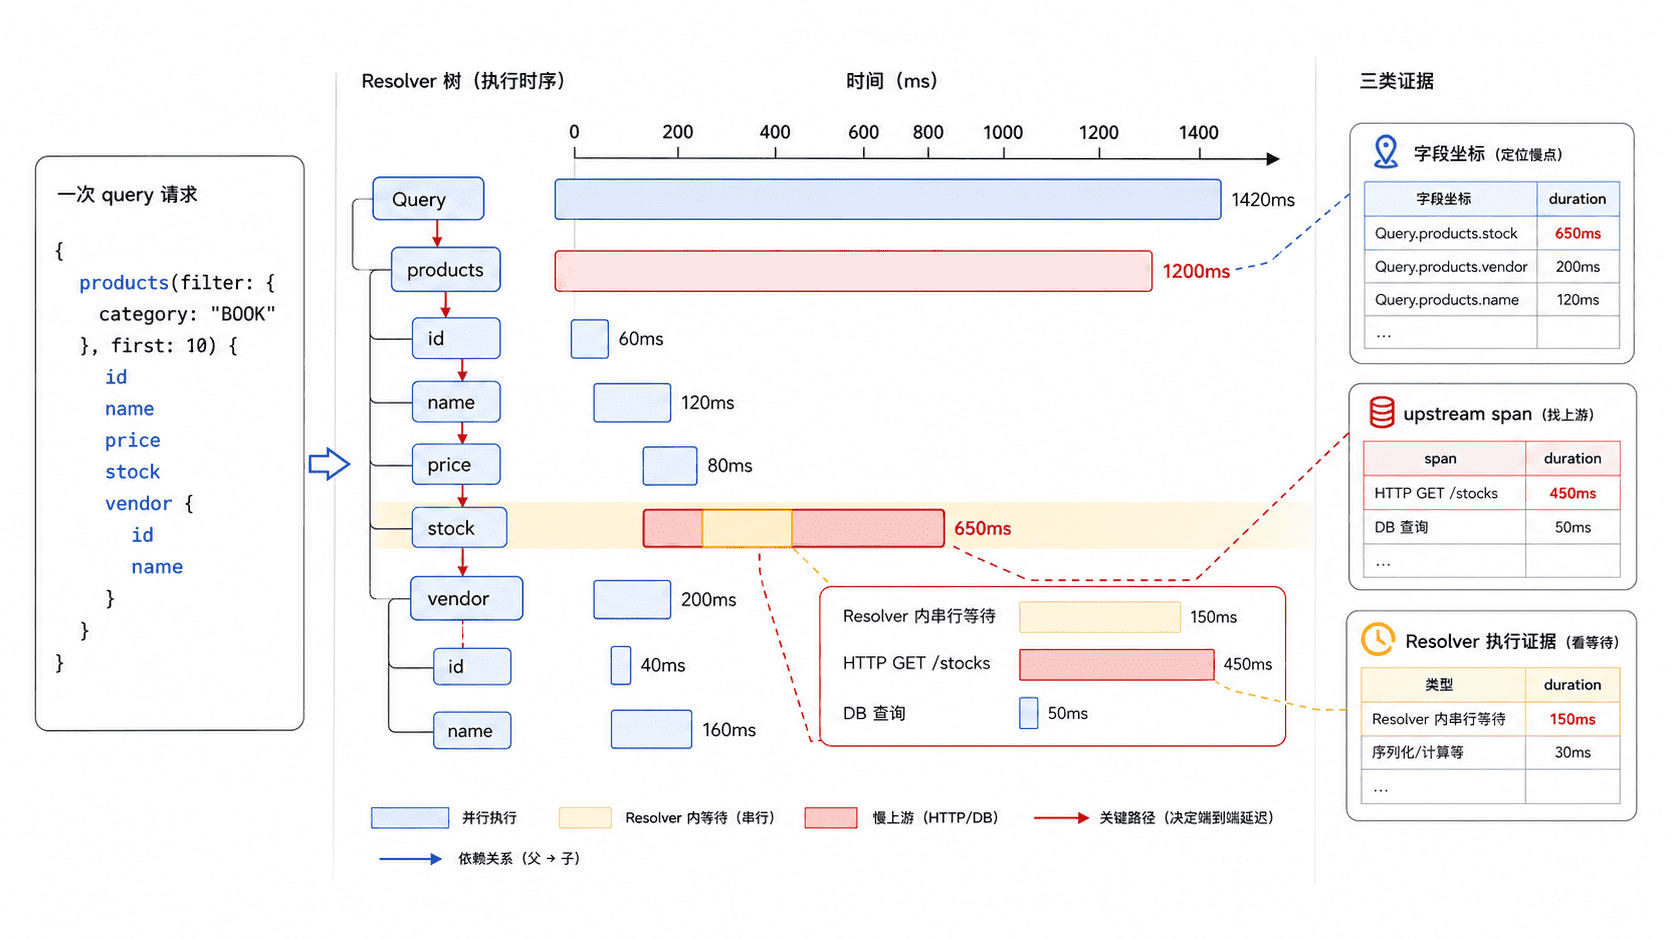
用字段计时建立最小证据
没有完整 APM 时,可以先对 Resolver 做轻量计时。字段名应记录为 父类型.字段名,例如 Product.inventory,这样同名字段不会混在一起。下面的 Node.js 示例用固定延迟模拟列表 Resolver 与慢库存上游;项目需已安装 GraphQL.js 16.x。
const { buildSchema, graphql } = require('graphql');
const { performance } = require('node:perf_hooks');

const schema = buildSchema(`
  type Product {
    id: ID!
    inventory: Int!
  }

  type Query {
    products: [Product!]!
  }
`);

const sleep = (ms) => new Promise((resolve) => setTimeout(resolve, ms));

function timed(fieldCoordinate, resolver) {
  return async (...args) => {
    const start = performance.now();
    try {
      return await resolver(...args);
    } finally {
      const durationMs = (performance.now() - start).toFixed(1);
      console.log(`[resolver] ${fieldCoordinate} durationMs=${durationMs}`);
    }
  };
}

const rootValue = {
  products: timed('Query.products', async () => {
    await sleep(40);

    return [{
      id: 'p1',
      inventory: timed('Product.inventory', async () => {
        await sleep(120);
        return 7;
      }),
    }];
  }),
};

async function main() {
  const result = await graphql({
    schema,
    source: 'query Hotspot { products { id inventory } }',
    rootValue,
  });

  console.log(JSON.stringify(result));
}

main().catch(console.error);
预期输出。实际计时会受调度影响,因此用 <TIME> 表示运行时数值。
[resolver] Query.products durationMs=<TIME>
[resolver] Product.inventory durationMs=<TIME>
{"data":{"products":[{"id":"p1","inventory":7}]}}
这里真正的热点是 Product.inventory:它只能在 Query.products 返回之后开始,并额外等待约 120 ms。若有几十个商品且每个都独立请求库存,就要继续检查这些库存调用是否重复、是否可批量,以及它们究竟并发还是排队执行。
读追踪时先找三类形态
| 追踪形态 | 更可能的根因 | 下一步证据 |
|---|---|---|
| 单个 Resolver 几乎占满关键路径 | 慢 SQL、慢 HTTP、锁等待或计算过重 | 给数据库或 HTTP 调用增加子 span,比较 Resolver 自身时间与上游时间 |
| 同一字段坐标在列表中高频重复 | N+1 或无效重复读取 | 统计每次操作的调用次数,并检查 DataLoader、批量接口或请求级缓存 |
| 一个 Resolver 内出现多个连续且互不依赖的等待 | 串行瀑布 | 核对依赖关系;无数据依赖时再考虑并发发起 |
查询的 sibling 字段通常可以并发,但 mutation 的顶层字段按规范串行执行。不要把预期的 mutation 串行误判成性能缺陷;真正要找的是“本可并行却被业务代码顺序 await”的等待。
把追踪变成低基数观测
生产环境不要把原始参数、用户 ID、商品 ID 直接做指标标签,否则时序数量会迅速膨胀。稳定维度通常只保留操作名、字段坐标、错误类别、上游服务名和发布版本;具体参数需要排障时放进受控日志或 trace 属性,并遵守脱敏规则。
追踪还要把“Resolver 自身耗时”和“上游子 span 耗时”分开。若 Resolver 120 ms 中有 115 ms 都在等待数据库,优化 JavaScript 计算几乎没有收益;若上游很快而 Resolver 自身持续占用 CPU,才应检查序列化、排序、同步计算或过度转换。
修复后验证关键路径
修复时保持操作文档、变量规模和数据集尽量一致,分别比较端到端 p95、热点字段 p95、字段调用次数与上游耗时。缓存类修复还要区分冷缓存和热缓存,避免只验证命中后的最好结果。
如果热点字段下降了,但请求 p95 没有变化,说明关键路径可能已经转移到另一个 Resolver 或网络阶段。性能治理的目标不是让某个字段“看起来更快”,而是用同一组证据确认最长依赖链真的缩短。