
API 设计 / 系统课时
实现客户端分页缓存
实现客户端分页缓存
Cursor 分页的难点不在 fetchMore,而在多页结果如何落到同一缓存字段。本文用 Apollo Client 4 的字段策略实现按分类隔离、按 cursor 追加、按实体 ID 去重,并让首屏刷新能够正确覆盖旧分页数据。
学习目标
- 用
keyArgs区分“列表身份参数”和“分页控制参数” - 编写
merge合并 cursor 分页结果并按实体 ID 去重 - 让首屏刷新覆盖旧分页数据,同时保留后续
fetchMore的追加语义
先定义缓存里什么算同一条列表
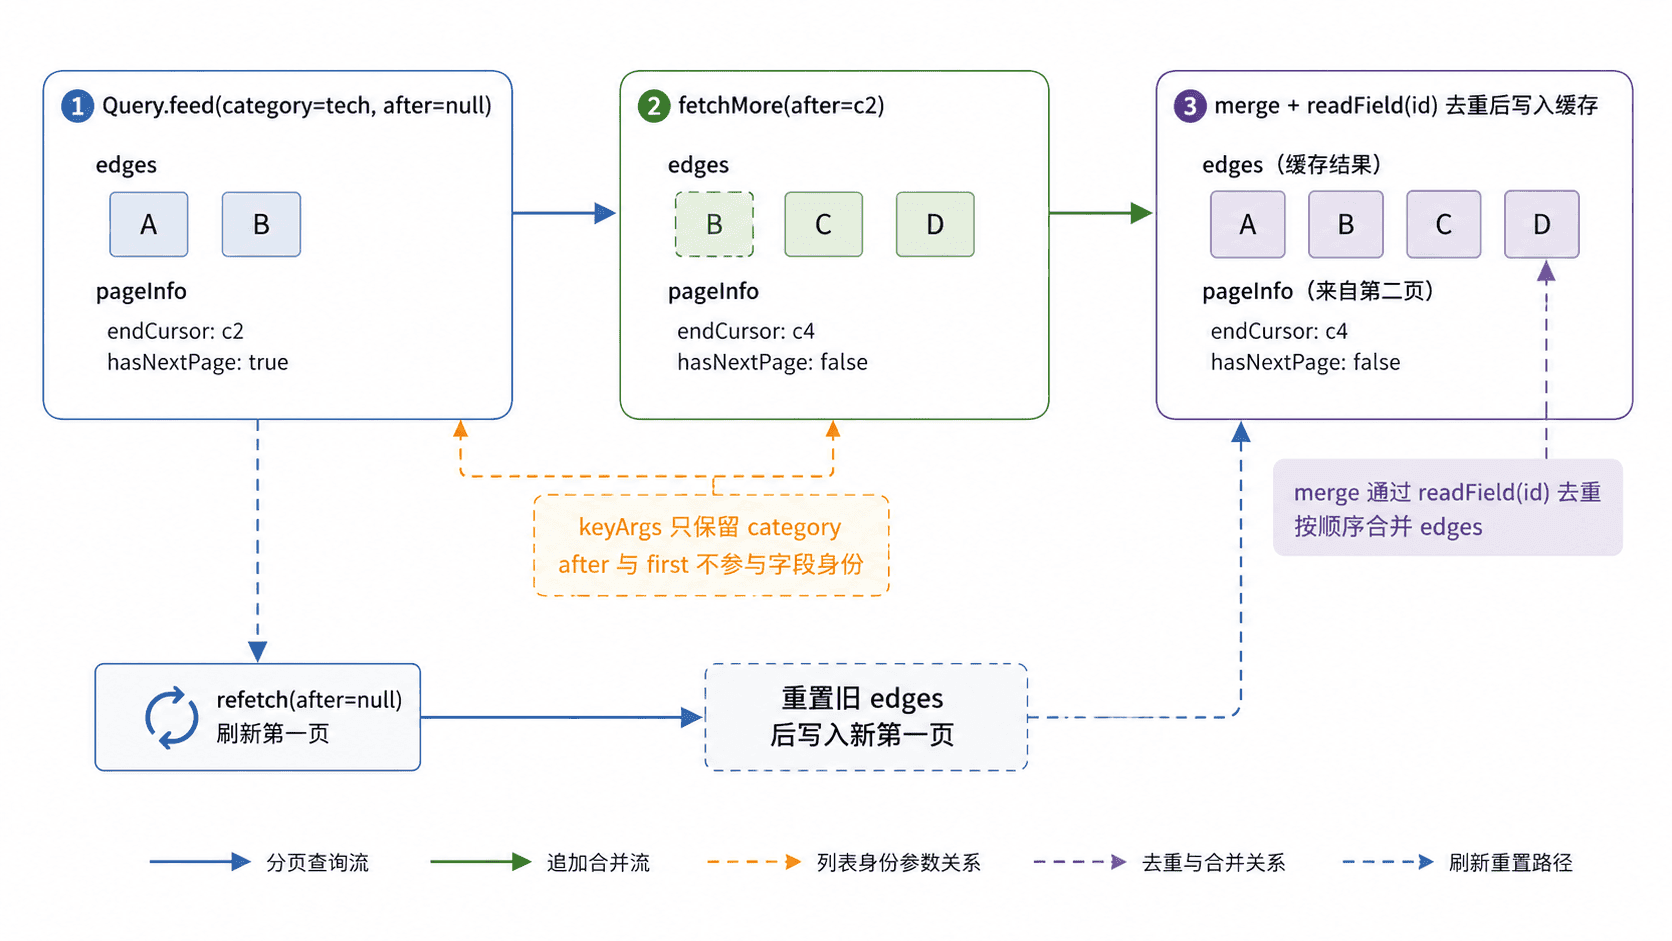
假设查询字段是 feed(category, after, first)。category 会改变“这是哪一条列表”,因此必须参与缓存键;after 和 first 只决定从同一列表取哪一页,不应该生成新的独立列表。
如果不配置字段策略,Apollo Client 默认把不同参数组合视为不同字段值。这样第一页 feed(category: "tech", after: null) 与第二页 feed(category: "tech", after: "c2") 会分别存储,组件就得自己拼页。正确做法是让缓存知道:同一 category 的不同 cursor 页面应该汇入同一个 feed 字段。
配置字段策略与 merge
下面的主示例假设 GraphQL 服务端返回标准连接结构 edges + pageInfo。merge 在 after 为空时视为首屏加载或刷新,重新建立列表;有 cursor 时才在旧结果后追加。复制数组而不是原地修改,可以避免破坏缓存对已有结果的不可变约定。
import { gql, InMemoryCache } from "@apollo/client";
import { useQuery } from "@apollo/client/react";

export const cache = new InMemoryCache({
  typePolicies: {
    Query: {
      fields: {
        feed: {
          // category 决定列表身份;after 和 first 只控制分页。
          keyArgs: ["category"],
          merge(existing, incoming, { args, readField }) {
            const isFirstPage = !args?.after;
            const mergedEdges = isFirstPage
              ? []
              : [...(existing?.edges ?? [])];

            // node 可能是 Reference,用 readField 读取 id 更稳妥。
            const seenIds = new Set(
              mergedEdges.map((edge) => readField("id", edge.node)),
            );

            for (const edge of incoming.edges) {
              const id = readField("id", edge.node);
              if (id == null || !seenIds.has(id)) {
                mergedEdges.push(edge);
                if (id != null) seenIds.add(id);
              }
            }

            return {
              ...incoming,
              edges: mergedEdges,
            };
          },
        },
      },
    },
  },
});

const FEED_QUERY = gql`
  query Feed($category: String!, $after: String, $first: Int!) {
    feed(category: $category, after: $after, first: $first) {
      edges {
        cursor
        node {
          __typename
          id
          title
        }
      }
      pageInfo {
        endCursor
        hasNextPage
      }
    }
  }
`;

export function Feed({ category }) {
  const { data, loading, fetchMore, refetch } = useQuery(FEED_QUERY, {
    variables: { category, after: null, first: 20 },
  });

  if (loading && !data) return <p>加载中…</p>;

  const feed = data?.feed;
  return (
    <section>
      <button
        type="button"
        onClick={() => refetch({ category, after: null, first: 20 })}
      >
        刷新
      </button>

      <ul>
        {feed?.edges.map(({ node }) => (
          <li key={node.id}>{node.title}</li>
        ))}
      </ul>

      {feed?.pageInfo.hasNextPage && (
        <button
          type="button"
          onClick={() =>
            fetchMore({
              variables: {
                category,
                after: feed.pageInfo.endCursor,
                first: 20,
              },
            })
          }
        >
          加载更多
        </button>
      )}
    </section>
  );
}
预期结果
首次查询:缓存保存 category 对应的第一页 edges。
加载更多:新页合并到同一 feed 字段,重复 node.id 不会再次出现。
刷新第一页:因为 after 为空,旧 edges 被新第一页替换,而不是继续追加。
不同 category:分别维护自己的分页列表,互不覆盖。
处理去重与 pageInfo
分页去重最好基于节点的规范化主键,而不是 cursor。cursor 描述分页位置,不保证等同于实体身份;同一节点可能因为数据变化或服务端分页窗口移动而再次出现。readField("id", edge.node) 同时兼容普通 StoreObject 和规范化后的 Reference,因此比直接访问 edge.node.id 更稳妥。
示例返回 { ...incoming, edges: mergedEdges },意味着 pageInfo 以最新一页为准。这样 endCursor 与 hasNextPage 始终描述下一次请求应该从哪里继续。如果接口还返回 totalCount 等聚合字段,也要明确它应该采用最新值、累加值还是服务端权威值,不能顺手与 edges 一起拼接。
刷新与筛选变化的边界
keyArgs 只应包含真正改变结果集合身份的参数,例如分类、筛选条件或排序方式。若把 after 放进 keyArgs,每页会重新分裂成独立缓存;若漏掉 category,不同分类又会被错误合并。
刷新时最容易踩的坑是沿用“永远追加”的 merge。当请求第一页且 after 为 null 或未提供时,应把它当作新的基线并替换旧 edges;后续有 cursor 的请求才执行追加。这样既能支持 fetchMore,也能让下拉刷新、筛选重载或数据失效后的重新获取得到干净结果。
分页缓存的稳定性最终取决于一条清晰规则:身份参数决定缓存分区,cursor 决定读取位置,实体 ID 决定去重,第一页请求决定是否重置。 这四个职责分开后,fetchMore、刷新和筛选切换才能共享同一套可预测的缓存行为。