
API 设计 / 系统课时
管理 DataLoader 请求级缓存
管理 DataLoader 请求级缓存
DataLoader 的缓存是单个 loader 实例内的请求级记忆化,不是 Redis 一类跨请求缓存。本节建立正确生命周期,并用“先读、再写、再读”演示 clear() 与 prime(),避免 mutation 后返回旧数据。
学习目标
- 明确 DataLoader 缓存应随一次 GraphQL 请求创建和销毁。
- 区分
clear()、clearAll()与prime()的适用时机。 - 在 mutation 写入后让同一请求中的后续字段读取到新值。
把缓存边界放在请求上
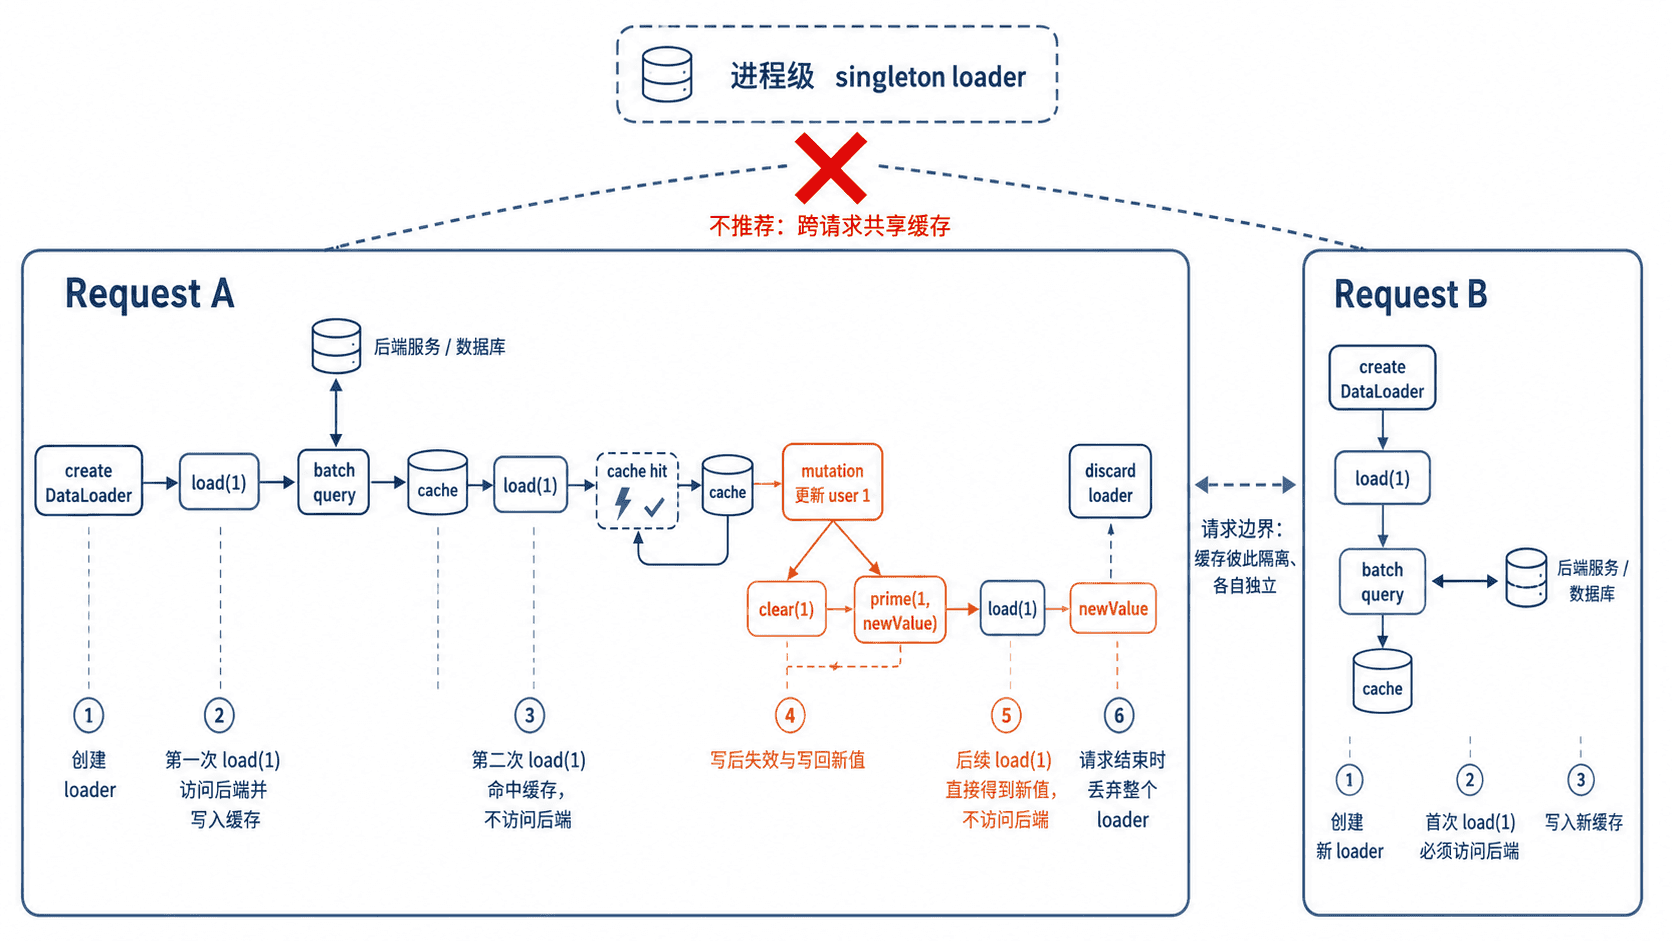
每个 DataLoader 实例都有自己的 memoization cache。同一个请求里第一次 load(1) 会触发批量函数,后续再次加载键 1 可以直接复用缓存结果;请求结束后,整个 loader 与缓存一起丢弃。
因此最稳妥的做法是在构建 GraphQL context 时创建 loaders。不要把带有用户权限、租户或请求上下文的数据 loader 做成进程级单例,否则不同请求可能复用不该共享的结果;长生命周期 loader 还会让默认 Map 持续增长。
写操作之后决定清理还是回填
如果 mutation 在同一请求里修改了某个实体,而这个实体此前已经被 loader 读取并缓存,后续字段继续 load() 就可能拿到旧值。最常见的处理是对确定受影响的键调用 clear(key)。
如果写入操作已经返回了完整且可信的新对象,可以紧接着 clear(key).prime(key, newValue),让后续读取不必再次访问数据库。prime() 默认不会覆盖已经存在的缓存项,所以想强制替换时必须先 clear()。
只有在一次写操作影响了大量且无法准确枚举的键时,才考虑 clearAll()。它会清掉当前 loader 的全部请求级缓存,范围比按键失效更大。
用一个请求验证写后失效
下面示例用内存 Map 代替数据库,分别模拟两个请求。第一个请求先读用户两次,再执行 mutation,并用 clear().prime() 把新对象放回缓存;第二个请求会创建新的 loader,因此仍要重新访问后端。
import DataLoader from 'dataloader';

const users = new Map([
  [1, { id: 1, name: 'Ada' }],
]);

let dbReadCount = 0;

async function batchUsers(ids) {
  dbReadCount += 1;
  console.log(`[db read #${dbReadCount}] ids=${ids.join(',')}`);
  return ids.map((id) => users.get(id) ?? null);
}

function createRequestContext() {
  // 每次请求创建新实例,缓存不会跨请求共享。
  return {
    loaders: {
      users: new DataLoader(batchUsers),
    },
  };
}

async function updateUserName(context, id, name) {
  const current = users.get(id);
  const updated = { ...current, name };
  users.set(id, updated);

  // mutation 已拿到完整新对象:先失效旧值,再回填新值。
  context.loaders.users.clear(id).prime(id, updated);
  return updated;
}

const requestA = createRequestContext();

console.log('A first:', (await requestA.loaders.users.load(1)).name);
console.log('A cached:', (await requestA.loaders.users.load(1)).name);

await updateUserName(requestA, 1, 'Ada v2');

console.log('A after mutation:', (await requestA.loaders.users.load(1)).name);

const requestB = createRequestContext();
console.log('B first:', (await requestB.loaders.users.load(1)).name);
预期输出
[db read #1] ids=1
A first: Ada
A cached: Ada
A after mutation: Ada v2
[db read #2] ids=1
B first: Ada v2
输出里 Request A 的第二次读取没有新增数据库访问,mutation 后读取也因为 prime() 直接获得 Ada v2。Request B 使用新 loader,所以产生第二次后端读取,这正是请求级缓存应有的边界。
处理缓存失效的几个边界
如果 mutation 返回的只是部分字段,或者读取结果还依赖当前权限、语言、租户等条件,不要贸然把部分对象 prime() 进缓存;只做 clear(key),让下一次 load() 重新走批量函数通常更安全。
批量函数整体抛错或 Promise reject 时,DataLoader 不会把整个失败批次当成成功值缓存;但批量函数若在某个索引返回 Error,该单键错误可以被缓存。若该错误是短暂故障,应在捕获后按键 clear(),避免同一请求后续一直复用它。
关闭缓存 cache: false 也不是“更实时”的通用方案:同一个键的重复 load() 会再次进入批量函数,批次中还可能出现重复键。默认应保留请求级缓存,并把精力放在正确的请求边界和写后失效策略上。