
API 设计 / 系统课时
构建请求级 Context
构建请求级 Context
GraphQL Resolver 不应自行读取全局用户状态或临时创建请求资源。本篇把身份、数据源、日志器和请求级缓存集中到 Context,并验证同一次操作共享一个 Context、不同请求彼此隔离。
学习目标
- 说明 Context 的生命周期,以及它为什么不能承载跨请求可变状态
- 构造包含用户身份、数据源、日志器和请求级资源的 Context
- 在 Resolver 中只通过 Context 访问请求依赖,并验证请求之间不会串数据
Context 的边界
Context 是一次 GraphQL 操作执行时传给 Resolver 的共享对象。一个操作里的多个 Resolver 应看到同一个 Context;下一次请求则要创建新的 Context。Schema、数据库连接池等可长期复用的对象可以被 Context 引用,但用户身份、DataLoader、事务、追踪 Span、请求缓存等必须按请求创建或绑定。
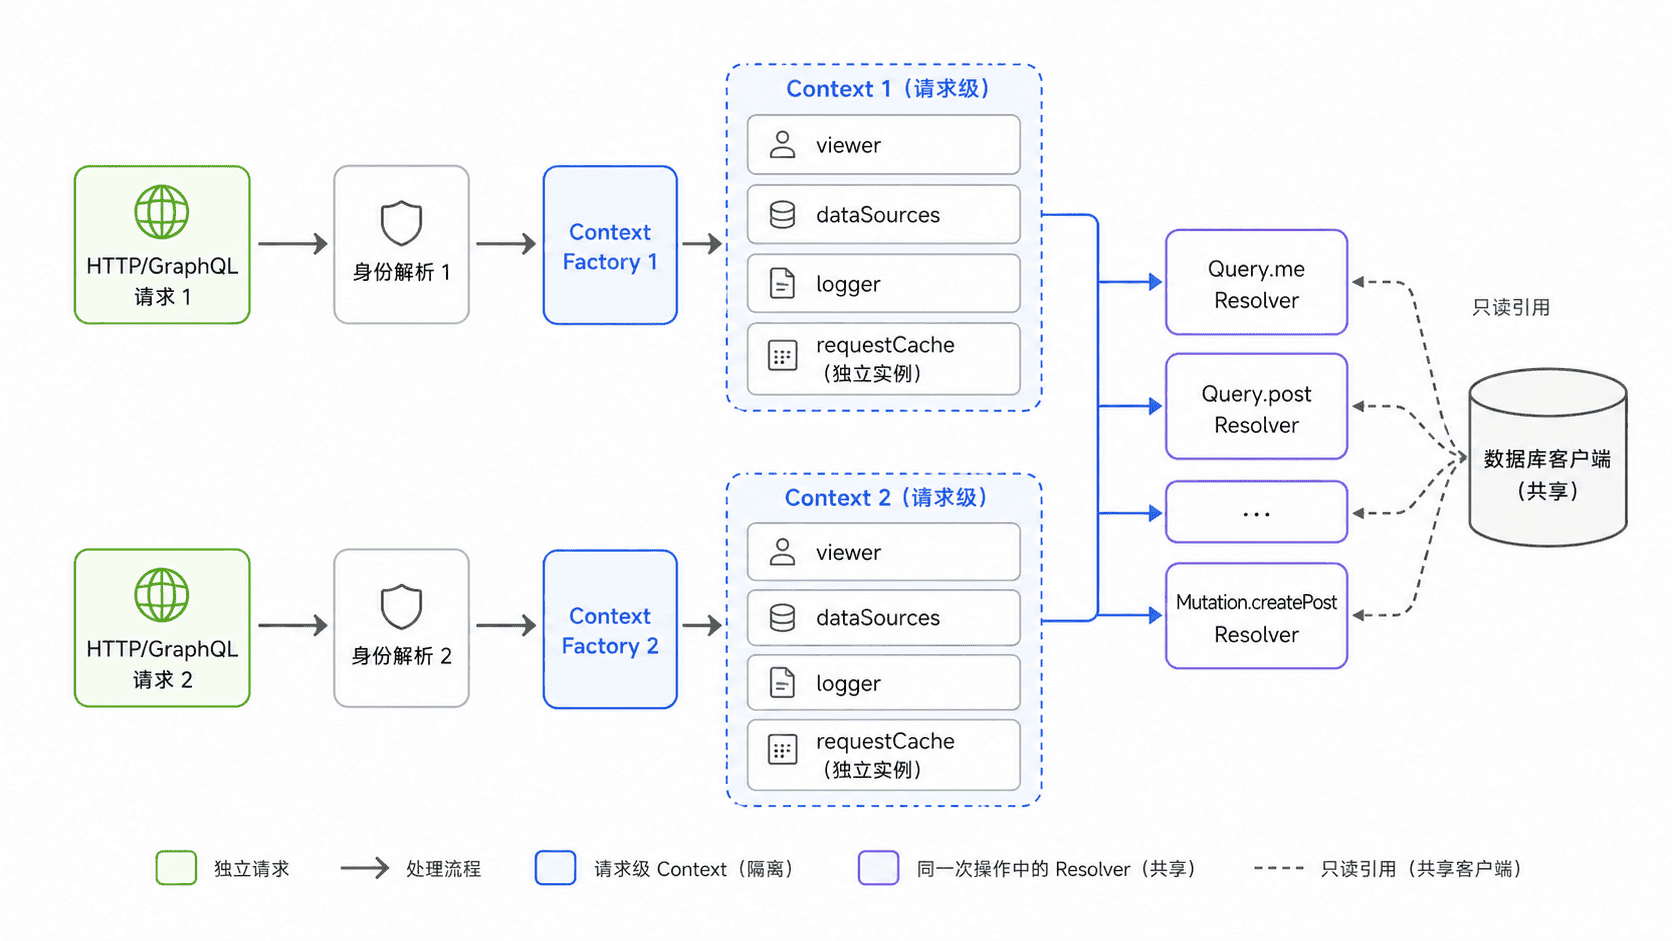
真正需要避免的是把 Context 当成“全局依赖容器”。如果把当前用户或请求缓存放到模块级变量,并发请求就可能互相覆盖。相反,长期资源负责复用连接,请求级对象负责隔离状态,这两个生命周期应明确分开。
构造并使用 Context
下面的完整示例使用 GraphQL.js。假设当前 Node.js ESM 项目已经安装 graphql 包;两个模拟请求分别以不同 Bearer Token 创建 Context。dataSources 引用可复用的数据访问对象,而 requestCache 和日志事件数组每次都会重新创建。
import { buildSchema, graphql } from "graphql";

const schema = buildSchema(`
  type User { id: ID!, name: String! }
  type Post { id: ID!, title: String! }
  type Query {
    me: User!
    post(id: ID!): Post
  }
`);

const users = new Map([
  ["u1", { id: "u1", name: "Alice" }],
  ["u2", { id: "u2", name: "Bob" }],
]);
const posts = new Map([
  ["p1", { id: "p1", title: "Request Context" }],
]);

// 长生命周期对象可以复用,但不要在这里保存“当前用户”等请求状态。
const dataSources = {
  users: { findById: (id) => users.get(id) ?? null },
  posts: { findById: (id) => posts.get(id) ?? null },
};

let requestSequence = 0;

function authenticate(authHeader) {
  const token = authHeader.replace(/^Bearer\s+/, "");
  if (token === "alice-token") return { id: "u1" };
  if (token === "bob-token") return { id: "u2" };
  throw new Error("UNAUTHENTICATED");
}

function createContext(authHeader) {
  const requestId = `req-${++requestSequence}`;
  const events = [];

  return {
    requestId,
    viewer: authenticate(authHeader),
    dataSources,
    logger: { info: (message) => events.push(message) },
    events,
    requestCache: new Map(),
  };
}

function loadPost(context, id) {
  if (context.requestCache.has(id)) {
    context.logger.info(`post:${id}:cache-hit`);
    return context.requestCache.get(id);
  }

  context.logger.info(`post:${id}:db-read`);
  const post = context.dataSources.posts.findById(id);
  context.requestCache.set(id, post);
  return post;
}

const rootValue = {
  me(_args, context) {
    context.logger.info("Query.me");
    return context.dataSources.users.findById(context.viewer.id);
  },
  post({ id }, context) {
    return loadPost(context, id);
  },
};

async function executeRequest(authHeader) {
  const contextValue = createContext(authHeader);
  const result = await graphql({
    schema,
    source: `{
      me { id name }
      first: post(id: "p1") { id title }
      second: post(id: "p1") { id title }
    }`,
    rootValue,
    contextValue,
  });

  return {
    requestId: contextValue.requestId,
    cacheEntries: contextValue.requestCache.size,
    logs: [...contextValue.events].sort(),
    data: result.data,
  };
}

console.log(JSON.stringify(await executeRequest("Bearer alice-token")));
console.log(JSON.stringify(await executeRequest("Bearer bob-token")));
预期输出
{"requestId":"req-1","cacheEntries":1,"logs":["Query.me","post:p1:cache-hit","post:p1:db-read"],"data":{"me":{"id":"u1","name":"Alice"},"first":{"id":"p1","title":"Request Context"},"second":{"id":"p1","title":"Request Context"}}}
{"requestId":"req-2","cacheEntries":1,"logs":["Query.me","post:p1:cache-hit","post:p1:db-read"],"data":{"me":{"id":"u2","name":"Bob"},"first":{"id":"p1","title":"Request Context"},"second":{"id":"p1","title":"Request Context"}}}
两个请求都只读取一次 p1,说明一次操作内共享请求缓存;第二个请求仍然重新发生一次数据库读取,说明缓存没有跨请求泄漏。真实服务通常会把 requestId 换成 UUID 或网关传入的追踪 ID,因此实际值可能不同。
放什么进 Context
Context 适合放“Resolver 需要、且与本次请求有关”的能力或信息。用户身份应来自可信的认证结果,而不是直接相信客户端传入的用户 ID;日志器应预先绑定请求 ID;DataLoader、请求缓存和事务要按请求创建,避免批处理结果或事务状态跨用户复用。
数据库连接池、HTTP Client、静态配置这类线程安全或并发安全的长生命周期对象不必每次重建,可以由 Context 持有引用。反过来,也不要在每个 Resolver 中创建新的 DataLoader 或事务,否则同一请求内部无法共享批处理、缓存和提交边界。
处理创建失败与清理
认证失败最好在创建 Context 时尽早终止,这样后续 Resolver 不会拿到半初始化状态。若 Context 绑定了需要释放的资源,例如请求级事务或追踪 Span,应由承载 GraphQL 的服务器框架在操作完成或异常结束时统一提交、回滚或关闭,而不是把清理逻辑分散到各个 Resolver。
稳定的做法是:长期资源在进程级复用,请求状态在 Context 工厂中创建,Resolver 只消费 Context。这样既能保持依赖清晰,也能把用户隔离、日志关联和请求级缓存放在同一个生命周期边界内。