
API 设计 / 系统课时
优化数据库字段投影
优化数据库字段投影
GraphQL 允许客户端只声明需要的字段,但如果 Resolver 仍执行 SELECT *、无条件读取大字段或提前联表,网络层的“按需查询”就没有真正落到数据库。本节把选择集转换为受控字段投影,并保留领域边界与必要列。
学习目标
- 根据当前对象的 GraphQL 选择集缩小数据库列集合。
- 用字段白名单、必要列和领域边界避免错误投影与过度联表。
- 通过查询日志、执行计划和响应验证投影优化是否生效。
从选择集决定当前对象的读取范围
字段投影的核心不是把 GraphQL 字段名直接拼进 SQL,而是先判断“这个 Resolver 为当前对象负责哪些字段”。例如客户端请求 user { id name } 时,用户表只需要身份列和名称列;如果还请求 posts,文章关系通常应交给对应字段 Resolver 或批量加载器处理,而不是仅因为出现嵌套选择就立即 JOIN posts。
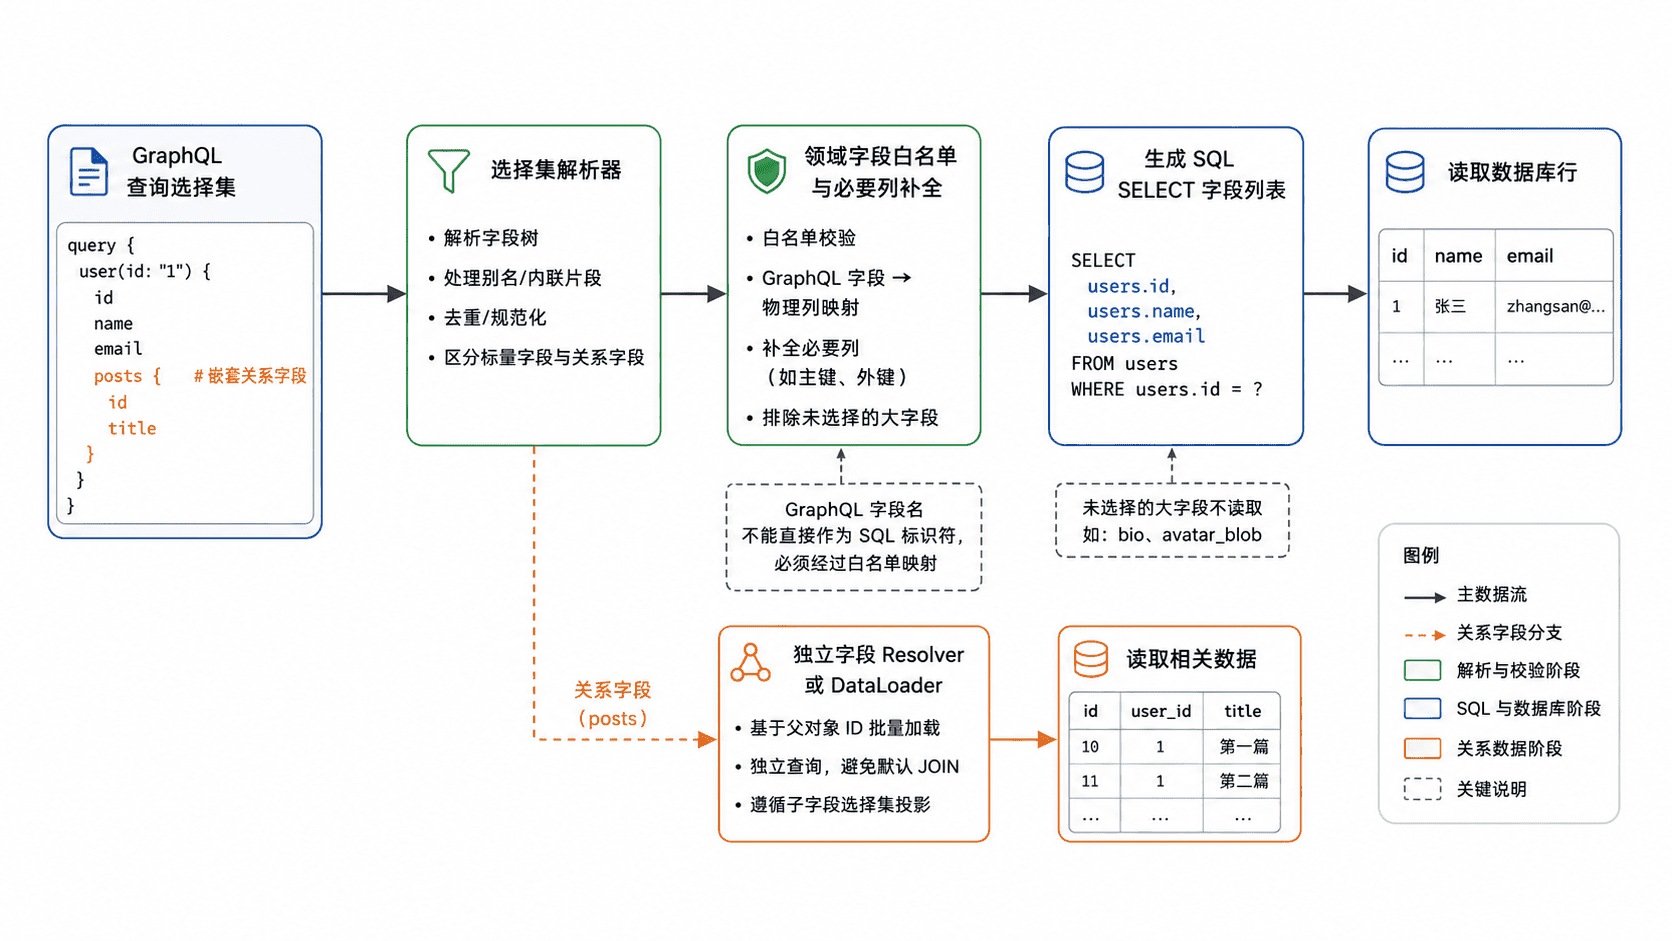
这种边界能同时避免两类浪费:一类是 SELECT * 带来的宽行、TOAST/LOB 读取和额外网络传输;另一类是为了“可能会用到”而提前加载的一对多关联。GraphQL 负责声明响应形状,数据层仍应决定哪些列属于当前实体、哪些字段需要另一次批量读取。
用白名单生成安全投影
下面的 JavaScript 主示例模拟 Resolver 已经从 GraphQL AST 中取得当前对象的字段名。示例只允许预定义字段映射到数据库列,并始终补上实体主键;实际项目中应使用框架提供的选择集工具或正确遍历 AST、fragment 与 directive,不要靠字符串截取查询文本。
const fieldToColumn = {
  id: "id",
  name: "display_name",
  email: "email",
  bio: "bio"
};

function buildUserProjection(selectedFields) {
  // 主键即使不回传,也常用于实体标识、批量加载或后续授权判断。
  const columns = new Set(["id"]);

  for (const field of selectedFields) {
    const column = fieldToColumn[field];
    if (column) columns.add(column);
  }

  return `SELECT ${[...columns].join(", ")} FROM users WHERE id = $1`;
}

console.log(buildUserProjection(["id", "name"]));
console.log(buildUserProjection(["id", "name", "bio"]));
预期输出:
SELECT id, display_name FROM users WHERE id = $1
SELECT id, display_name, bio FROM users WHERE id = $1
这里的白名单不仅用于安全,也用于表达领域映射:GraphQL 的 name 可以对应数据库的 display_name,而未知字段不会进入 SQL。不要把客户端提供的字段名直接插入 SELECT,否则既可能产生非法列,也会把数据层结构暴露给接口层。
保留必要列并延迟关联与大对象
投影不能只看“最终是否返回”。授权、租户隔离、排序、数据加载键和计算字段都可能依赖额外列。例如响应不返回 tenant_id,但行级授权需要它,就必须把它加入内部必要列;计算 avatarUrl 需要 avatar_key 时,也应读取依赖列而不是假设字段一一对应。
关联字段要按基数和访问模式处理。一对多关系通常由 DataLoader 或数据层批量查询解决 N+1;只有在一对一关系、筛选条件或排序确实需要时才考虑联表。text、jsonb、二进制对象或大段富文本应默认延迟读取,只有选择集需要时才加入投影,避免窄响应背后仍发生宽行 I/O。
验证是否减少了真实数据访问
验证时不要只看 GraphQL 响应变小。应同时检查数据库侧证据:查询日志中的 SELECT 列是否收窄,执行计划是否减少宽行读取或不必要关联,应用指标中的数据库字节数与延迟是否下降。对于 PostgreSQL,还要留意大字段是否触发额外 TOAST 访问;“列没返回给客户端”不等于“数据库没读”。
最后用同一组请求回归授权、计算字段和关联字段,确认没有因为投影过窄而出现缺列、重复补查或新的 N+1。有效的字段投影应让 GraphQL 选择集影响数据库读取成本,同时仍由服务端白名单和领域规则控制真正的数据访问边界。