
API 设计 / 系统课时
构建指标与告警面板
构建指标与告警面板
本课把 GraphQL 的运行状态整理成可行动的指标体系:从流量、错误和延迟开始,再下钻 Resolver、缓存与下游依赖,并用低基数标签和 SLO 阈值构建看板与告警,避免“有图表但不知道该查哪里”。
学习目标
- 为 GraphQL 请求、Resolver、缓存和下游依赖选择可聚合指标
- 用直方图和 PromQL 计算错误率、分位延迟与缓存命中率
- 设计分层面板和持续时间告警,并控制标签基数
先建立从入口到依赖的指标链路
GraphQL 入口至少需要请求计数器和耗时直方图,例如 graphql_requests_total 与 graphql_request_duration_seconds。请求指标回答“流量是否变化、失败是否增加、整体是否变慢”,Resolver 指标继续回答“慢在哪里”。
Resolver 层可以记录 graphql_resolver_duration_seconds 与 graphql_resolver_errors_total,标签使用稳定的 schema 坐标,如 type="Product"、field="reviews"。缓存用命中、未命中计数器;数据库、HTTP、RPC 等依赖继续使用各自的请求、错误和延迟指标。
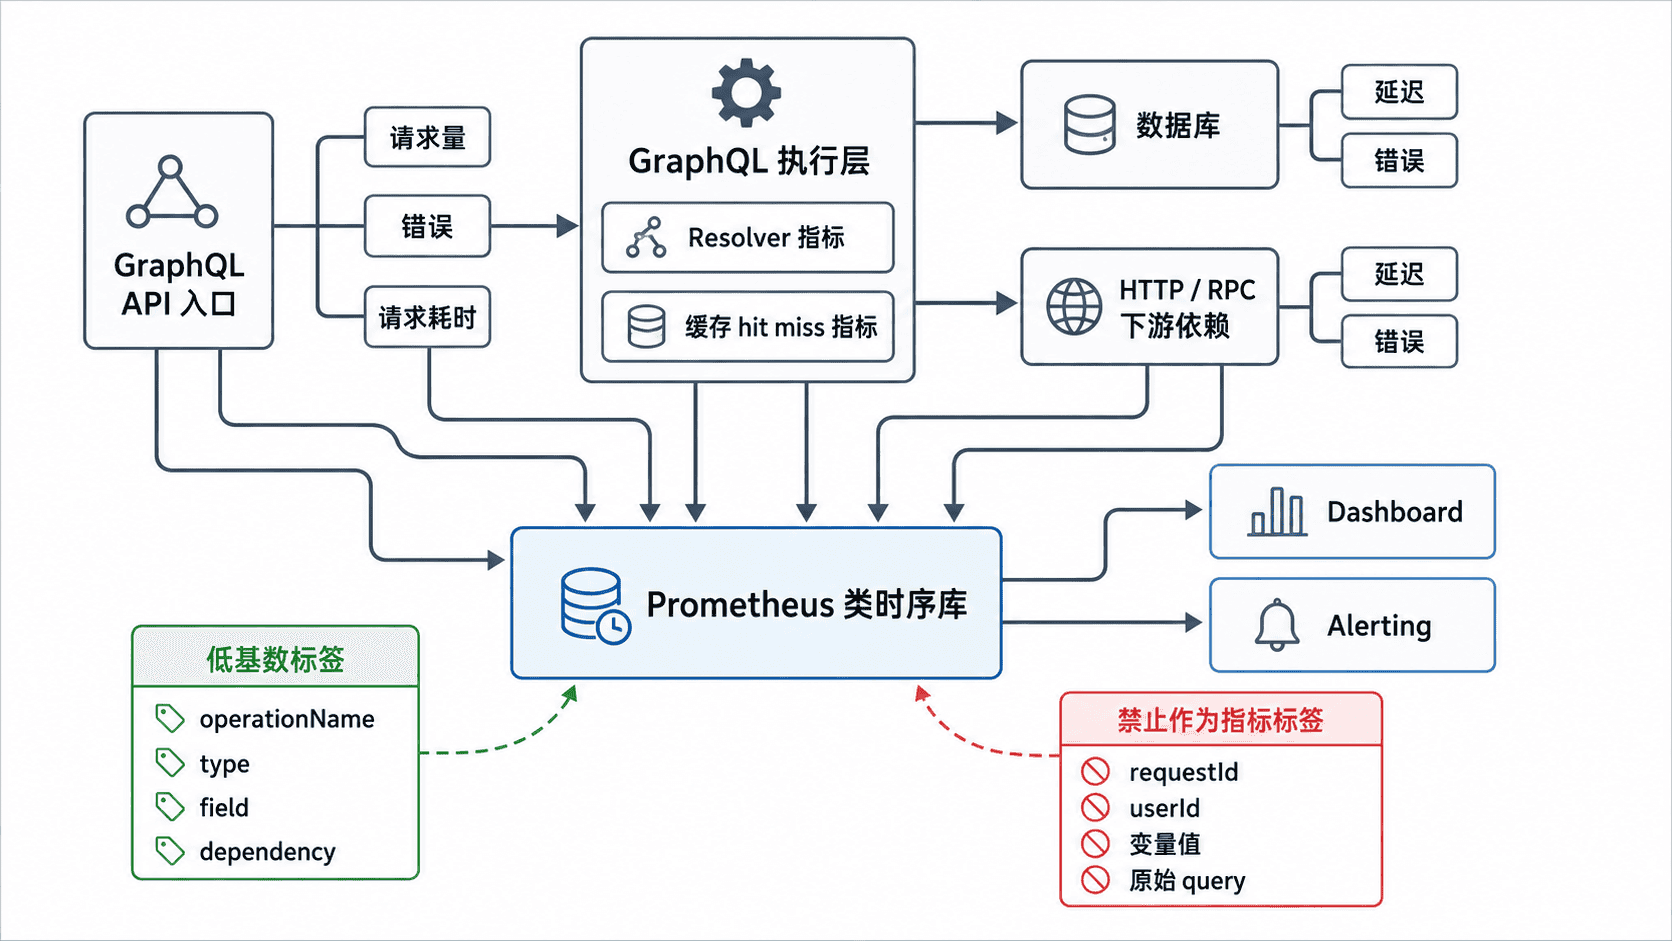
指标名称不是 GraphQL 标准的一部分,项目可以自定义,但语义必须统一。计数器只增不减,耗时使用 histogram,缓存命中率由 hit 与总请求计算。若要按操作观察趋势,operation_name 应来自受控操作集合;匿名操作和动态生成名称应归并,不能直接制造无限标签值。
用一组查询回答六类问题
面板不需要堆很多图,关键是每一行都能回答一个问题。下面 PromQL 假设指标已按前述名称暴露,窗口使用 5 分钟;实际环境可把 operation_name 做成看板筛选变量。
# 流量 QPS
sum(rate(graphql_requests_total[5m]))

# 错误率
sum(rate(graphql_requests_total{outcome="error"}[5m]))
/
sum(rate(graphql_requests_total[5m]))

# 请求 P95
histogram_quantile(
  0.95,
  sum by (le) (rate(graphql_request_duration_seconds_bucket[5m]))
)

# Resolver P95,按 schema field 下钻
histogram_quantile(
  0.95,
  sum by (le, type, field) (rate(graphql_resolver_duration_seconds_bucket[5m]))
)

# 缓存命中率
sum(rate(graphql_cache_requests_total{result="hit"}[5m]))
/
sum(rate(graphql_cache_requests_total[5m]))

# 下游依赖错误率
sum by (dependency) (rate(graphql_dependency_requests_total{outcome="error"}[5m]))
/
sum by (dependency) (rate(graphql_dependency_requests_total[5m]))
这些表达式的预期结果分别是 QPS、0~1 的错误比例、以秒为单位的 P95、按 Resolver 拆分的 P95、0~1 的缓存命中率,以及按依赖拆分的错误比例。没有流量时比例表达式可能得到 NaN,看板和告警应避免把它误判为故障。
请求直方图的 bucket 必须覆盖真实延迟分布。bucket 太稀会让分位数失真,太密会增加时序数量;应根据 SLO 和历史延迟选择边界,而不是照搬默认值。
把看板按定位顺序分层
第一层只放入口健康度:QPS、错误率、P50/P95/P99 与当前 SLO 消耗。第二层放 GraphQL 特有信号:Top 慢操作、Top 错误操作、Resolver P95 与错误数、缓存命中率。第三层再放数据库、HTTP/RPC 等依赖的延迟、错误和饱和度。
这种顺序能让排障从“用户是否受影响”逐步走到“哪个操作、哪个 Resolver、哪个依赖”。如果入口 P95 上升而 Resolver 正常,应优先检查网络、请求排队或框架开销;如果单个 Resolver 与某个下游同时上升,则定位范围已经很小。
用持续时间告警避免瞬时噪声
告警阈值应最终来自 SLO 和历史基线。下面给出一个最小 Prometheus 规则文件:错误率连续 10 分钟超过 2%,或整体 P95 连续 10 分钟超过 800 ms 时触发 warning。
groups:
  - name: graphql-api
    rules:
      - alert: GraphQLErrorRatioHigh
        expr: |
          (
            sum(rate(graphql_requests_total{outcome="error"}[5m]))
            /
            sum(rate(graphql_requests_total[5m]))
          ) > 0.02
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: GraphQL error ratio exceeds 2%
      - alert: GraphQLP95LatencyHigh
        expr: |
          histogram_quantile(
            0.95,
            sum by (le) (rate(graphql_request_duration_seconds_bucket[5m]))
          ) > 0.8
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: GraphQL P95 latency exceeds 800 ms
保存为 graphql-alerts.yml 后,可以用 Prometheus 自带的 promtool 检查规则语法。
promtool check rules graphql-alerts.yml预期输出:
Checking graphql-alerts.yml
  SUCCESS: 2 rules found
不同 Prometheus 版本的提示文案可能略有差异,但必须以成功退出码结束。上线前还要用历史数据回放阈值,确认正常峰值不会频繁报警,并在告警中附上对应看板、受影响操作和排障入口。