
API 设计 / 系统课时
分析 Router Query Plan
分析 Router Query Plan
Router 的性能问题常不是某个 Resolver 单点慢,而是查询计划制造了额外的跨服务等待。本课用真实 Query Plan 读懂 Fetch、Sequence、Parallel 与 Flatten,并据此识别串行链路和跨 subgraph 扇出带来的延迟与负载风险。
学习目标
- 读取 Router Query Plan 中最关键的执行节点与依赖关系。
- 区分串行 Fetch、并行 Fetch 和实体跨 subgraph 合并。
- 用查询计划定位额外网络跳数、关键路径与扇出风险。
先把客户端查询翻译成执行计划
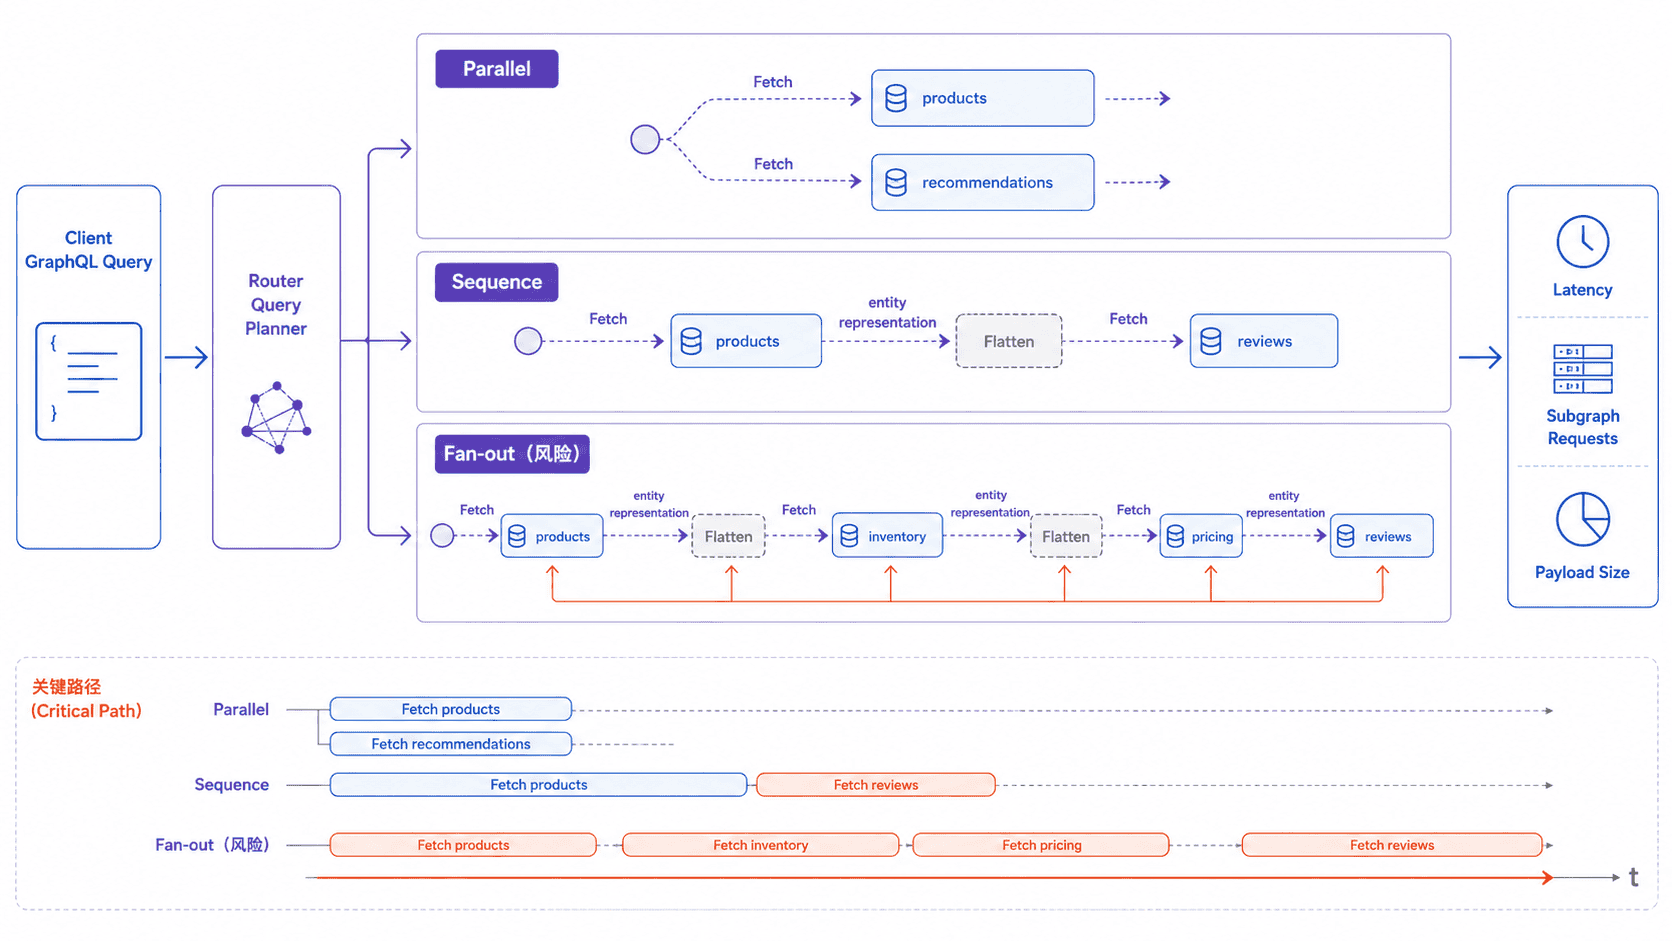
Router 不会把客户端操作原样转发给所有 subgraph,而是结合 supergraph Schema 判断每个字段由谁解析,再生成层级化 Query Plan。Fetch 表示向某个 subgraph 取数,Sequence 表示子节点必须按顺序执行,Parallel 表示子节点可以并行执行,Flatten 则把后续实体结果合并回前面已经得到的数据路径。
暴露一份真实 Query Plan
在受控调试环境中,可以启用 Router 的 Query Plan 暴露能力。支持该能力的 Router 可以通过 Apollo-Expose-Query-Plan 请求头返回查询计划;使用 dry-run 时只生成计划而不执行下游 Fetch,适合分析计划形态或做回归检查。开发模式也可用于本地查看计划,但不应把调试能力直接暴露给公网客户端。
下面是片段示例,依赖已经运行的 Router,且当前 supergraph 中存在 product、reviews 等示例字段:
curl -s http://localhost:4000/ \
  -H 'content-type: application/json' \
  -H 'Apollo-Expose-Query-Plan: dry-run' \
  --data '{"query":"query GetProduct { product(id: \"p1\") { id name reviews { rating } } }"}'
预期结果:响应不会执行 subgraph 请求,而会在 extensions 中返回 Query Plan。具体 JSON 字段和内部序列化格式可能随 Router 版本变化,因此分析时应关注节点关系,而不是把 Query Plan 的调试结构当成稳定业务 API。
一个典型的跨 subgraph 实体读取可以简化理解为:
QueryPlan {
  Sequence {
    Fetch(service: "products") { ... }
    Flatten(path: "product") {
      Fetch(service: "reviews") { ... }
    }
  }
}
这段是计划结构示意,不是可执行代码。它表达的是 reviews Fetch 依赖 products 先返回实体标识,因此两次网络访问位于同一条关键路径上。
先看 Sequence 的关键路径
Sequence 是性能排查的第一优先级,因为后一个 Fetch 依赖前一个结果,不能靠并发隐藏等待。如果计划形态是 A -> B -> C,端到端时间会同时受到三段依赖等待影响;其中任何一个慢 subgraph 都会把后续阶段一起向后推。
遇到长 Sequence 时,先检查后续 Fetch 是否真的需要前一服务提供的实体键,再判断某些紧密关联字段能否由同一领域 subgraph 完成,最后检查 @requires、字段所有权和实体边界是否制造了不必要的跨服务依赖。优化目标不是消灭 Federation,而是缩短真正决定响应时间的依赖链。
再看 Parallel 与跨服务扇出
Parallel 说明多个 Fetch 没有数据依赖,Router 可以同时发起请求。它通常能缩短墙钟时间,但并不减少总工作量:一个客户端请求仍可能同时占用多个 subgraph 的连接、CPU 和下游数据库资源。并行分支越宽,越需要把子图并发、超时和限流一起纳入分析。
跨服务扇出则要看“一个操作最终触发了多少 Fetch 阶段、多少实体表示以及多少下游工作”。标准 Federation 的实体解析可以把一组 representation 交给目标 subgraph,并不意味着每个列表元素必然对应一次独立 HTTP 请求;真正危险的是列表路径反复跨所有权边界,并在更深层继续跳转,导致载荷、序列化成本和下游查询量持续放大。
| 计划信号 | 主要风险 | 优先检查 |
|---|---|---|
长 Sequence |
延迟沿关键路径累加 | 实体边界、@requires、字段所有权 |
宽 Parallel |
同时压高多个 subgraph | 并发、连接池、超时与限流 |
多次 Flatten + Fetch |
跨服务跳数与实体载荷增加 | 列表规模、representation 大小、字段归属 |
把 Query Plan 变成回归门槛
性能优化前后必须使用同一个操作、同一份 supergraph 和尽量一致的 Router 配置比较计划。Schema、Router 查询规划器以及运行配置变化,都可能让相同客户端操作得到不同的执行路径,因此排查生产问题时应尽量在接近目标环境的 Router 上取得计划。
验收时不要只看“计划更短了”。同时记录 Fetch 节点数量、最长 Sequence 深度、并行分支数、各 subgraph span 耗时以及端到端 P95/P99。合理的改动应该让关键路径更短或更稳定,同时不把延迟问题转移成新的并发尖峰;Query Plan 告诉你 Router 准备怎么执行,追踪与指标则证明这些步骤实际花了多少时间。