
API 设计 / 系统课时
抽象 Resolver 数据源
抽象 Resolver 数据源
Resolver 最容易失控的地方,不是 GraphQL 语法,而是把 SQL、HTTP 请求、鉴权和错误处理全塞进字段函数。本课把数据访问下沉到 repository 与 data source,让 Resolver 只保留参数解释、权限边界和结果组装,并用可运行示例验证这种分层。
学习目标
- 区分 Resolver、Repository 与 Data Source 的职责边界
- 用依赖注入让 Resolver 脱离具体数据库和上游 API
- 判断事务、错误转换和请求级状态应该放在哪一层
Resolver 只处理 GraphQL 边界
Resolver 的输入是父对象、GraphQL 参数、请求上下文和字段信息,它最适合处理“这个字段该调用哪个业务能力”,不适合直接承担连接池、SQL 拼接、HTTP 重试或供应商协议细节。否则同一种数据访问很快会散落在多个字段中,测试也必须同时启动数据库或上游服务。
一个实用边界是:Repository 封装数据库语义,例如“按 ID 取商品”;Data Source 封装外部服务语义,例如“查询库存”;Resolver 只组合这些能力。这样更换 PostgreSQL 驱动或库存服务地址时,不需要改 GraphQL 字段定义。
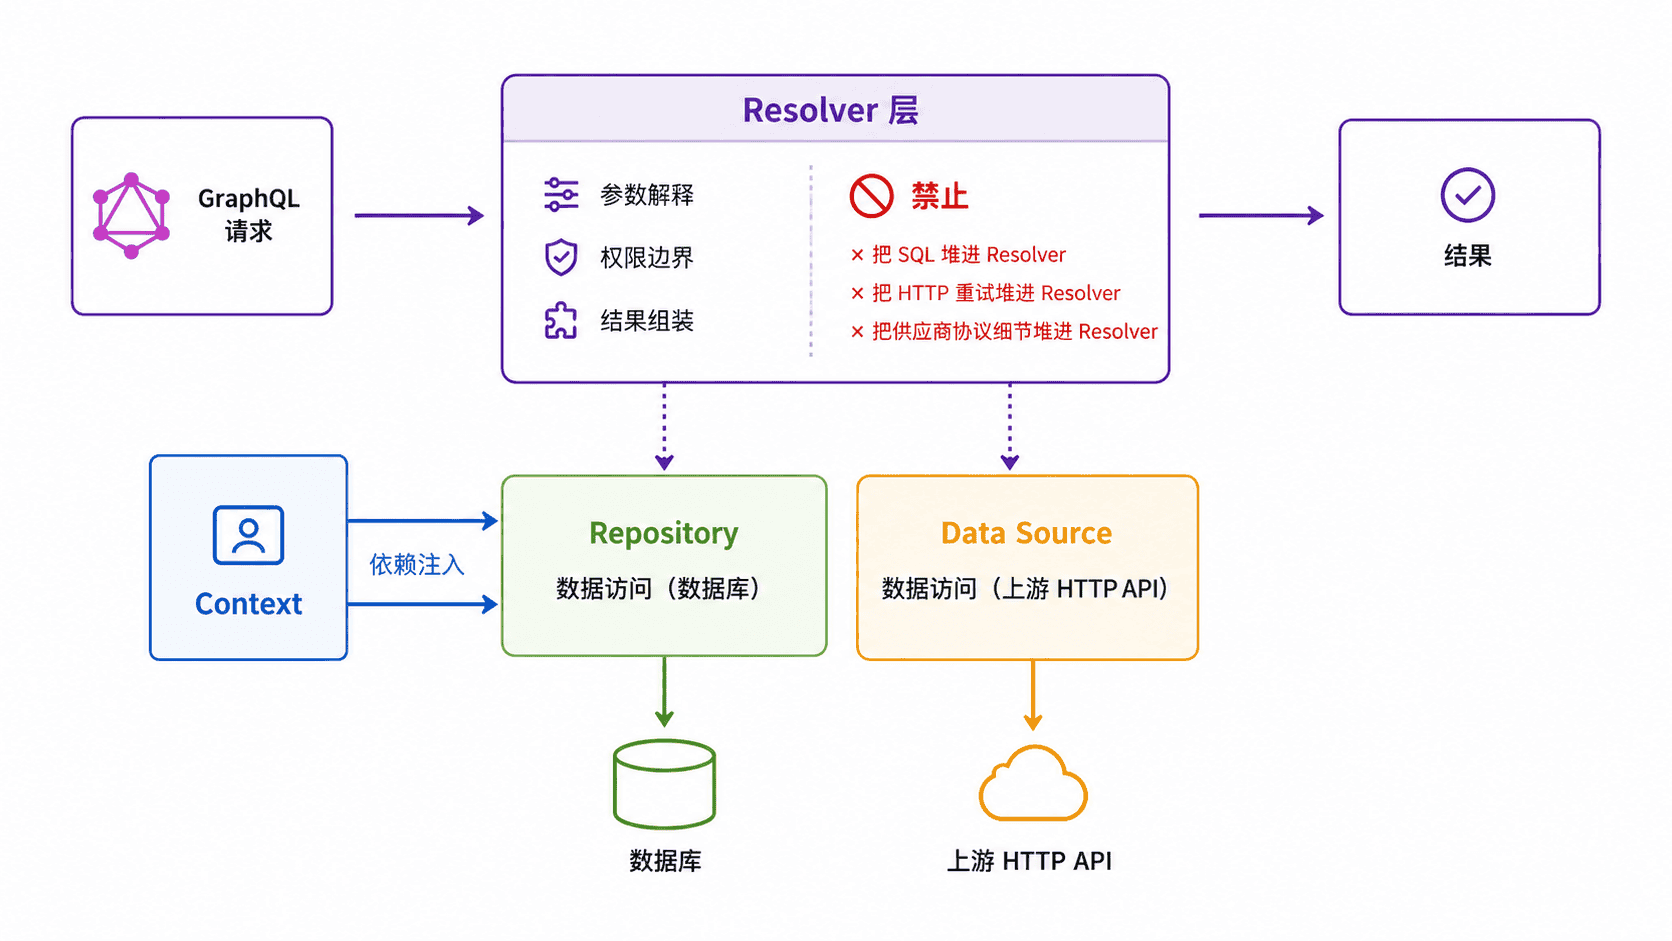
用依赖注入拆开数据库与上游 API
下面是一个可独立运行的最小示例。它直接调用与常见 GraphQL 服务器一致的 Resolver 函数签名,并用内存 mock 代替真实数据库和 HTTP 服务,因此无需安装框架即可观察分层效果。
class ProductRepository {
  constructor(db) {
    this.db = db;
  }

  async findById(id) {
    const row = await this.db.queryOne("SELECT id, sku, name FROM products WHERE id = ?", [id]);
    return row ?? null;
  }
}

class InventoryDataSource {
  constructor(fetchImpl, baseUrl) {
    this.fetchImpl = fetchImpl;
    this.baseUrl = baseUrl;
  }

  async getStock(sku) {
    const response = await this.fetchImpl(`${this.baseUrl}/stocks/${sku}`);
    if (!response.ok) throw new Error("inventory unavailable");
    return (await response.json()).stock;
  }
}

const resolvers = {
  Query: {
    product: (_parent, { id }, context) => context.products.findById(id),
  },
  Product: {
    stock: (product, _args, context) => context.inventory.getStock(product.sku),
  },
};

async function main() {
  const db = {
    queryOne: async (_sql, [id]) =>
      id === "p1" ? { id: "p1", sku: "SKU-1", name: "Keyboard" } : null,
  };
  const fetchImpl = async () => ({
    ok: true,
    json: async () => ({ stock: 12 }),
  });

  const context = {
    products: new ProductRepository(db),
    inventory: new InventoryDataSource(fetchImpl, "https://inventory.example"),
  };

  const product = await resolvers.Query.product(null, { id: "p1" }, context);
  const stock = await resolvers.Product.stock(product, {}, context);
  console.log(JSON.stringify({ ...product, stock }));
}

main().catch(console.error);
预期输出:
{"id":"p1","sku":"SKU-1","name":"Keyboard","stock":12}这里的 Resolver 不知道 SQL 驱动、表结构之外的查询细节,也不知道库存 API 如何重试或解析错误;测试 Resolver 时只要替换 context.products 与 context.inventory 即可。实际接入 Apollo Server、GraphQL Yoga 等框架时,把这些依赖放进请求上下文即可复用同一模式。
让请求级状态待在 Context
连接池、无用户状态的 Repository 可以长期复用,但带有当前用户令牌、租户 ID、请求级缓存或 DataLoader 的对象应按请求创建,并通过 Context 传入。这样可以避免把 A 用户的认证信息或缓存结果泄漏给 B 用户。
如果一次 GraphQL mutation 需要跨多个 Repository 保持原子性,事务边界通常由更高一层的 service/use-case 控制,再把同一个事务句柄传给 Repository;不要让多个 Resolver 各自偷偷开启事务。
把错误与数据协议留在边界内
Repository 应把数据库驱动的行结构转换成领域对象,Data Source 应屏蔽上游状态码、字段命名和重试策略;Resolver 再把可预期的业务错误转换成 GraphQL 能表达的错误或可空结果。这样字段层看到的是稳定的数据契约,而不是 PostgreSQL 错误码或供应商私有响应。
判断分层是否有效,可以做一个简单检查:把数据库实现替换成内存对象、把上游 API 替换成 stub 后,Resolver 测试仍然不需要改字段逻辑;如果做不到,说明具体数据访问细节仍然泄漏到了 GraphQL 层。