
API 设计 / 系统课时
定义 GraphQL 性能基线
定义 GraphQL 性能基线
性能优化前先把“当前有多快、在什么负载下变慢”量化。本课建立固定压测条件,记录请求速率、GraphQL 错误率、P50/P95/P99 延迟,并把慢请求继续下钻到 Resolver 字段耗时。
学习目标
- 用固定场景定义可重复的 GraphQL 性能基线。
- 正确区分吞吐、错误率和 P50/P95/P99 延迟。
- 采集 Resolver 耗时,定位尾延迟由哪些字段贡献。
先固定基线条件
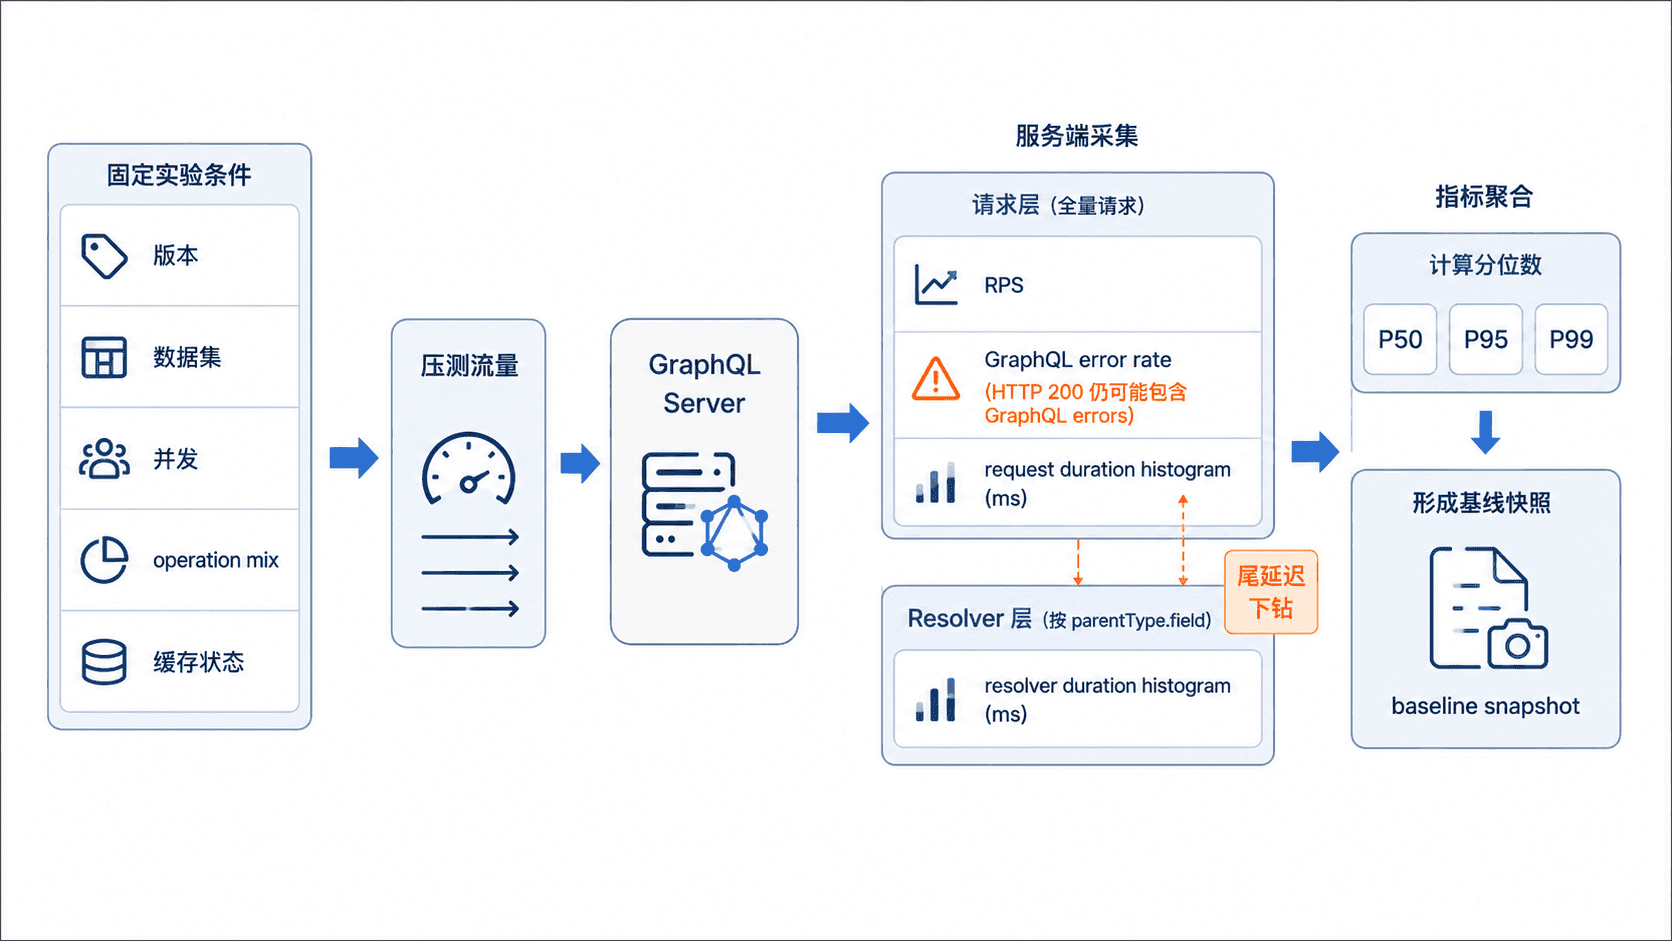
基线不是某次请求的耗时,而是一组可复现的实验条件加统计分布。至少固定服务版本、数据集规模、实例规格、请求并发、操作组合、缓存状态和测试时长;冷缓存与热缓存应分开记录,否则相同版本也无法公平比较。
GraphQL 还要额外固定操作文档和变量分布。一个只查询 id 的轻量请求,不能代表包含多级列表、远程调用或批量加载的真实流量。建议按实际业务占比建立 2~5 个代表性 operation,再汇总整体和分 operation 指标。
先定义指标口径
请求速率用单位时间内完成的 GraphQL 请求数表示;错误率应同时识别 HTTP 失败和 GraphQL errors,因为 Resolver 出错时 HTTP 状态仍可能是 200。延迟至少保留 P50、P95、P99:P50 表示典型体验,P95/P99 更容易暴露排队、慢依赖和少量高成本查询。
Resolver 耗时要按固定的 Schema 字段维度聚合,例如 Query.product。不要把用户 ID、原始变量或完整查询文本做成指标标签,否则会制造高基数,既拖慢指标系统,也让不同时间窗口难以比较。
在 Apollo Server 采集请求与 Resolver 耗时
下面示例要求 Node.js 20+、Apollo Server 5、GraphQL 16.11+、Express 5、@as-integrations/express5,并额外安装 prom-client。请求层记录成功与错误两个 outcome,Resolver 层只使用 parent_type 和 field 两个稳定标签,因此后续可以在 Prometheus 中聚合多实例并计算分位数。
import http from 'node:http';
import express from 'express';
import { ApolloServer } from '@apollo/server';
import { expressMiddleware } from '@as-integrations/express5';
import {
  Counter,
  Histogram,
  Registry,
} from 'prom-client';

const register = new Registry();

const requests = new Counter({
  name: 'graphql_requests_total',
  help: 'Completed GraphQL requests',
  labelNames: ['outcome'],
  registers: [register],
});

const requestDuration = new Histogram({
  name: 'graphql_request_duration_seconds',
  help: 'GraphQL request duration in seconds',
  labelNames: ['outcome'],
  buckets: [0.005, 0.01, 0.025, 0.05, 0.1, 0.25, 0.5, 1, 2.5, 5],
  registers: [register],
});

const resolverDuration = new Histogram({
  name: 'graphql_resolver_duration_seconds',
  help: 'GraphQL resolver duration in seconds',
  labelNames: ['parent_type', 'field'],
  buckets: [0.001, 0.005, 0.01, 0.025, 0.05, 0.1, 0.25, 0.5, 1],
  registers: [register],
});

const metricsPlugin = {
  async requestDidStart() {
    const started = process.hrtime.bigint();
    let outcome = 'ok';

    return {
      async didEncounterErrors() {
        outcome = 'error';
      },
      async executionDidStart() {
        return {
          willResolveField({ info }) {
            const stop = resolverDuration.startTimer({
              parent_type: info.parentType.name,
              field: info.fieldName,
            });
            return () => stop();
          },
        };
      },
      async willSendResponse() {
        const seconds =
          Number(process.hrtime.bigint() - started) / 1_000_000_000;
        requests.inc({ outcome });
        requestDuration.observe({ outcome }, seconds);
      },
    };
  },
};

const typeDefs = `#graphql
  type Product { id: ID!, name: String!, price: Float! }
  type Query { product(id: ID!): Product }
`;

const products = new Map([
  ['1', { id: '1', name: 'Keyboard', price: 99 }],
]);

const resolvers = {
  Query: {
    product: async (_, { id }) => {
      await new Promise((resolve) => setTimeout(resolve, 20));
      return products.get(id) ?? null;
    },
  },
};

const app = express();
const httpServer = http.createServer(app);
const server = new ApolloServer({
  typeDefs,
  resolvers,
  plugins: [metricsPlugin],
});

await server.start();

app.get('/metrics', async (_, res) => {
  res.set('Content-Type', register.contentType);
  res.end(await register.metrics());
});

app.use('/graphql', express.json(), expressMiddleware(server));

await new Promise((resolve) => httpServer.listen({ port: 4000 }, resolve));
console.log('GraphQL ready at http://localhost:4000/graphql');
预期结果:保存为 server.mjs 并安装示例依赖后,服务会在 /graphql 提供查询,在 /metrics 暴露请求计数、请求耗时直方图和 Resolver 耗时直方图。该插件统计的是已进入 Apollo 请求生命周期的请求;若 SLO 还包含反向代理拒绝、Body 解析失败等 HTTP 级错误,应在网关或 Express 层补充入口指标。
node server.mjs预期输出
GraphQL ready at http://localhost:4000/graphql用固定并发生成一份基线样本
下面的 Node.js 20+ 压测脚本只依赖内置 fetch。它固定 10 个并发 worker,每个发送 50 次相同 operation,并把 HTTP 失败或 GraphQL errors 都计为错误。
const url = process.env.URL ?? 'http://localhost:4000/graphql';
const concurrency = 10;
const requestsPerWorker = 50;
const latencies = [];
let errors = 0;

async function worker() {
  for (let i = 0; i < requestsPerWorker; i += 1) {
    const started = performance.now();
    const response = await fetch(url, {
      method: 'POST',
      headers: { 'content-type': 'application/json' },
      body: JSON.stringify({
        query: 'query Baseline { product(id: "1") { id name price } }',
      }),
    });
    const body = await response.json();
    latencies.push(performance.now() - started);

    if (!response.ok || body.errors?.length) {
      errors += 1;
    }
  }
}

const started = performance.now();
await Promise.all(Array.from({ length: concurrency }, () => worker()));
const seconds = (performance.now() - started) / 1000;

latencies.sort((a, b) => a - b);
const percentile = (p) =>
  latencies[Math.min(
    latencies.length - 1,
    Math.ceil(latencies.length * p) - 1,
  )];

console.log(JSON.stringify({
  requests: latencies.length,
  rps: latencies.length / seconds,
  errorRate: errors / latencies.length,
  p50Ms: percentile(0.50),
  p95Ms: percentile(0.95),
  p99Ms: percentile(0.99),
}, null, 2));
预期输出
{
  "requests": 500,
  "rps": <VALUE>,
  "errorRate": 0,
  "p50Ms": <VALUE>,
  "p95Ms": <VALUE>,
  "p99Ms": <VALUE>
}
<VALUE> 取决于机器、Node.js 版本和当时系统负载。真实基线应把运行时间拉长,并先完成预热,再至少重复多轮,记录中位轮次而不是挑最好的一次。
用指标系统复核尾延迟来源
客户端压测能看到端到端体验,但不能解释慢在哪里。Prometheus 抓取 /metrics 后,可以用以下查询同时得到吞吐、错误率、请求分位数和最慢 Resolver 的 P95。
sum(rate(graphql_requests_total[5m]))

sum(rate(graphql_requests_total{outcome="error"}[5m]))
/
sum(rate(graphql_requests_total[5m]))

histogram_quantile(
  0.50,
  sum by (le) (rate(graphql_request_duration_seconds_bucket[5m]))
)

histogram_quantile(
  0.95,
  sum by (le) (rate(graphql_request_duration_seconds_bucket[5m]))
)

histogram_quantile(
  0.99,
  sum by (le) (rate(graphql_request_duration_seconds_bucket[5m]))
)

histogram_quantile(
  0.95,
  sum by (le, parent_type, field) (
    rate(graphql_resolver_duration_seconds_bucket[5m])
  )
)
预期结果:前五个查询依次得到 RPS、错误率、P50、P95、P99;最后一个查询按 parent_type 与 field 返回各 Resolver 的 P95。实际数值均为 <VALUE>,应与同一版本、同一负载条件下保存的 baseline snapshot 比较。
当 P95/P99 明显恶化而 RPS、错误率和实验条件保持稳定时,再从高耗时 Resolver 向数据库、远程服务、DataLoader 批处理和缓存命中率继续下钻。这样性能优化才是在对比同一把尺子,而不是凭单次请求体感判断。