
API 设计 / 系统课时
识别 N+1 查询
识别 N+1 查询
N+1 的危险不在于“某个 Resolver 被调用很多次”,而在于父列表返回 N 条数据后,每个子字段又触发一次独立 I/O。本课用 Resolver 调用次数、SQL 日志和链路追踪三层证据确认这种模式,并区分真正的 N+1 与正常的批量读取。
学习目标
- 从父列表基数与子 Resolver 调用次数建立 N+1 假设
- 在 SQL 日志中识别“同模板、不同参数”的重复查询
- 用链路追踪确认重复 I/O 是否属于同一次 GraphQL 请求
先从调用形状建立假设
典型形状是:Query.posts 一次返回 N 篇文章,随后 Post.author 对每篇文章各查询一次作者。此时数据库访问总数约为 1 + N。字段 Resolver 被调用 N 次本身并不是错误,因为 GraphQL 本来就会逐对象解析字段;真正要追的是这 N 次调用是否各自落到数据库或远程 API。
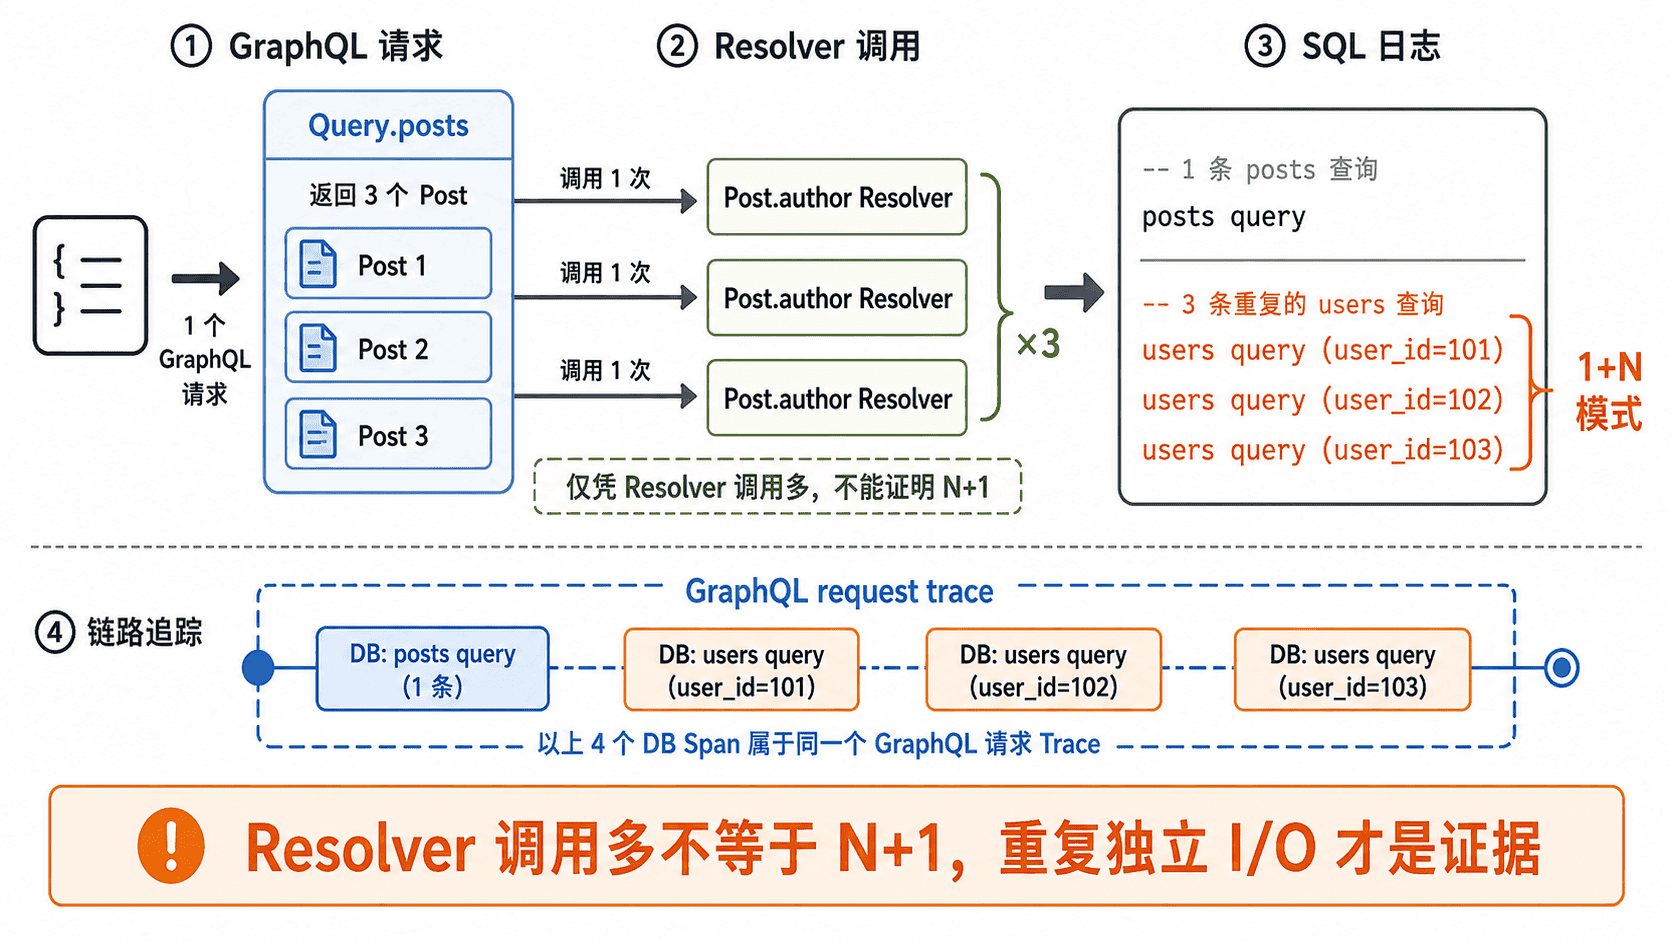
用最小复现观察 1 加 N
下面的脚本用与 GraphQL 字段 Resolver 相同的调用方式模拟父列表和作者字段,并把每次“SQL”打印出来。真实框架可能并发执行多个字段 Resolver,但重复查询的形状不会因此消失。
const posts = [
  { id: "p1", title: "A", authorId: "u1" },
  { id: "p2", title: "B", authorId: "u2" },
  { id: "p3", title: "C", authorId: "u1" },
];

const users = new Map([
  ["u1", { id: "u1", name: "Ada" }],
  ["u2", { id: "u2", name: "Linus" }],
]);

const db = {
  async listPosts() {
    console.log("SQL: SELECT id, title, author_id FROM posts LIMIT 3");
    return posts;
  },
  async findUserById(id) {
    console.log(`SQL: SELECT id, name FROM users WHERE id = '${id}'`);
    return users.get(id);
  },
};

const resolvers = {
  Query: {
    posts: () => db.listPosts(),
  },
  Post: {
    author: (post) => db.findUserById(post.authorId),
  },
};

async function main() {
  const rows = await resolvers.Query.posts();
  for (const post of rows) {
    await resolvers.Post.author(post);
  }
}

main().catch(console.error);
预期输出:
SQL: SELECT id, title, author_id FROM posts LIMIT 3
SQL: SELECT id, name FROM users WHERE id = 'u1'
SQL: SELECT id, name FROM users WHERE id = 'u2'
SQL: SELECT id, name FROM users WHERE id = 'u1'
父查询只执行一次,但作者查询随文章数量增长,而且 u1 甚至被重复读取。这就是典型 N+1:列表规模从 3 增长到 300 时,子查询数量也会近似线性增长。
在 SQL 日志里找重复模板
排查时先给一次 GraphQL 请求打上 request ID 或 trace ID,再只看这次请求产生的数据库语句。重点不是逐条读 SQL,而是找“同一语句模板在极短时间内重复出现,只是绑定参数不同”的模式,例如连续多次 WHERE id = ?。
如果数据库客户端支持 query hook,可以按规范化 SQL 模板计数;没有 hook 时,也可以先打开开发环境 SQL 日志。确认父列表返回 N 条后,再核对子查询次数是否接近 N。分页会改变 N,但不会改变这种增长关系。
用链路追踪确认它属于同一次请求
SQL 日志能证明重复查询,Trace 则能回答这些查询是否都由同一次 GraphQL operation 触发。理想的 span 至少带上 operation name、GraphQL field 或 resolver 名称、数据库操作名和父 trace;这样可以看到一个 Query.posts span 下出现大量 Post.author 与 DB 子 span。
并发执行不会让 N+1 变成“不是问题”。它可能缩短单次请求的墙钟时间,却会把几十或几百个查询同时压到连接池和数据库上,因此仍需治理。
排除看起来相似的正常模式
以下现象不能单独判定为 N+1:一个字段 Resolver 被调用很多次但命中请求级缓存;底层把多个 key 合成一次 WHERE id IN (...);或者固定执行少量与 N 无关的查询。真正的判断标准是独立 I/O 次数是否随父列表元素数量增长。
确认 N+1 后,再考虑请求级批处理与缓存、Repository 批量接口或 SQL join。修复前后应使用同一 GraphQL 查询和相同列表规模复测,目标是把查询次数从 1 + N 压到常数级或少量批次,而不仅仅是让某次运行看起来更快。