
API 设计 / 系统课时
分层排查慢查询与超时
分层排查慢查询与超时
GraphQL 变慢时,N+1、单条慢 SQL、缓存失效和上游依赖超时都可能表现为 P95/P99 上升。有效排障不是从日志里猜原因,而是先用 operation signature、requestId 与 traceId 对齐证据,再沿关键路径确认时间究竟消耗在哪一层。
学习目标
- 用日志、指标、Trace 与数据库证据定位慢请求的主要耗时层
- 根据 Span 形态区分 N+1、慢 SQL、缓存失效和依赖超时
- 用同一负载验证修复是否真正降低尾延迟而非转移问题
先把同一个请求的证据对齐
第一步先固定一个可复现的操作:记录稳定的 operation signature、请求时间窗和 traceId,再查看该时间窗内的请求 P95/P99、错误率、并发数、缓存命中率与下游错误。日志负责告诉你“哪次请求出了问题”,指标负责判断“问题是否普遍”,Trace 负责回答“时间花在哪”,数据库证据负责确认“SQL 为什么慢”。
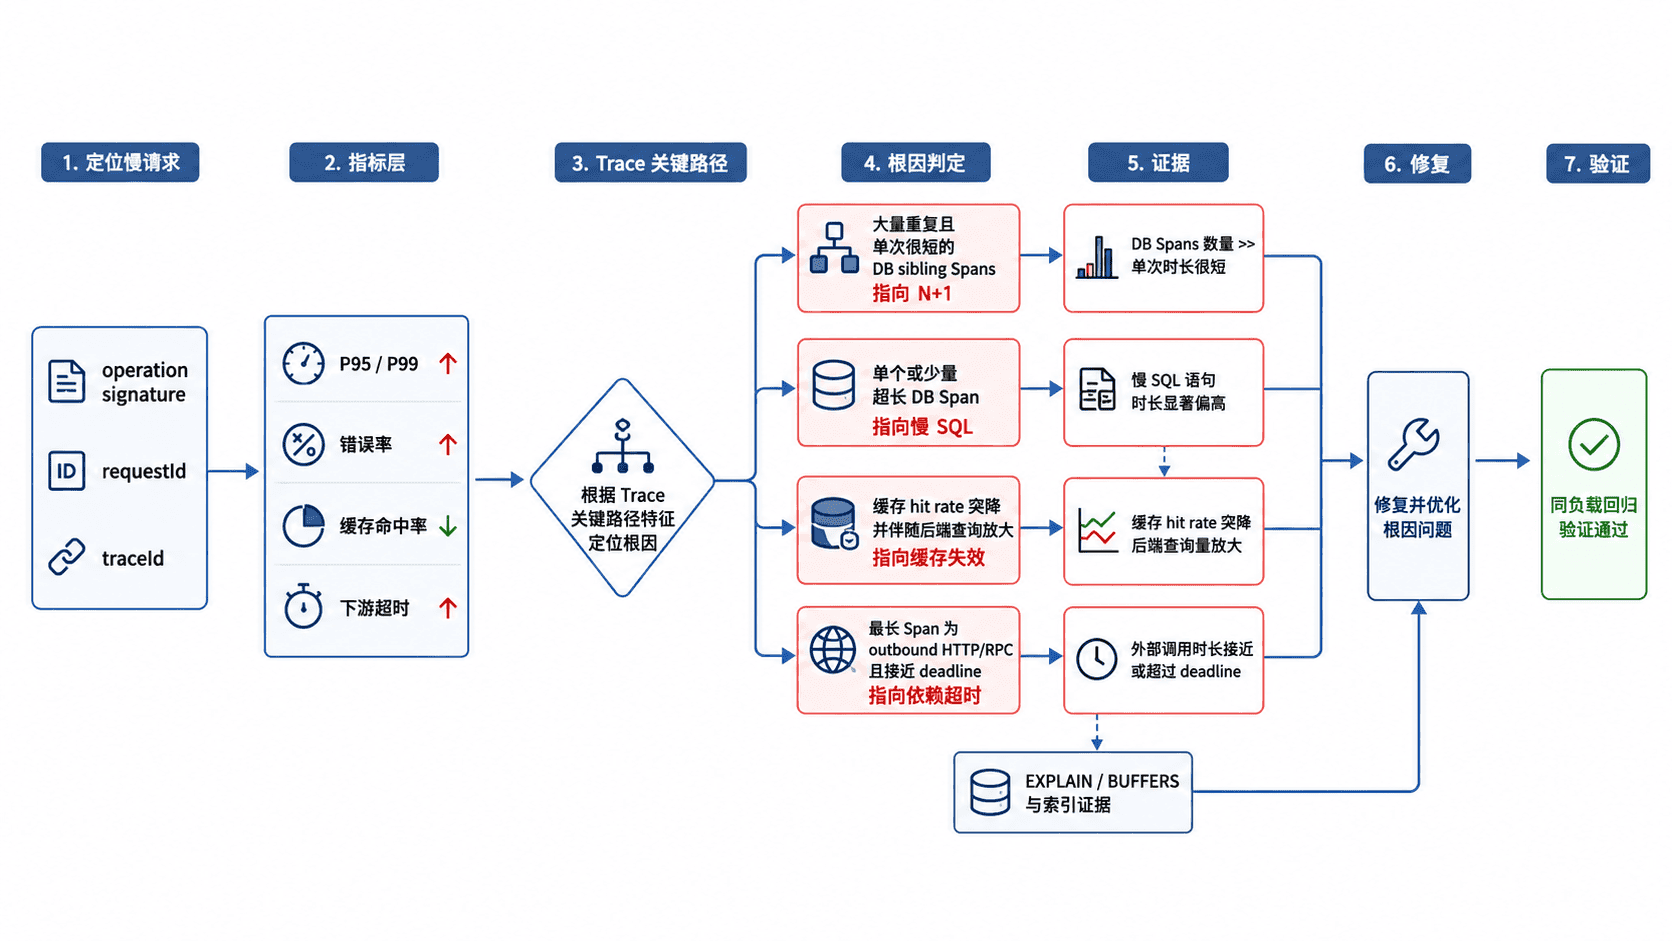
不要直接把根 Span 的总耗时等同于所有子 Span 之和。Sibling Resolver 或下游请求可能并行执行,真正决定端到端延迟的是关键路径;排障时应优先找持续时间最长、且位于依赖链上的 Span。
用 Span 形态先区分四类根因
| 现象 | Trace 或指标证据 | 下一步验证 |
|---|---|---|
| N+1 | 同一字段出现大量形状相同的短 DB Span,参数不同,单条不慢但总次数随结果集增长 | 统计每次请求 DB Span 数量,检查是否缺少批量加载 |
| 慢 SQL | 只有一条或少量 DB Span 占据关键路径,单条耗时明显异常 | 查看执行计划、扫描行数、锁等待与 Buffer 命中 |
| 缓存失效 | 缓存 hit rate 同期下降,数据库或上游请求数突然放大,多个操作一起变慢 | 检查 key、TTL、失效事件和缓存服务错误 |
| 依赖超时 | 最长 Span 是 outbound HTTP/RPC,持续时间接近客户端或网关 deadline,数据库正常 | 检查下游 P99、连接池、重试和超时预算 |
这一步的目标不是立即修复,而是把调查范围从“整个 GraphQL 服务”缩小到一个层级。只有证据一致时才进入下一层,否则很容易因为某条显眼日志而误判。
用数据库证据确认慢 SQL
假设 Trace 已经指向 posts 查询,可在测试环境或只读副本上对同形状 SQL 查看真实执行计划。ANALYZE 会实际执行语句,因此不要直接对高成本写操作或不可控生产查询使用。
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, title, created_at
FROM posts
WHERE author_id = 42
ORDER BY created_at DESC
LIMIT 20;
预期输出会因数据量、缓存状态和索引而变化,时间与计数分别可记为 <TIME>、<VALUE>。如果看到大范围顺序扫描、过滤掉大量行或磁盘读取偏高,就有了“单条 SQL 本身很慢”的数据库证据。
Limit  (actual time=<TIME>..<TIME> rows=20 loops=1)
  ->  Sort  (actual time=<TIME>..<TIME> rows=<VALUE> loops=1)
        Sort Key: created_at DESC
        ->  Seq Scan on posts  (actual time=<TIME>..<TIME> rows=<VALUE> loops=1)
              Filter: (author_id = 42)
              Rows Removed by Filter: <VALUE>
Buffers: shared hit=<VALUE> read=<VALUE>
Execution Time: <TIME> ms
如果 Trace 中不是一条长 SQL,而是数十条类似 SELECT ... WHERE id = ? 的短查询,那么执行计划再漂亮也不能解释端到端变慢;此时应回到 Resolver 调用次数,优先处理 N+1。
按根因修复而不是统一加超时
N+1 应通过请求级 DataLoader、批量查询或重新划分数据访问边界减少调用次数,并验证一次请求的 DB Span 数量从随 N 增长变为固定批次。慢 SQL 则围绕索引、谓词、排序、扫描行数和锁等待处理,修复后要重新看执行计划,而不只是看“这次碰巧快了”。
缓存失效要核对缓存键是否遗漏身份或变量、TTL 是否异常、失效事件是否过宽,以及缓存服务自身是否报错。依赖超时则要把连接超时、请求超时和整体 deadline 分层设置;重试只用于可安全重试的操作,并配合退避、并发限制或熔断,避免慢依赖被重试风暴进一步放大。
用同一负载完成回归闭环
修复后的验证条件必须与故障复现尽量一致:相同 operation signature、数据集、并发、缓存状态和下游版本。至少比较请求 P95/P99、GraphQL 错误率、每请求 DB Span 数量、缓存命中率和最长下游 Span;只改善平均值而尾延迟仍然恶化,不能视为问题已经解决。
最终应形成一条可重复的定位路径:先用指标判断范围,用 Trace 找关键路径,用日志补上下文,再用数据库或下游证据确认根因。这样即使表面现象都是“GraphQL 超时”,也能把 N+1、慢 SQL、缓存失效和依赖超时分别落到可验证的修复动作上。