
API 设计 / 系统课时
理解 Resolver 执行模型
理解 Resolver 执行模型
Resolver 决定 GraphQL 字段的值从哪里来。理解执行模型后,你就能判断父字段何时完成、子字段拿到什么数据、同级字段能否并行,以及哪些字段其实无需手写 Resolver。
学习目标
- 说明字段 Resolver 与选择集之间的对应关系
- 理解父字段结果如何成为子字段的
parent - 区分默认解析、普通并行执行与 Mutation 顶层串行执行
从选择集进入 Resolver
GraphQL 执行不是“调用一个接口函数后一次性组装 JSON”,而是沿着查询选择集逐层完成字段。每个字段先解析出一个值,再根据字段类型决定如何完成这个值:标量直接序列化,对象继续执行它的子选择集,列表则对每个元素继续完成对应类型。
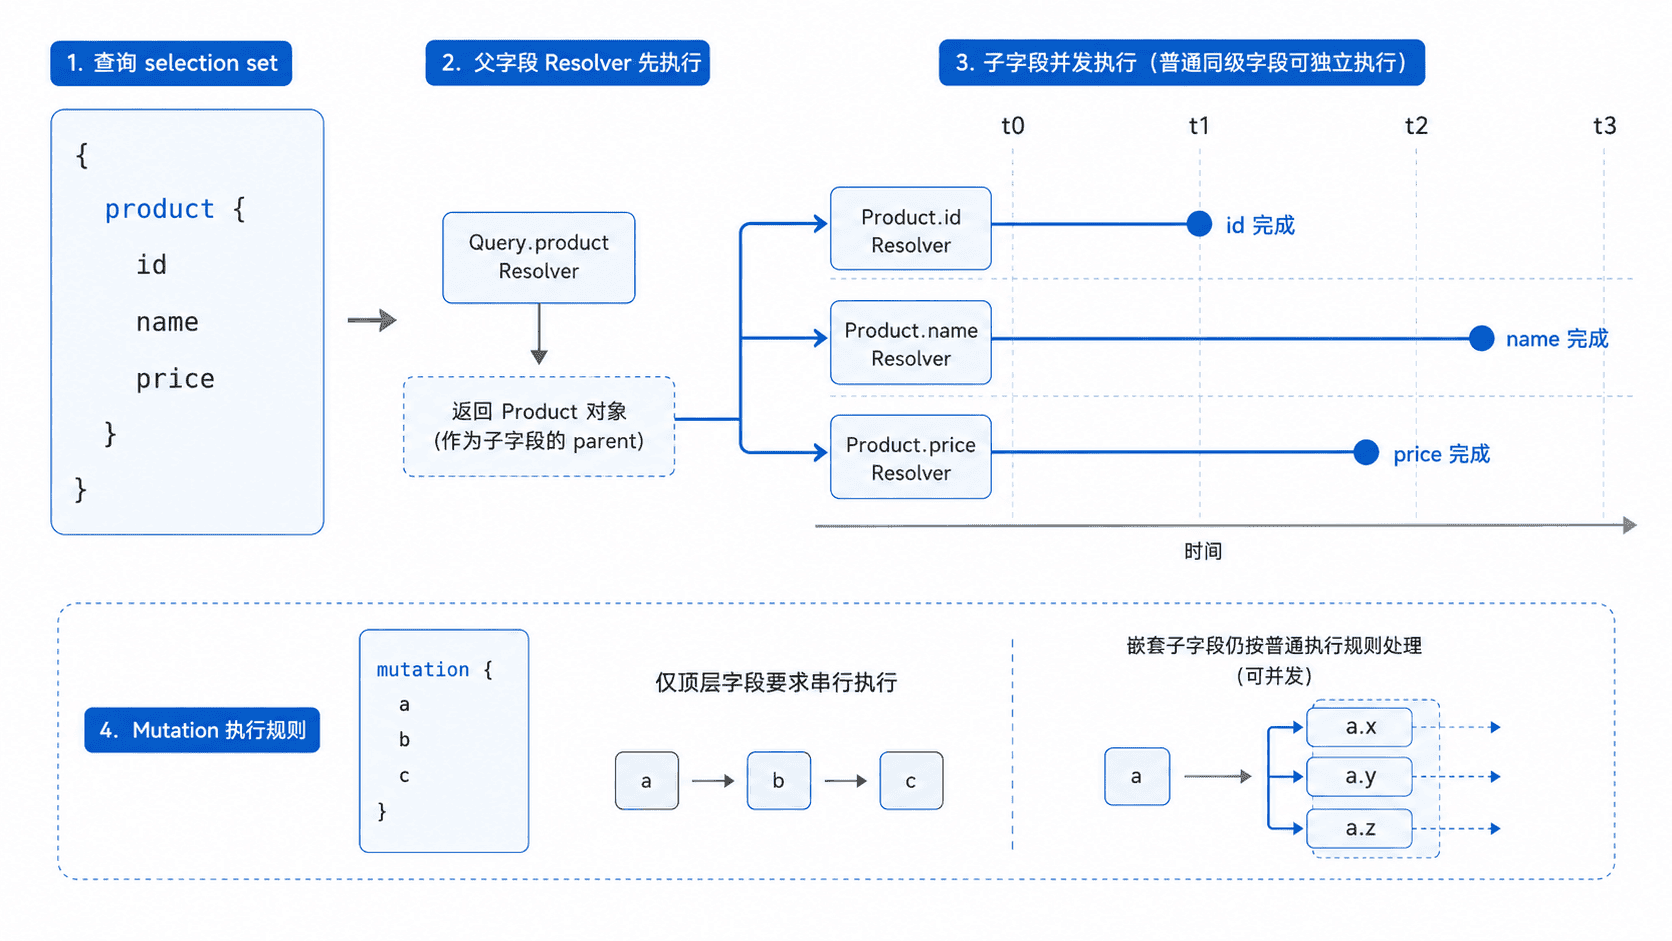
因此,子字段必须建立在父字段已经解析出的对象之上。例如 Query.product 返回商品对象后,执行器才能用这个对象作为 Product.id、Product.name、Product.price 的 parent。同一层的普通字段则不应依赖彼此的执行先后。
默认 Resolver 在做什么
并不是每个字段都要写函数。以 GraphQL.js 为例,字段没有显式 resolve 时,默认 Resolver 会在 parent 上查找与字段名相同的属性;属性是普通值就直接返回,是函数就调用该函数。因此数据库层已经返回 { id, name, price } 这类与 Schema 字段同名的对象时,叶子字段通常可以直接使用默认解析。
这个机制也解释了 Resolver 链:父 Resolver 的返回值不是最终响应,而是下一层字段解析时的数据源。Resolver 既可以同步返回值,也可以返回 Promise;执行器会等待该字段所需的异步结果,再继续完成对应返回类型。
跑一次父子字段执行
下面示例只为根字段提供函数,Product 的三个字段全部交给默认 Resolver。name 与 price 被故意设置为不同延迟,用来观察同级字段的异步工作可以重叠。
import { buildSchema, graphql } from "graphql";

const delay = (ms) => new Promise((resolve) => setTimeout(resolve, ms));

const schema = buildSchema(`
  type Product {
    id: ID!
    name: String!
    price: Int!
  }

  type Query {
    product(id: ID!): Product!
  }
`);

const rootValue = {
  async product({ id }) {
    console.log("1 Query.product start");
    await delay(5);
    console.log("2 Query.product end");

    return {
      id,
      async name() {
        console.log("3 Product.name start");
        await delay(30);
        console.log("6 Product.name end");
        return "Keyboard";
      },
      async price() {
        console.log("4 Product.price start");
        await delay(10);
        console.log("5 Product.price end");
        return 399;
      },
    };
  },
};

const result = await graphql({
  schema,
  source: `{ product(id: "p1") { id name price } }`,
  rootValue,
});

console.log(JSON.stringify(result, null, 2));
预期输出
1 Query.product start
2 Query.product end
3 Product.name start
4 Product.price start
5 Product.price end
6 Product.name end
{
  "data": {
    "product": {
      "id": "p1",
      "name": "Keyboard",
      "price": 399
    }
  }
}这里最重要的不是日志编号,而是依赖关系:Query.product 必须先得到商品对象;随后 name 与 price 都可以开始自己的异步工作,不需要等待对方完成。最终响应仍按照查询中的响应字段组织,而不是按照 Promise 完成先后组织。
并行、串行与错误传播
普通选择集中的字段应视为可独立执行,执行器可以按任意安全顺序处理它们,实践中通常会让异步工作并发推进。因此不要让 Query Resolver 依赖“另一个同级 Resolver 已经先修改了状态”,这会把实现建立在没有保证的顺序上。
Mutation 有一个关键例外:顶层 Mutation 字段必须串行执行,这样多个有副作用的写操作可以按请求中的顺序发生。但每个顶层 Mutation 返回对象后的嵌套字段,仍按普通字段规则完成,不能把“Mutation 全树串行”当成执行模型。
如果 Resolver 抛错,GraphQL 会把错误记录到响应的 errors 中,并按字段可空性处理数据。可空字段通常变成 null;非空字段出现 null 或执行错误时会向上冒泡,直到遇到可空父级,严重时可能让整个 data 变成 null。因此 Resolver 的职责应保持字段级、可组合,并让 Schema 的空值约束明确表达失败边界。