
API 设计 / 系统课时
启用 APQ 降低传输开销
启用 APQ 降低传输开销
Automatic Persisted Queries(APQ)把重复发送的 GraphQL 查询文本替换为固定长度的 SHA-256 摘要。客户端第一次遇到缓存未命中时自动回退并上传完整查询,之后只发送摘要,从而降低请求体大小,同时保持普通 GraphQL 查询的开发体验。
学习目标
- 说清 APQ 的首次握手、缓存命中与回退路径
- 实现客户端的 hash-only 请求与未命中重试
- 判断 APQ 缓存、安全边界与适用场景
APQ 的握手本质
APQ 不会让服务器凭空知道一条新查询。客户端先对准备发送的查询字符串计算 SHA-256,并把摘要放入 extensions.persistedQuery.sha256Hash。服务端以摘要查缓存:命中就取出查询并执行,未命中则返回 PersistedQueryNotFound,客户端再携带“查询文本 + 同一摘要”重试。
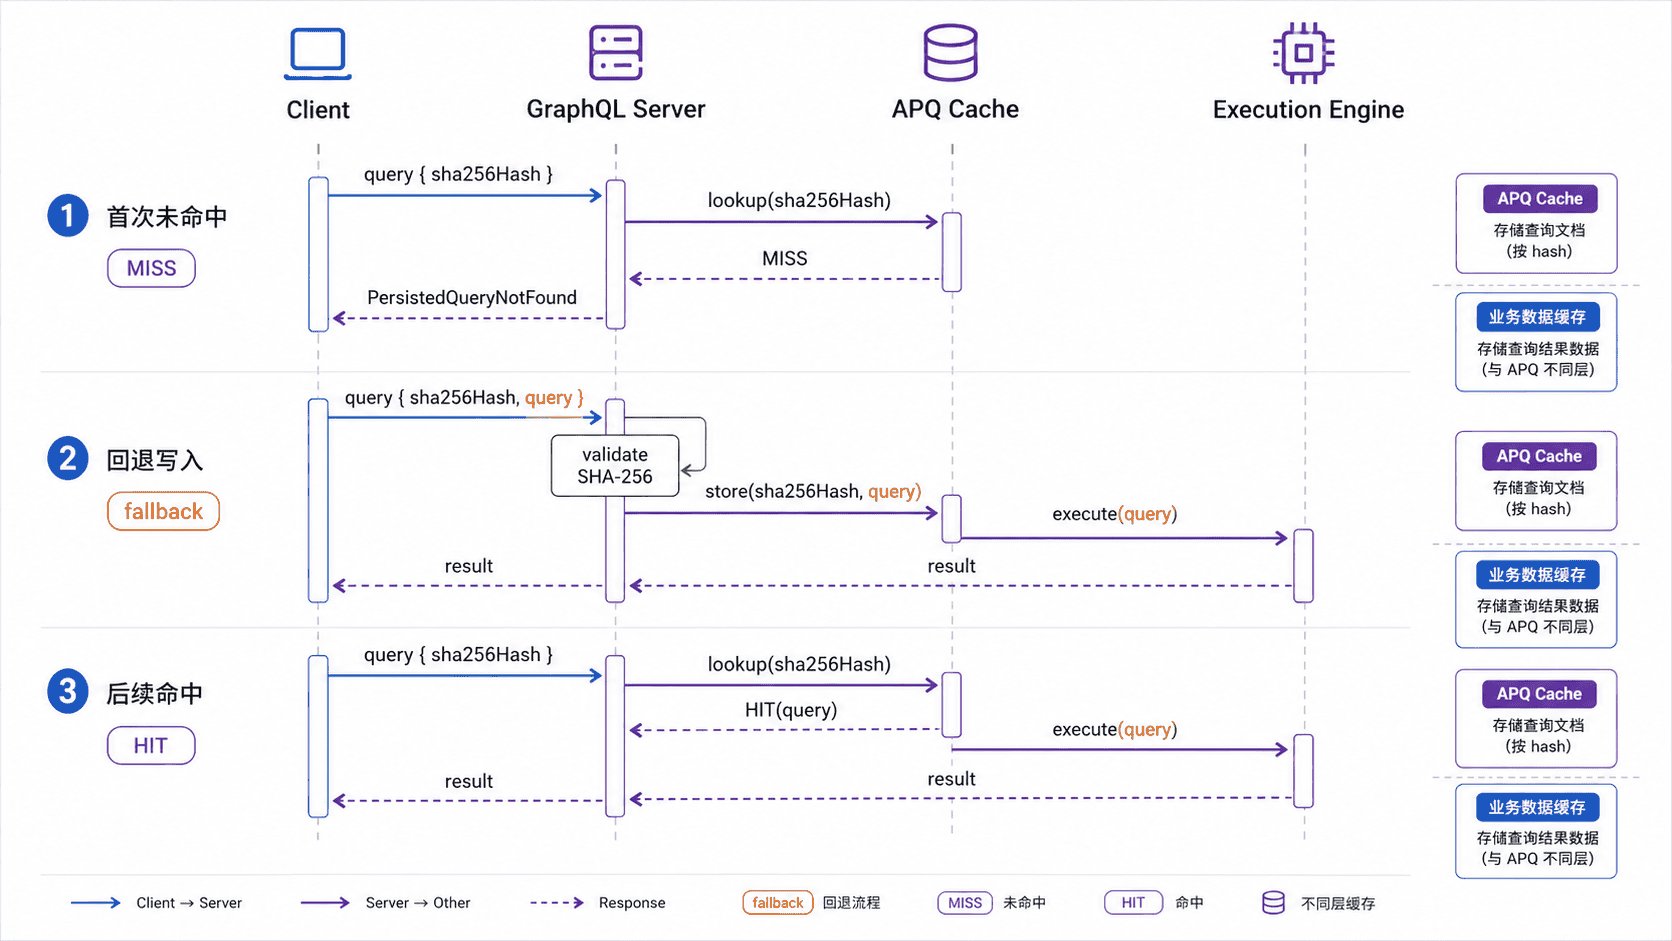
这条回退链路很重要:APQ 是传输优化,不是业务数据缓存,也不是查询结果缓存。首次冷缓存仍需要传完整查询,服务端仍要解析和执行;收益主要出现在同一查询被大量重复发送时。
实现一次完整的客户端回退
下面脚本需要 Node.js 18+,并假设目标 GraphQL 端点已经支持 APQ。通过环境变量 GRAPHQL_URL 指定地址;查询文本、摘要算法和两次 hash-only 请求都在脚本内完成。
import { createHash } from "node:crypto";

const endpoint = process.env.GRAPHQL_URL ?? "http://localhost:4000/graphql";
const query = `query Viewer {
  viewer {
    id
    name
  }
}`;

const sha256Hash = createHash("sha256").update(query).digest("hex");
const extension = {
  persistedQuery: { version: 1, sha256Hash }
};

async function post(payload) {
  const response = await fetch(endpoint, {
    method: "POST",
    headers: { "content-type": "application/json" },
    body: JSON.stringify(payload)
  });
  return response.json();
}

const first = await post({ extensions: extension });
const miss = first.errors?.some(
  (error) =>
    error.extensions?.code === "PERSISTED_QUERY_NOT_FOUND" ||
    error.message === "PersistedQueryNotFound"
);

console.log(`APQ cache: ${miss ? "MISS" : "HIT"}`);

if (miss) {
  const warm = await post({ query, extensions: extension });
  console.log(`Fallback: ${warm.errors ? "FAILED" : "STORED"}`);
}

const second = await post({ extensions: extension });
console.log(`Second hash-only request: ${second.errors ? "FAILED" : "HIT"}`);
冷缓存且服务端实现正确时,预期输出为:
APQ cache: MISS
Fallback: STORED
Second hash-only request: HIT
如果第一步已经命中缓存,首行会是 APQ cache: HIT,脚本会跳过回退;这是正常的热缓存路径。若服务端返回“不支持 persisted query”一类错误,客户端应停止重复尝试 APQ,而不是每次都再发送一轮失败握手。
缓存要有边界
服务端收到“完整 query + hash”时,应重新计算摘要并确认与客户端提供的值一致,再写入 APQ 缓存。缓存键通常就是 SHA-256,值是查询文本;生产环境还要设置容量上限、TTL 或 LRU 淘汰策略,避免任意客户端持续提交新查询造成内存无限增长。
多实例部署时需要明确缓存作用域。每个实例使用本地缓存最简单,但请求落到另一实例时可能再次 MISS;共享 Redis 一类缓存能提高命中率,却会增加网络依赖。是否共享应根据实例数、查询重复度和额外延迟决定,而不是默认“分布式缓存一定更快”。
什么时候值得启用
APQ 最适合移动网络、查询文本较长、同一操作重复率高的场景。它能减少上行字节数,也让 hash-only 请求更容易配合 GET 与 CDN 缓存策略,但是否使用 GET 仍要考虑变量、认证头和敏感信息。
评估效果时至少观察 APQ 命中率、PersistedQueryNotFound 比例、平均请求体大小与回退次数。命中率长期很低时,通常意味着查询文本不稳定、构建产物频繁变化或缓存容量不足;先解决这些问题,再谈继续扩大 APQ 覆盖面。