
API 设计 / 系统课时
使用 DataLoader 批量加载
使用 DataLoader 批量加载
GraphQL 的关联字段很容易把一次查询放大成多次数据访问。本节用一个可运行示例把多个 author 字段的单键加载合并为一次批量查询,并处理批量结果乱序与缺失值,避免 N+1 同时保证每个 resolver 拿到正确对象。
学习目标
- 理解
load(key)如何在同一批次调度窗口内收集键并合并访问。 - 编写满足“返回长度相同、索引与输入键一一对应”的批量函数。
- 在 GraphQL resolver 中按请求创建并复用同一个 DataLoader 实例。
从字段解析到一次批量查询
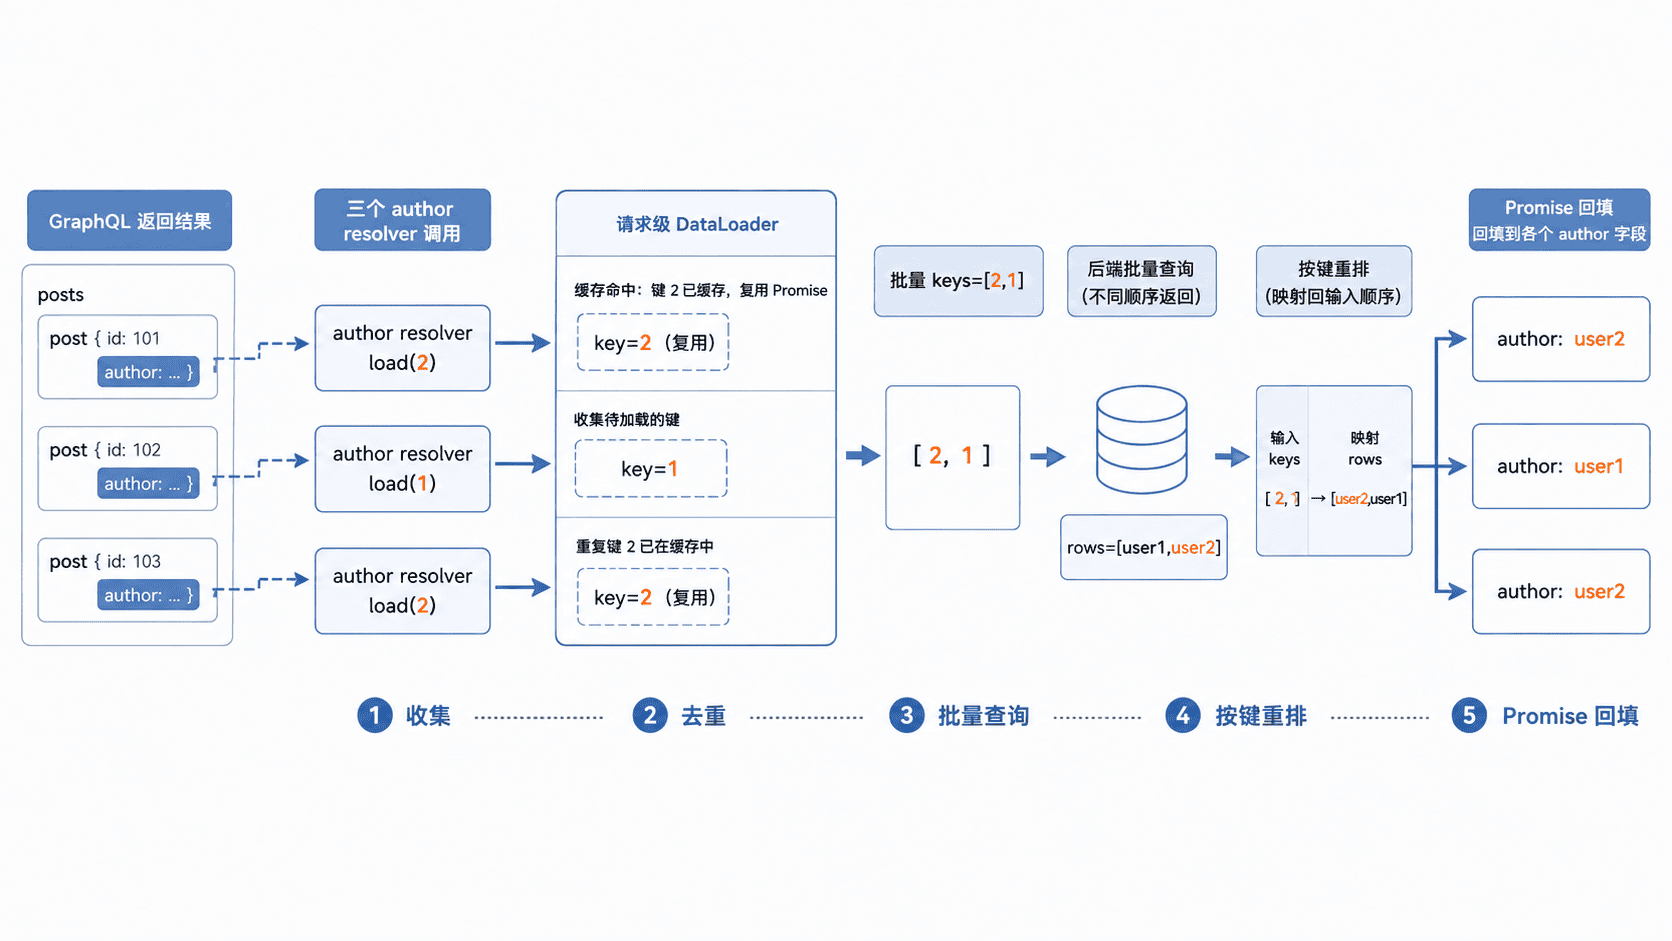
假设一次 GraphQL 查询返回 3 篇文章,每篇文章都解析 author。如果 Post.author 直接按 authorId 查询数据库,就可能出现“1 次文章查询 + 3 次作者查询”。DataLoader 让 resolver 继续按单个 ID 取值,但把同一调度窗口内的多个 load() 合并后交给一个批量函数。
默认缓存还会去掉同一 loader 内重复的键。比如三个字段依次请求作者 2、1、2,批量函数通常只收到 2、1。因此 DataLoader 同时解决“收集键”和“请求内重复加载”两个问题,但真正的数据库批量查询仍需要你自己实现。
批量函数必须保持键的对应关系
批量函数接收一组键,并返回一个 Promise;Promise 最终得到的数组必须与输入键数组长度相同且索引对应。数据库的 IN 查询通常不保证返回顺序,而且缺失行可能直接不返回,所以不能把数据库结果数组原样交给 DataLoader。
安全做法是先把查询结果建立成 Map,再按原始 keys 做一次 map。找不到的数据可按你的 GraphQL 语义返回 null,也可以返回 Error,但不能因为某个 ID 缺失就把这一项从返回数组中删除。
在 GraphQL resolver 中落地
下面示例使用 graphql 与 dataloader 包。为了让代码可直接运行而不依赖数据库,queryUsersByIds() 用内存数组模拟一次 WHERE id IN (...) 查询,并故意按 ID 排序返回,制造“后端顺序与请求顺序不同”的情况。
import DataLoader from 'dataloader';
import {
  GraphQLID,
  GraphQLList,
  GraphQLNonNull,
  GraphQLObjectType,
  GraphQLSchema,
  GraphQLString,
  graphql,
} from 'graphql';

const users = [
  { id: 1, name: 'Ada' },
  { id: 2, name: 'Linus' },
];

const posts = [
  { id: 'p1', title: 'Batching', authorId: 2 },
  { id: 'p2', title: 'Resolvers', authorId: 1 },
  { id: 'p3', title: 'Caching', authorId: 2 },
];

async function queryUsersByIds(ids) {
  console.log(`[db] users by ids: ${ids.join(',')}`);
  // 模拟数据库不按请求顺序返回:这里固定按 id 升序。
  return users
    .filter((user) => ids.includes(user.id))
    .sort((a, b) => a.id - b.id);
}

function createUserLoader() {
  return new DataLoader(async (ids) => {
    const rows = await queryUsersByIds(ids);
    const byId = new Map(rows.map((row) => [row.id, row]));

    // DataLoader 要求结果位置与 ids 一一对应。
    return ids.map((id) => byId.get(id) ?? null);
  });
}

const UserType = new GraphQLObjectType({
  name: 'User',
  fields: {
    id: { type: new GraphQLNonNull(GraphQLID) },
    name: { type: new GraphQLNonNull(GraphQLString) },
  },
});

const PostType = new GraphQLObjectType({
  name: 'Post',
  fields: {
    id: { type: new GraphQLNonNull(GraphQLID) },
    title: { type: new GraphQLNonNull(GraphQLString) },
    author: {
      type: UserType,
      resolve: (post, _args, context) =>
        context.loaders.users.load(post.authorId),
    },
  },
});

const schema = new GraphQLSchema({
  query: new GraphQLObjectType({
    name: 'Query',
    fields: {
      posts: {
        type: new GraphQLNonNull(
          new GraphQLList(new GraphQLNonNull(PostType)),
        ),
        resolve: () => posts,
      },
    },
  }),
});

// DataLoader 放进本次 GraphQL 执行的 context,而不是进程级单例。
const result = await graphql({
  schema,
  source: '{ posts { id title author { id name } } }',
  contextValue: {
    loaders: {
      users: createUserLoader(),
    },
  },
});

console.log(JSON.stringify(result, null, 2));
预期输出
[db] users by ids: 2,1
{
  "data": {
    "posts": [
      {
        "id": "p1",
        "title": "Batching",
        "author": {
          "id": "2",
          "name": "Linus"
        }
      },
      {
        "id": "p2",
        "title": "Resolvers",
        "author": {
          "id": "1",
          "name": "Ada"
        }
      },
      {
        "id": "p3",
        "title": "Caching",
        "author": {
          "id": "2",
          "name": "Linus"
        }
      }
    ]
  }
}
这里只有一次作者批量访问,并且请求顺序 2,1 与模拟后端返回顺序 1,2 不同,最终仍能把正确作者回填到每篇文章。
让批处理真正生效
DataLoader 只能合并进入同一 loader、同一批次调度窗口的请求。GraphQL 的同级字段通常会并行解析,因此非常适合让 resolver 直接返回 loader.load() 的 Promise;如果业务代码自己写成串行循环,每次都先 await 一个加载再发起下一个加载,就会主动拆散批次。
另一个边界是批量大小。一次查询里可能出现成百上千个关联 ID 时,要结合数据库参数上限和查询计划设置合理的 maxBatchSize,而不是假设“批得越大越快”。衡量效果时应同时观察 GraphQL 请求数、批次大小和真实数据库查询次数。