
API 设计 / 系统课时
部署 GraphQL 服务与 Router
部署 GraphQL 服务与 Router
把 GraphQL 服务推到生产,不只是让容器能启动。本课把 Router 与 Subgraph 的生产边界、健康探针、超时预算、优雅关闭和滚动发布串成一条可验证链路,目标是升级时不接收异常流量,也尽量不丢失正在执行的请求。
学习目标
- 划分 Router、Subgraph 与平台基础设施的生产部署职责。
- 配置健康检查、分层超时与连接关闭策略。
- 使用 Kubernetes 滚动发布并验证新版本是否真正可接流量。
先确定生产部署边界
在联邦架构里,Router 应作为客户端看到的 GraphQL 入口,Subgraph 只暴露给内部网络。Router 负责查询计划、跨子图调用、入口级限流与超时;Subgraph 负责领域 Resolver、数据库连接和自身依赖。两层应独立扩缩容、独立回滚,避免一个子图升级迫使整个联邦同时发布。
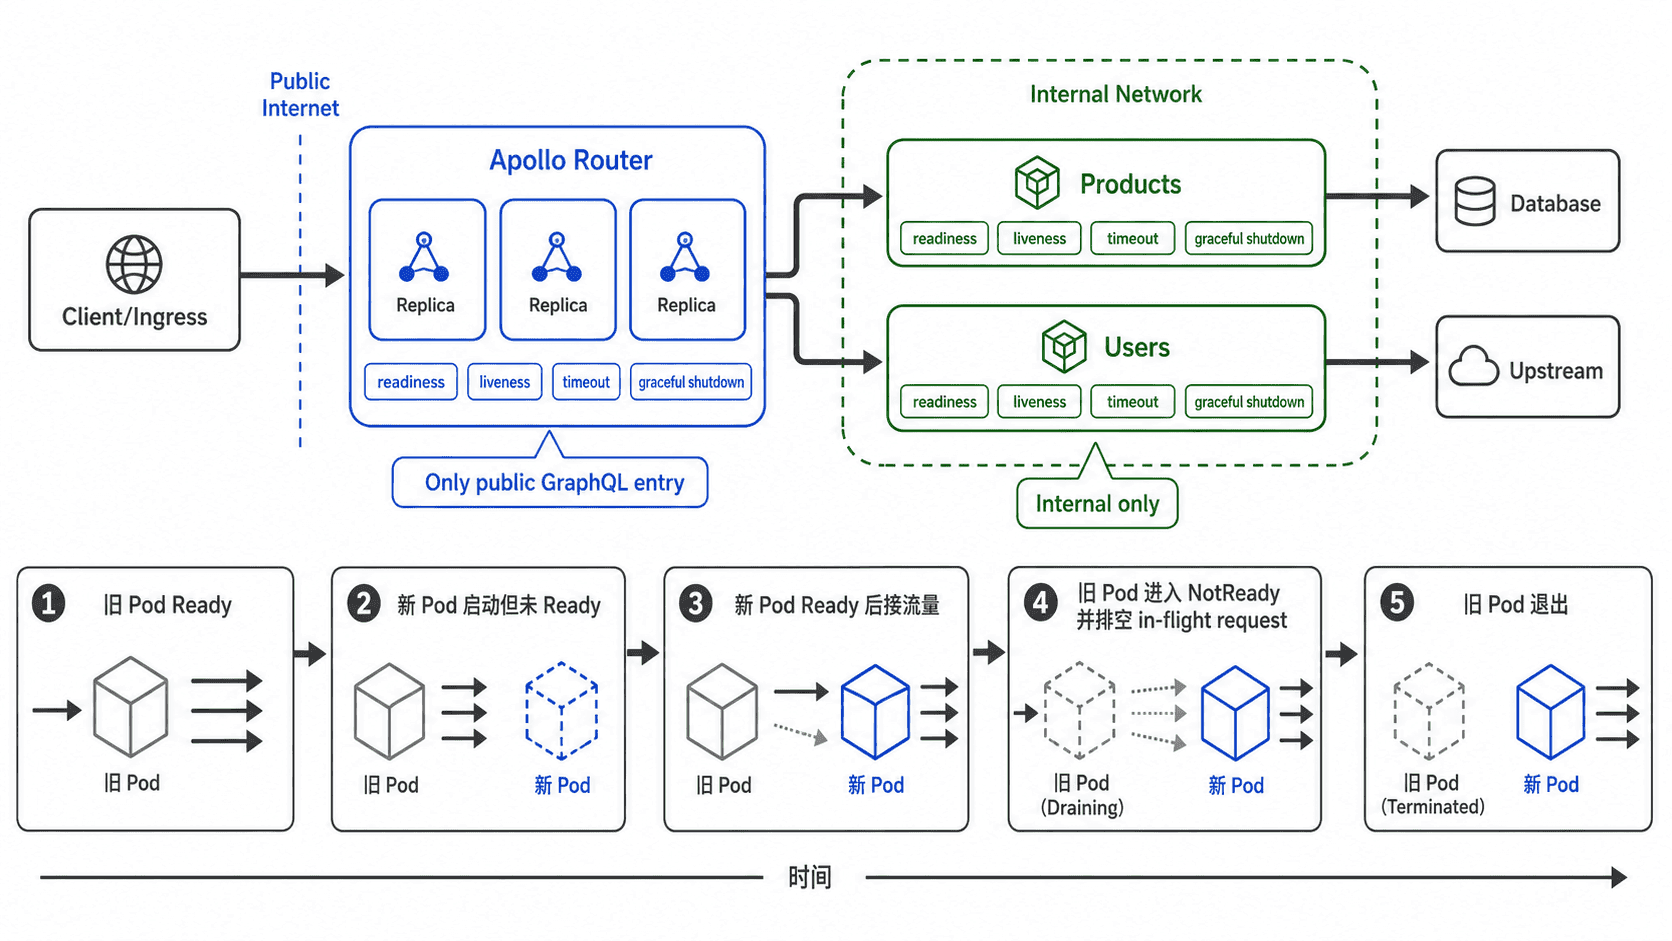
生产配置不要把环境差异写死进镜像。Router 配置、supergraph schema、证书和密钥应由部署系统注入,并与镜像版本一起可追溯;Subgraph 的数据库地址、连接池和第三方凭证同样通过 Secret 或等价机制管理。
配置 Router 的入口与超时
下面是一个可直接作为 router.yaml 起点的配置。数值是示例预算,真正上线前应根据服务 SLO 和压测结果调整;关键原则是 Router 总超时要大于单次 Subgraph 超时,给错误汇总和响应序列化留出余量。
# GraphQL 入口和健康端口分离,便于平台独立探测。
supergraph:
  listen: 0.0.0.0:4000
  path: /graphql
  introspection: false

health_check:
  enabled: true
  listen: 0.0.0.0:8088
  path: /health

# Router 总超时要大于单次 Subgraph 超时。
traffic_shaping:
  router:
    timeout: 3s
    concurrency_limit: 200
  all:
    timeout: 2s

include_subgraph_errors:
  all: false
生效行为是:Router 在 4000 端口提供 GraphQL 入口,在 8088 暴露健康检查;客户端请求最多占用 3 秒,单个 Subgraph 调用最多占用 2 秒,同时最多处理 200 个活动请求。生产环境还关闭 introspection,并避免把原始子图错误直接透传给客户端。
验证时先在非生产环境启动 Router,再分别访问 GraphQL 入口与健康端口。健康检查应成功,而超过超时预算的测试请求应在预算内终止,不能无限等待下游。
让 Pod 正确进入和退出流量
健康探针承担的职责不同:liveness 只回答“进程是否需要被重启”,readiness 回答“实例现在是否可以接新流量”。数据库短暂抖动时,通常应先让实例变为 NotReady,而不是立刻触发重启风暴。
退出顺序同样重要。收到终止信号后,实例应停止进入就绪状态,让负载均衡摘除它;随后停止接收新请求、等待 in-flight 请求完成,再关闭 HTTP、数据库连接池和遥测导出器。平台给出的 termination grace period 必须大于应用自身排空上限。
超时也要形成层级:外层负载均衡超时应略大于 Router 超时,Router 超时大于 Subgraph 超时,而 Subgraph 内部的数据库或 HTTP 调用还要更短。这样超时会在最接近根因的位置发生,上一层仍有时间返回可解释的错误。
执行滚动发布
Kubernetes 的滚动发布应保证“新副本 Ready 以后再减少旧副本”。常用策略是 maxUnavailable: 0、maxSurge: 1,并给 Router 和 Subgraph 都配置 readinessProbe、livenessProbe 与足够的 terminationGracePeriodSeconds。具体探针路径由各服务实现决定,Router 可使用独立健康端口。
下面的命令用于更新已存在的 Router Deployment。执行前把 <ROUTER_VERSION> 替换为实际镜像版本。
# 先替换版本占位符,再等待 Deployment 真正达到 Available。
ROUTER_IMAGE='ghcr.io/apollographql/router:<ROUTER_VERSION>'
kubectl -n graphql set image deployment/graphql-router router="$ROUTER_IMAGE"
kubectl -n graphql rollout status deployment/graphql-router --timeout=180s
kubectl -n graphql wait --for=condition=Available deployment/graphql-router --timeout=180s
预期输出
deployment.apps/graphql-router image updated
deployment "graphql-router" successfully rolled out
deployment.apps/graphql-router condition met
实际等待时间会随镜像拉取和探针状态变化。若 rollout status 超时,不要继续发布 Subgraph;先检查新 Pod 是否因配置、supergraph、探针或依赖失败而无法 Ready。确认版本异常时,使用部署平台的回滚能力恢复上一稳定 ReplicaSet。
把发布验证变成门禁
一次成功发布至少要同时满足三类证据:Pod 全部 Ready 且旧实例已退出;代表性 GraphQL 查询成功且错误率没有抬升;Router、Subgraph、数据库的延迟与连接数没有出现异常尖峰。只看“镜像已更新”不足以证明发布成功。
更稳妥的顺序是先发布一个低流量环境或少量副本,观察完整超时窗口,再扩大比例。Router 和 Subgraph 独立发布时,每一步都要验证 composition 兼容性和实际请求链路;这样即使某个领域版本有问题,也能在影响扩大前停止或回滚。