
API 设计 / 系统课时
理解规范化缓存身份
理解规范化缓存身份
同一实体常会被列表、详情页和关联字段重复查询。规范化缓存的目标,是把这些结果识别为同一个对象并合并字段,避免保存多份互相矛盾的数据;本节用 Apollo Client 的 InMemoryCache 说明身份键、字段键以及合并边界。
学习目标
- 解释
__typename与主键如何组成实体缓存身份 - 区分实体身份键与查询字段键的职责
- 判断不同查询结果何时会自动合并、何时需要自定义策略
规范化缓存解决什么问题
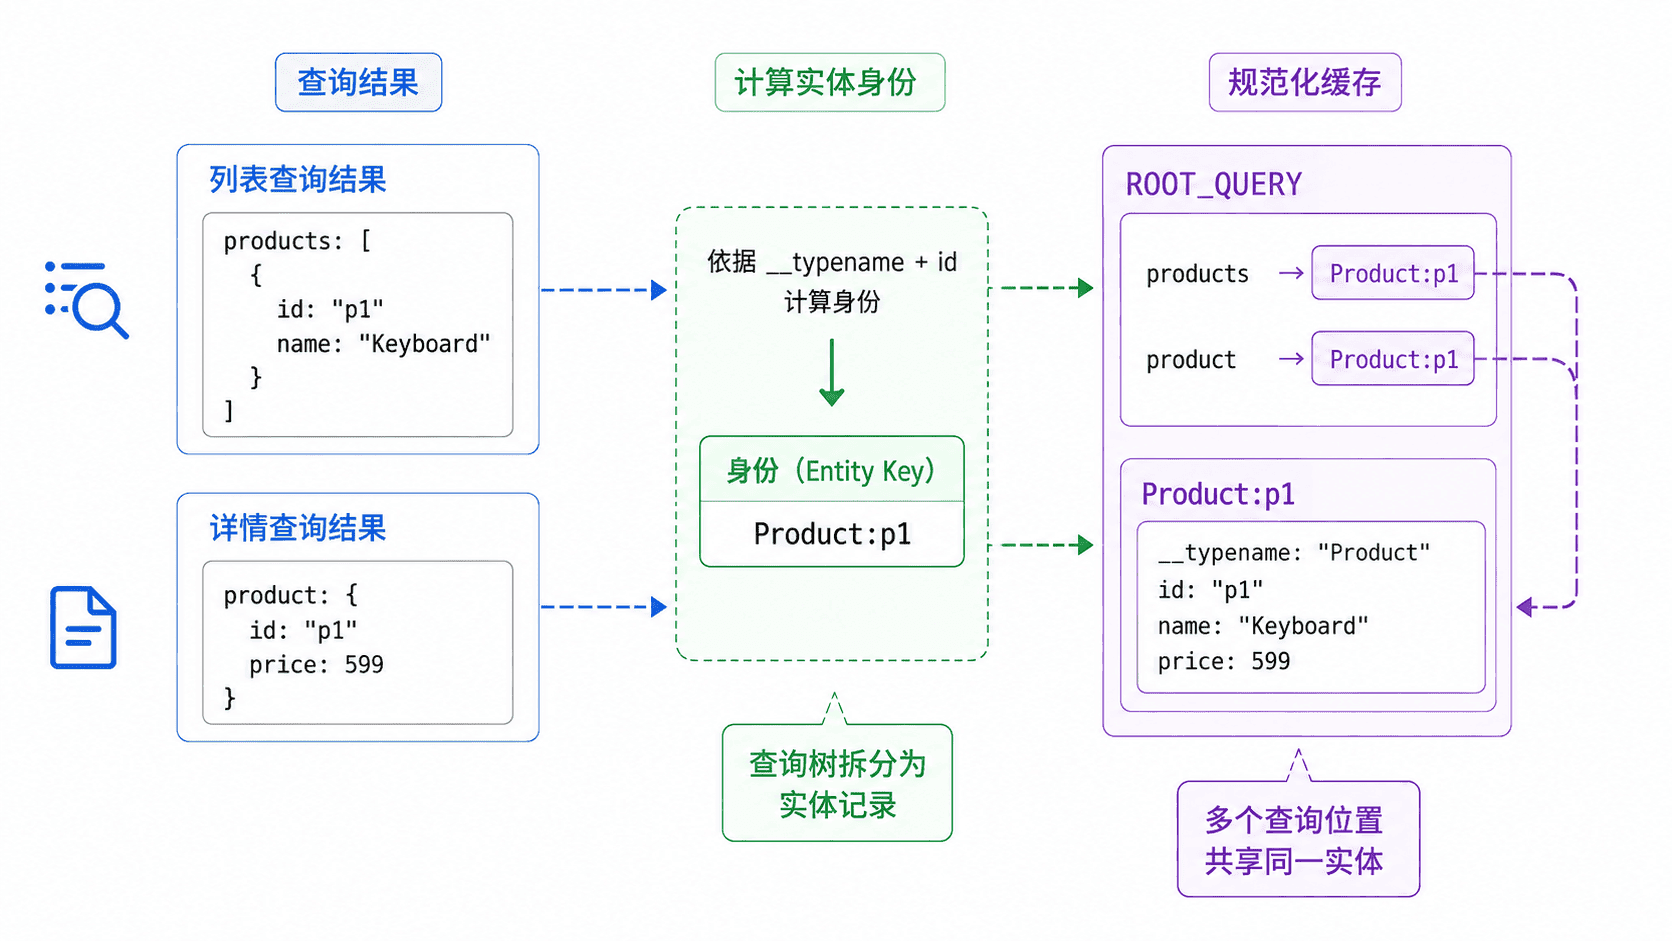
GraphQL 响应天然是树,但客户端状态更适合按实体保存。若列表查询拿到 Product{id,name},详情查询又拿到 Product{id,price},缓存只要确认两者代表同一个商品,就能把 name 与 price 合并到同一条记录,再让不同查询位置引用这条记录。
Apollo Client 的默认实体身份通常由 __typename 与 id 组成,例如 Product:p1。如果类型没有 id,也可以通过 typePolicies.keyFields 指定业务主键;若无法得到稳定身份,对象通常只能作为父字段中的嵌套值保存,跨查询合并能力会明显下降。
用一个主示例观察字段合并
下面示例先写入商品名称,再通过另一条查询写入价格。两个结果都包含相同的 __typename 和 id,因此缓存会定位到同一实体记录。
import { InMemoryCache, gql } from "@apollo/client";

const cache = new InMemoryCache();

// 第一次查询只提供实体的名称字段。
cache.writeQuery({
  query: gql`
    query ListProduct {
      product {
        __typename
        id
        name
      }
    }
  `,
  data: {
    product: { __typename: "Product", id: "p1", name: "Keyboard" },
  },
});

// 第二次查询用相同身份补充价格字段。
cache.writeQuery({
  query: gql`
    query ProductDetail {
      product {
        __typename
        id
        price
      }
    }
  `,
  data: {
    product: { __typename: "Product", id: "p1", price: 599 },
  },
});

// 直接按规范化身份读取,验证两个查询写入的字段已经合并。
const cacheId = cache.identify({ __typename: "Product", id: "p1" });
const merged = cache.readFragment({
  id: cacheId,
  fragment: gql`
    fragment ProductFields on Product {
      name
      price
    }
  `,
});

console.log(cacheId);
console.log(merged?.name, merged?.price);
预期输出
Product:p1
Keyboard 599
这里的关键不是两次查询名称相同,而是两次响应里的实体身份相同。查询可以来自完全不同的页面,只要最终指向 Product:p1,实体字段就能汇合。
实体身份与字段键不要混淆
实体身份回答“这是谁”,字段键回答“这个查询位置是哪一个字段”。例如 product(id: "p1") 与 product(id: "p2") 默认会因为参数不同而形成不同的查询字段键,但它们各自仍可引用规范化后的 Product:p1、Product:p2。
分页字段尤其容易混淆。像 products(offset: 0) 与 products(offset: 20) 默认是两个字段键;如果希望把分页结果拼成一个列表,需要通过 keyArgs 和 merge 明确哪些参数参与字段身份,以及新旧页怎样合并。实体字段自动合并不等于列表分页自动拼接。
身份设计的边界
稳定主键必须真正唯一且长期不变。把商品名称、数组下标或会变化的 slug 当作主键,可能让两个实体被错误合并,或让同一实体不断生成新记录。复合业务键可以使用 keyFields,但字段组合必须能在所有相关查询中稳定取得。
理解缓存身份后,调试缓存异常时先检查实体键,再检查查询字段键和字段合并策略,通常比盯着某个组件的渲染结果更快定位问题。