
API 设计 / 系统课时
设计 Connection 分页模型
设计 Connection 分页模型
Connection 把“列表项”和“翻页状态”拆成稳定的接口结构:客户端只保存不透明 cursor,就能持续向后读取,同时给未来增加边级元数据、双向分页和分页状态留出空间。本篇完成一套可直接落地的 Connection Schema,并说明游标稳定性的关键约束。
学习目标
- 设计包含
Connection、Edge与PageInfo的列表接口 - 使用
first、after和endCursor完成连续翻页 - 让 cursor 与稳定排序绑定,避免并发写入造成重复或漏项
为什么列表不要只返回数组
直接返回 [Product!]! 只能表达“这一批有什么”,无法同时携带下一页位置、是否还有数据,以及“节点与当前列表关系”上的元数据。传统 offset + limit 又依赖当前位置;当第一页读取后有新记录插入,第二页的偏移量可能已经指向不同数据,从而产生重复或漏项。
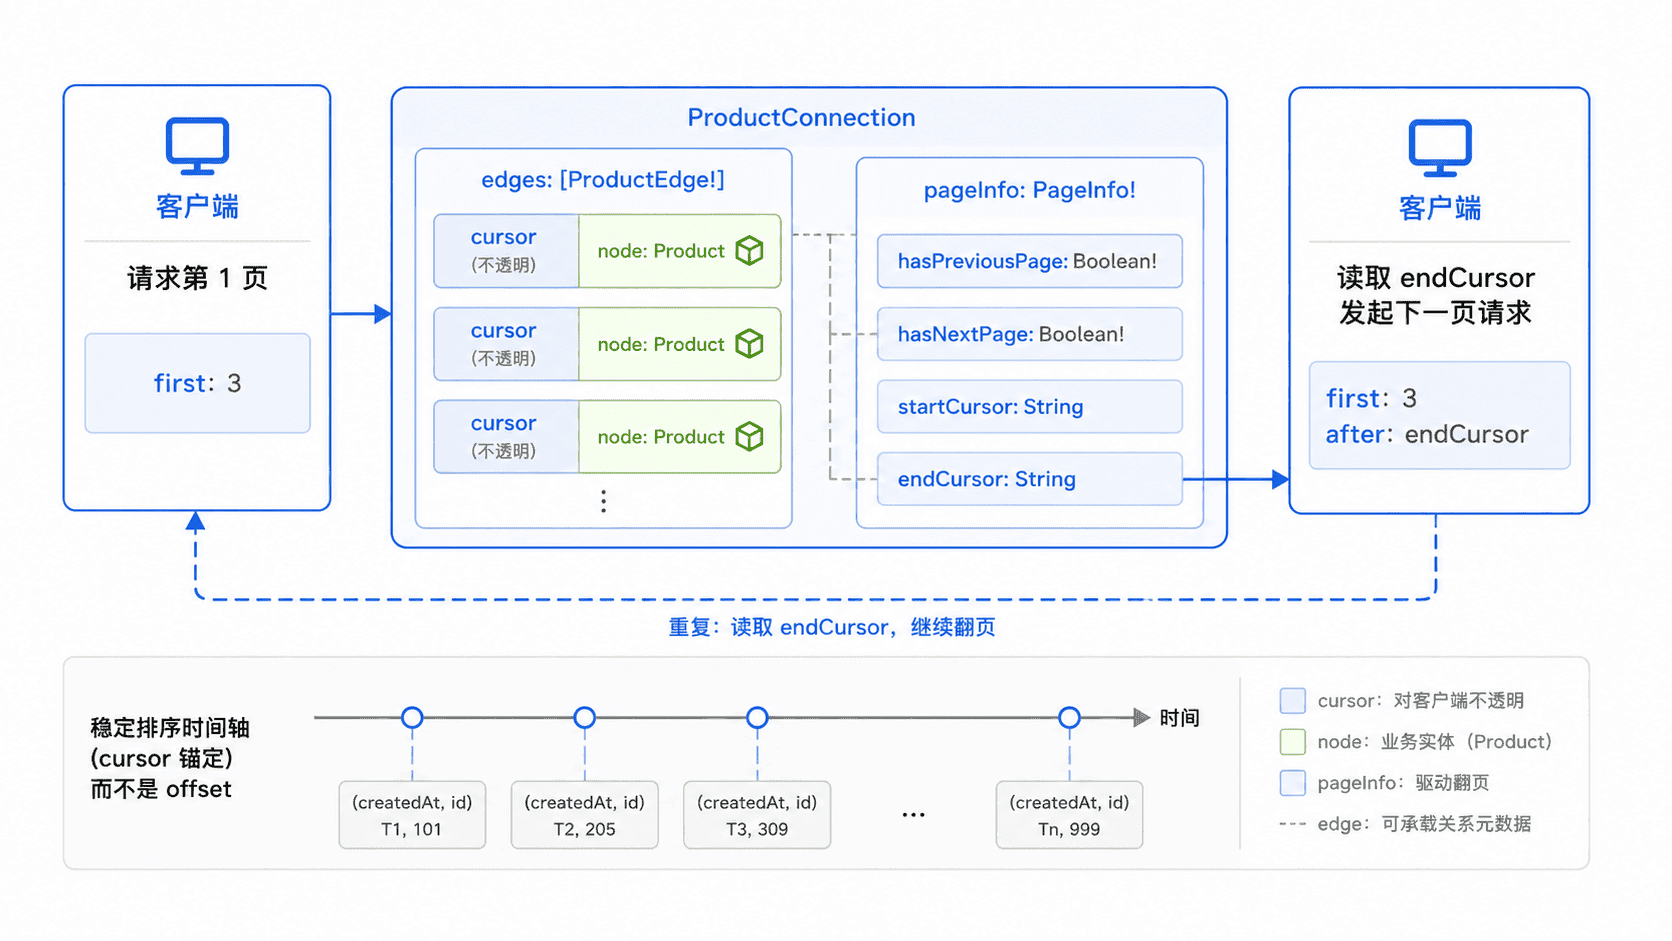
Connection 模型把职责拆成三层:Connection 表示一次列表窗口,Edge 把节点与对应 cursor 绑定,PageInfo 描述继续翻页所需状态。客户端因此不需要知道数据库主键、排序字段或游标编码方式。
定义可演进的 Connection
下面的 SDL 借鉴 Relay Cursor Connections 的核心约定,只实现向后分页。totalCount 没有放进基础结构,因为它在大数据集上可能昂贵;确有产品需求时再作为可选字段增加。
type Query {
  # first 有默认值,并由服务端限制最大页大小
  products(first: Int! = 20, after: String): ProductConnection!
}

# Connection 保存当前窗口和继续翻页所需状态
type ProductConnection {
  edges: [ProductEdge!]!
  pageInfo: PageInfo!
}

type ProductEdge {
  # cursor 描述 node 在当前稳定排序中的边界位置
  cursor: String!
  node: Product!
}

type PageInfo {
  hasNextPage: Boolean!
  hasPreviousPage: Boolean!
  startCursor: String
  endCursor: String
}

type Product {
  id: ID!
  name: String!
  createdAt: String!
}
edges 适合以后增加 rank、matchedReason 等“节点与当前结果集之间”的信息;这类字段不应塞进 Product。startCursor 与 endCursor 在空结果时可以为 null,因此不要声明成非空。
用 cursor 完成连续翻页
服务端部署上述 Schema 后,可以用同一个查询反复取页。首次请求把 after 设为 null;之后把上一页返回的 pageInfo.endCursor 原样作为下一次的 after。
# <PORT> 替换为本地 GraphQL 服务端口。
GRAPHQL_URL="http://localhost:<PORT>/graphql"

# 首次请求 after=null,后续请求复用上一页 endCursor。
curl -sS "$GRAPHQL_URL" \
  -H 'content-type: application/json' \
  --data-binary @- <<'JSON'
{
  "query": "query ProductsPage($first: Int!, $after: String) { products(first: $first, after: $after) { edges { cursor node { id name } } pageInfo { hasNextPage endCursor } } }",
  "variables": {
    "first": 2,
    "after": null
  }
}
JSON
预期输出
{
  "data": {
    "products": {
      "edges": [
        {
          "cursor": "<CURSOR_1>",
          "node": {
            "id": "<ID_1>",
            "name": "Keyboard"
          }
        },
        {
          "cursor": "<CURSOR_2>",
          "node": {
            "id": "<ID_2>",
            "name": "Mouse"
          }
        }
      ],
      "pageInfo": {
        "hasNextPage": true,
        "endCursor": "<CURSOR_2>"
      }
    }
  }
}
实际 cursor 和 ID 会因数据而不同。第二页只需要把请求变量中的 after 改为 <CURSOR_2>;客户端不要解码、拼接或修改 cursor,否则服务端未来调整编码格式时会破坏兼容性。
让游标真正稳定
cursor 最重要的不是“加密”,而是能唯一表示排序边界。假设列表按 createdAt DESC 排序,仅保存时间戳并不够,因为多条记录可能同一时刻创建;应再加唯一的 id 作为稳定的决胜字段,使排序成为 createdAt DESC, id DESC,cursor 则编码这两个值。
服务端处理 after 时,应在同一过滤条件和同一排序规则下寻找“严格位于该边界之后”的记录,再多取一条判断 hasNextPage,同时对 first 设置合理上限。不要把 offset 只是 Base64 一次后称为 cursor:底层仍是位置分页,并发插入或删除时仍会漂移。
当列表需要向前翻页时,再对称增加 last 与 before;当需要总数、节点快捷数组或边级业务字段时,也可以在 Connection 上做增量扩展。只要保持 cursor 语义稳定,客户端就能持续翻页,而服务端仍保留调整存储和索引实现的空间。