
半导体与芯片 / 系统课时
验证 DMA 从外设到 DDR 的数据流
验证 DMA 从外设到 DDR 的数据流
外设数据搬进 DDR 后,收到中断仍不足以证明 CPU 读到了本轮数据。本篇用一帧 4096 字节的单次 DMA 接收,建立地址、写响应、完成通知和缓存可见性的验收链,并计算吞吐与延迟。
学习目标
- 用带帧号的数据核对固定源地址、递增目的地址与完整接收长度。
- 按 Linux 6.6 DMAengine 与 DMA API 的顺序交接缓冲区所有权。
- 运行离线验收器,识别数据损坏和提前通知,计算吞吐与延迟。
固定一帧与实验边界
上板需要 Linux 6.6、已适配 DMAengine 的外设驱动,以及可输出已知数据的 FIFO 测试源;离线示例只需 Python 3.8 或更新版本。先按 SoC 手册确认 FIFO 地址、DMA 请求线、时钟和完成条件。
| 项目 | 本次实验设置 |
|---|---|
| 帧长 | 1024 个 32 位小端字,共 4096 B |
| 数据模式 | 高 16 位为帧号,低 16 位为字序号;每轮更新帧号 |
| 地址方式 | FIFO 源地址固定;DDR 目的地址递增 |
| 通知方式 | 单通道、单描述符、非循环,关闭中断合并;只统计归属于该通道的完成通知 |
| 运行条件 | DMA 就绪后再触发一帧;外设溢出计数和 DMA 错误状态都必须为 0 |
第 i 字按 (frame_id << 16) | i 生成,i 从 0 到 1023,同时检查内容、位置和帧号。只核对长度会漏掉上一帧残留。教学帧号为 7,首字应为 0x00070000,末字应为 0x000703ff。
配置地址与传输
确认接收区来自平台 DDR 的普通系统 RAM,DMA 驱动已按硬件能力设置地址掩码。用 kmalloc(4096, GFP_KERNEL) 分配独立接收区并检查失败,避免与 CPU 修改的变量共享缓存行。CPU 指针、物理地址与 DMA 地址可能不同;目的地址必须取自 DMA 映射,不能用 virt_to_phys() 代替。genui{"citation":{"ref":"turn2view0"}}
- 用
dma_request_chan(dev, "rx")申请通道;"rx"须匹配实际设备描述。再用dmaengine_get_dma_device(chan)取得后续映射使用的dma_dev。 - 用
dmaengine_slave_config()设置 DMA 可见的 FIFOsrc_addr。若平台支持 32 位访问、源端最大突发 1 字的基线配置,设置src_addr_width = DMA_SLAVE_BUSWIDTH_4_BYTES、src_maxburst = 1;这些参数描述外设端。 - 调用
dma_map_single(dma_dev, buf, 4096, DMA_FROM_DEVICE),用dma_mapping_error()检查结果。映射成功后,CPU 停止访问接收区。 - 用
dmaengine_prep_slave_single()准备 4096 B,方向为DMA_DEV_TO_MEM,标志为DMA_PREP_INTERRUPT | DMA_CTRL_ACK。检查描述符非空,设置回调,调用dmaengine_submit()并检查dma_submit_error()。 - 调用
dma_async_issue_pending(),随后按外设协议使能请求和测试源。仅提交描述符不会启动 DMA。genui{"citation":{"ref":"turn2view1"}}
映射方向 DMA_FROM_DEVICE 与描述符方向 DMA_DEV_TO_MEM 属于不同接口,不能混用。映射、同步和解除映射均使用同一个 dma_dev。
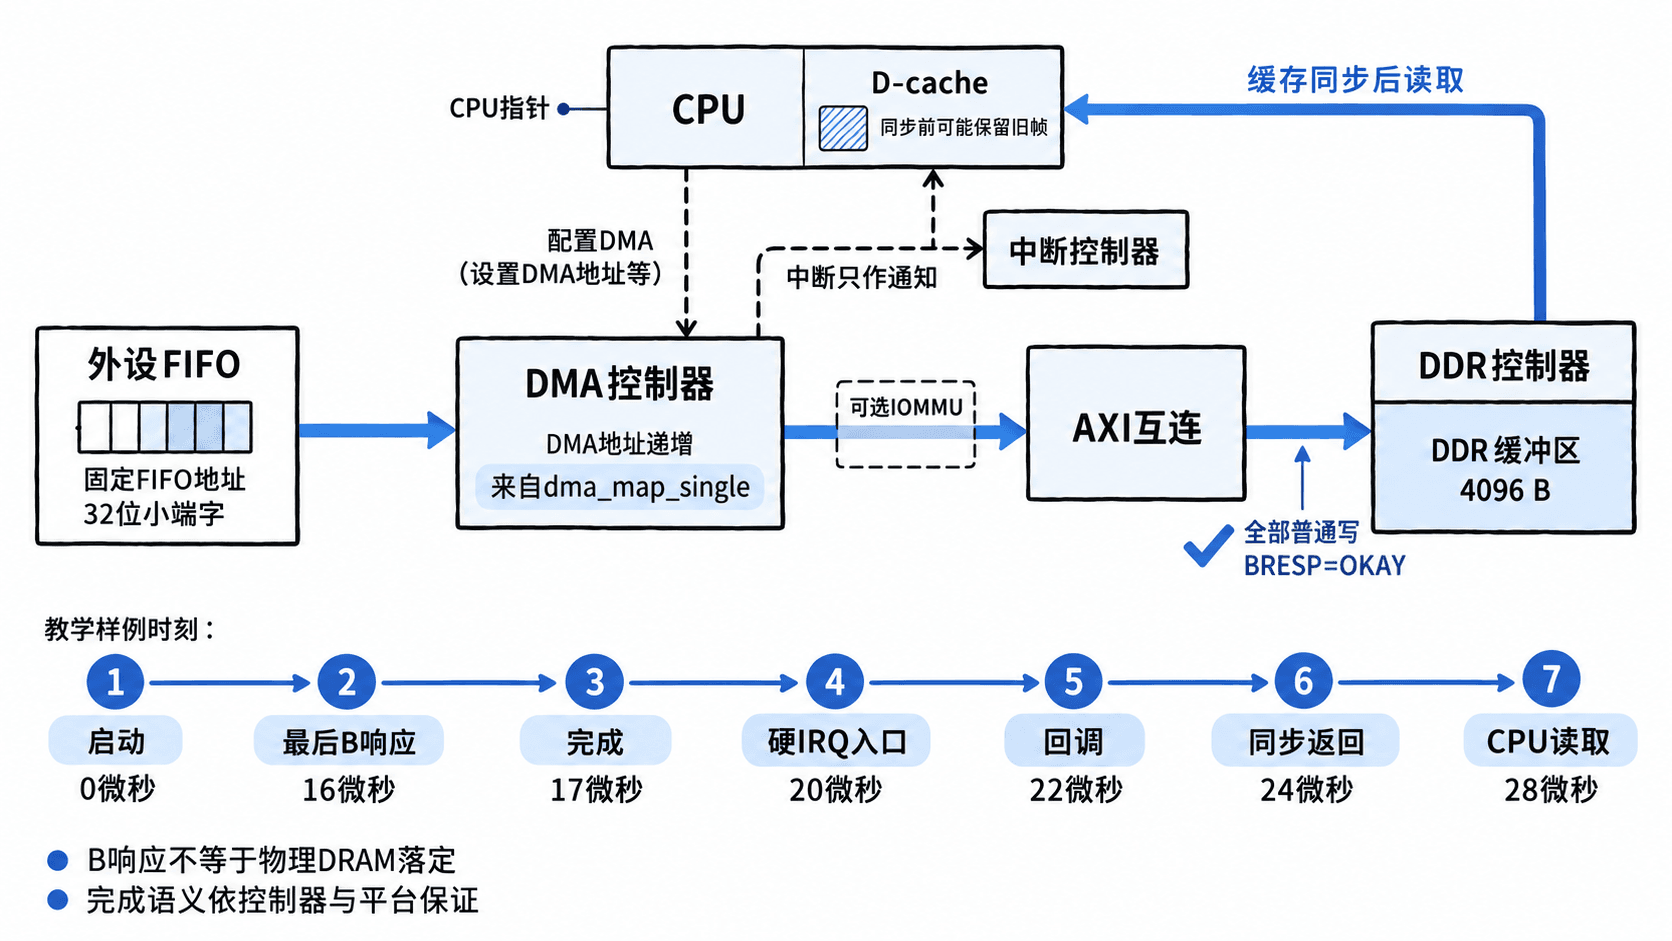
分开检查完成与可见性
在 RTL 仿真或 FPGA ILA 的 DMA 主端采集本帧 AW/W/B。AXI4 的 W 数据按写事务顺序归属,B 响应按 ID 及同 ID 顺序匹配 AW。只在 WVALID && WREADY 时累计 WSTRB 指定的有效字节;用 BVALID && BREADY 统计响应,用 AWVALID && AWREADY 统计请求,两者笔数相等,普通写的 BRESP 全为 0。每笔 AXI 突发不能跨 4 KiB 边界。genui{"citation":{"ref":"turn5view1"}}
WLAST 只标记一笔突发的末拍。即使全部 B 响应成功,也要确认控制器整笔传输完成且无错误;可缓冲写的响应不能解释为物理 DRAM 单元已写入。本实验采用全部写响应返回后才产生成功完成通知的验收约定。genui{"citation":{"ref":"turn3view2"}}
硬 IRQ 入口与 DMAengine 回调分别记录时间,回调不是硬 IRQ 入口。genui{"citation":{"ref":"turn2view1"}}
本实验保留 streaming 映射:成功完成后调用 dma_sync_single_for_cpu(dma_dev, dma_addr, 4096, DMA_FROM_DEVICE),返回后 CPU 才能只读校验。校验完再 dma_unmap_single(),沿用映射时的地址、长度和方向;若保留映射复用,重新交给设备前调用 dma_sync_single_for_device()。genui{"citation":{"ref":"turn3view0"}}
运行带反例的验收器
将代码保存为 dma_check.py,运行 python3 dma_check.py。sample 是自定义教学记录,地址与相对微秒均为构造值;64 笔各 64 B 只是样例分段,实际分段由控制器决定。它验证验收逻辑,不代表当前电脑执行了真实 DMA。
status 记录随后对本次 cookie 调用 dmaengine_tx_status() 得到的枚举名;dma_error、fifo_overrun 记录本轮 DMA 错误与外设溢出。irq_count 只数确认属于本通道的完成事件,不能直接取共享 IRQ 的总增量。
实测时替换全部观测字段。rx 必须来自同步后的 CPU 缓冲区;writes 每项为地址、连续有效字节数、响应码,尚无响应记 None。原始握手与字节选通由监视器另行核对,不能只导出成功事务。
us 依次记录启动、最后 B 握手、硬件成功完成、硬 IRQ 入口、回调、同步返回和 CPU 首次读取;done 是硬件完成事件,不是 Linux cookie 状态更新时间。硬件周期与软件时间戳须先校准到同一时间基准,不能直接相减。
from copy import deepcopy
from struct import pack, unpack

SIZE, WORDS = 4096, 1024

def require(ok, reason):
    if not ok:
        raise ValueError(reason)

def verify(r):
    require(r["status"] == "DMA_COMPLETE", "STATUS")
    require(r["dma_error"] == 0 and r["fifo_overrun"] == 0, "DEVICE_ERROR")
    require(len(r["rx"]) == SIZE, "LENGTH")
    pos = r["dma_addr"]
    # 按地址检查连续覆盖;排序不代表总线响应的先后顺序。
    for addr, count, bresp in sorted(r["writes"], key=lambda row: row[0]):
        require(addr == pos and count > 0, "ADDRESS")
        require(addr // 4096 == (addr + count - 1) // 4096, "BOUNDARY")
        require(bresp == 0, "BRESP")
        pos += count
    require(pos == r["dma_addr"] + SIZE, "COVERAGE")
    require(r["irq_count"] == 1, "IRQ")
    # us 中的硬件与软件事件已经换算到同一时间基准。
    names = ("start", "last_b", "done", "irq", "callback", "sync", "read")
    times = [r["us"][name] for name in names]
    require(all(a <= b for a, b in zip(times, times[1:])), "ORDER")
    require(times[1] > times[0], "CLOCK")
    expected = tuple((r["frame"] << 16) | i for i in range(WORDS))
    require(unpack("<1024I", r["rx"]) == expected, "DATA")
    return SIZE / (times[1] - times[0]), times[5] - times[0]

def main():
    # 下面是构造的教学输入;实际验收须替换为采集记录。
    base, frame = 0x20000000, 7
    sample = {
        "dma_addr": base, "frame": frame, "status": "DMA_COMPLETE",
        "rx": pack("<1024I", *((frame << 16) | i for i in range(WORDS))),
        "writes": [(base + off, 64, 0) for off in range(0, SIZE, 64)],
        "irq_count": 1, "dma_error": 0, "fifo_overrun": 0,
        "us": {"start": 0, "last_b": 16, "done": 17, "irq": 20,
               "callback": 22, "sync": 24, "read": 28},
    }
    # 两个反例证明错误数据和过早中断不会被放行。
    bad_data = deepcopy(sample)
    damaged = bytearray(bad_data["rx"])
    damaged[20] ^= 1
    bad_data["rx"] = bytes(damaged)
    early_irq = deepcopy(sample)
    early_irq["us"]["irq"] = 15
    for label, record in (("normal", sample), ("bad_data", bad_data),
                          ("early_irq", early_irq)):
        try:
            rate, latency = verify(record)
            print(f"{label}: PASS bytes={SIZE} bus={rate:.2f} MB/s ready={latency} us")
        except ValueError as error:
            print(f"{label}: REJECT {error}")

if __name__ == "__main__":
    main()
预期输出:
normal: PASS bytes=4096 bus=256.00 MB/s ready=24 us
bad_data: REJECT DATA
early_irq: REJECT ORDER
记录吞吐并定位长等待
总线完成窗口为 16 μs,所以有效吞吐为 4096 ÷ 16 = 256 MB/s;CPU 可读窗口截止同步返回,共 24 μs,对应约 170.67 MB/s。这里 MB/s 使用十进制,CPU 可读延迟是 24 μs,两种吞吐均不代表 DDR 峰值带宽。
样例中硬件在 17 μs 完成,20 μs 进入 IRQ,因此中断响应延迟为 3 μs;22 μs 执行回调,24 μs 同步返回。软件点可用 ktime_get_ns() 记录,硬件观测点必须经过时基校准后才能参与计算。
| 观察结果 | 下一步检查 |
|---|---|
| 地址覆盖或边界检查失败 | 核对映射返回值、长度、地址宽度及 IOMMU 故障记录 |
| 写入窗口长 | 同时统计 FIFO 空等待和 WVALID && !WREADY 周期,区分源供数不足与下游背压 |
| 完成早,IRQ 或回调晚 | 检查中断屏蔽、目标 CPU 负载与延后处理调度 |
| 通知正常,数据比较失败 | 核对帧号、字节序、外设溢出及缓存所有权交接顺序 |
上板先验证单帧,再更新帧号连续测 1000 帧,要求零数据错误、零 DMA 错误、零外设溢出。总吞吐用 4,096,000 B 除以整段耗时,包含帧间空隙;将 1000 个 CPU 可读延迟排序,按最近秩法取第 500、990 项作为 P50、P99。缺少 AXI 观测时,只能确认端到端数据验收,协议层检查仍需补齐。