
半导体与芯片 / 系统课时
DDR 控制器为何会重排请求
DDR 控制器为何会重排请求
CPU 发出的 DDR 读请求,即使先进入控制器,也不一定先访问存储阵列。通过分析同一 Bank 的三笔请求,你将看懂行缓冲命中、DRAM 时序和队列调度怎样共同决定执行顺序,以及吞吐提升可能付出的等待代价。
学习目标
- 区分行命中、关闭行未命中与行冲突,说明相关时序开销。
- 用三笔读请求算出 FIFO 与行命中优先调度的行切换次数。
- 判断重排改善吞吐的条件,以及公平性和可见顺序的限制。
为什么先进队列的请求不一定先执行
DDR 控制器把 CPU、DMA 等发来的读写事务映射到通道、Rank、Bank、行和列,再放进待调度队列。一个 Bank 在常规工作状态下只能保持一个已激活的行;请求若访问该行,可以直接发出列读命令 RD,称为行命中。
如果 Bank 未打开任何行,访问前需要 ACT 激活目标行;如果已打开另一行,就形成行冲突,通常要先 PRE 预充电关闭旧行,再 ACT 打开新行,最后 RD。这些命令之间不能随意压缩等待时间。
| 约束 | 含义 | 本文演算取值 |
|---|---|---|
tRP |
PRE 到后续 ACT 的最短间隔 |
16 CK |
tRCD |
ACT 到列读 RD 的最短间隔 |
16 CK |
tCL |
RD 到首批读数据的列延迟 |
16 CK |
取值仅用于演算,不代表某款 DDR 的配置。相对于已就绪的行命中,一次需要 PRE、ACT 的行冲突增加的基本命令准备时间为 16 + 16 = 32 CK;实际还受 tRAS(最短开行时间)、列命令间隔 tCCD、突发传输及其他约束影响,不能直接把 32 CK 当作整笔请求的实测延迟差。
三笔请求为什么会交换先后
假设三个相互独立的读请求都已排队,目标均为 Bank 0,且该 Bank 初始打开 Row 5。
| 请求 | 入队顺序 | 目标行 | 初始状态 |
|---|---|---|---|
| A | 1 | Row 5 | 行命中 |
| B | 2 | Row 9 | 行冲突 |
| C | 3 | Row 5 | 行命中 |
严格 FIFO 按 A、B、C 处理:A 命中 Row 5,B 切到 Row 9,C 又切回 Row 5,合计 1 次行命中、2 次行切换。若控制器在满足时序的前提下优先选择就绪的行命中,则顺序可变为 A、C、B,得到 2 次行命中、1 次行切换。
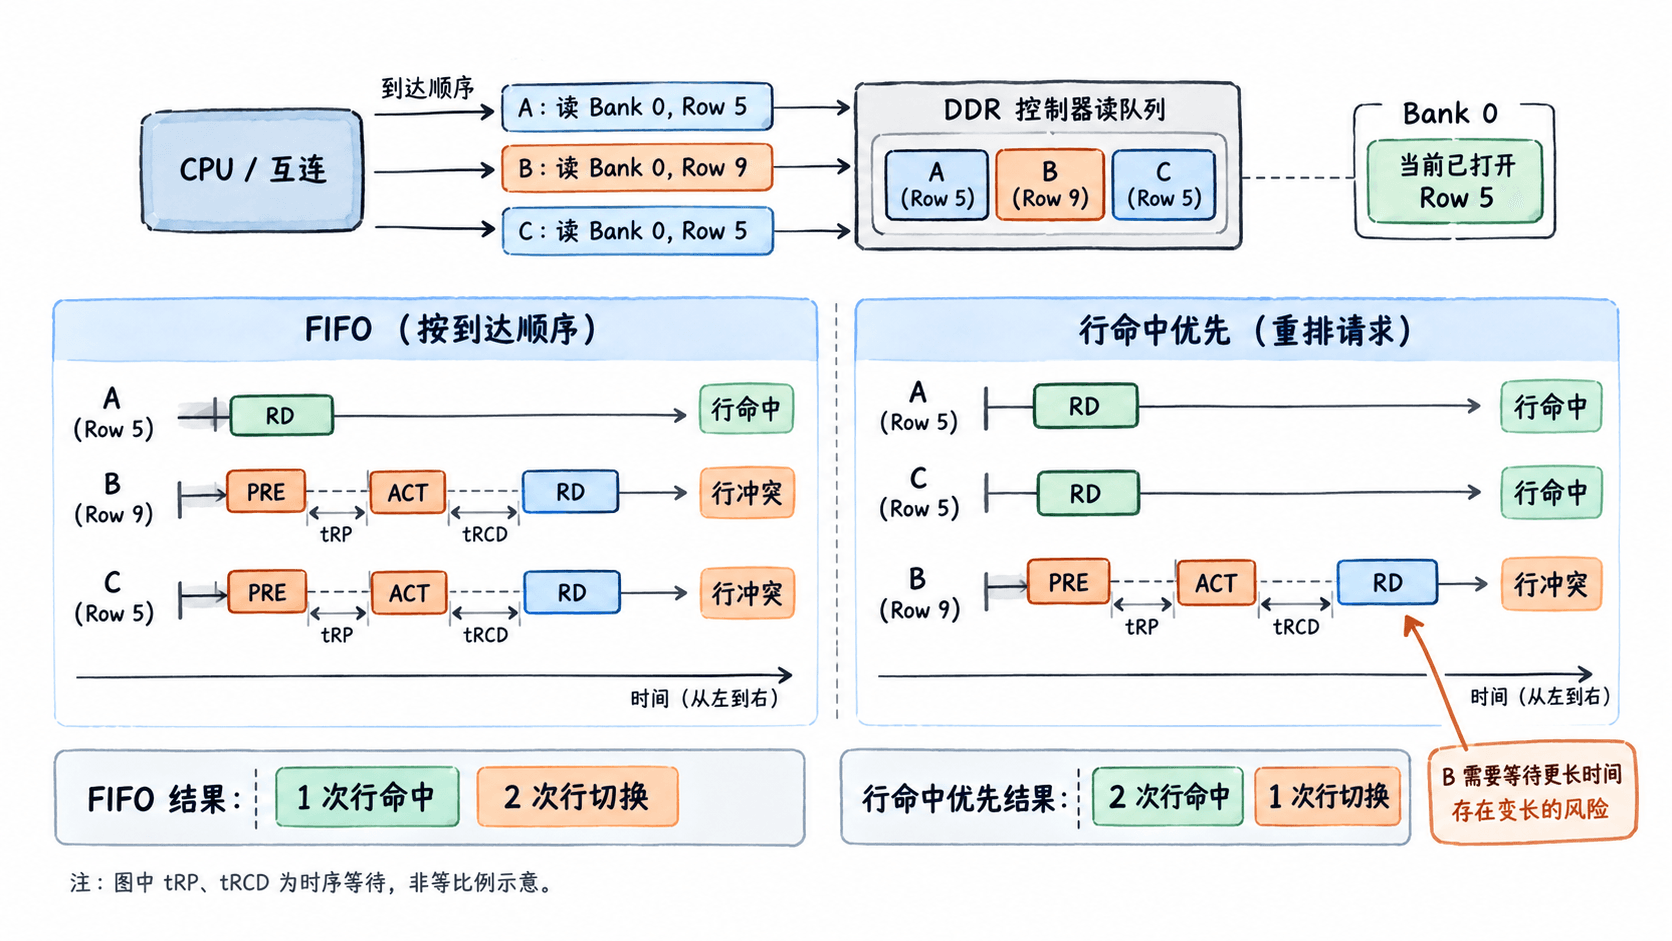
这里减少一次 PRE 加 ACT,但 B 必须等 C 完成相关命令后才能得到服务。行命中率从 1/3 升至 2/3,不表示每笔请求延迟都下降:C 可能更快,B 可能更慢;实际吞吐还取决于数据总线是否持续有可发送的突发。
控制器如何兼顾就绪、吞吐与公平
常见的 FR-FCFS(First-Ready, First-Come First-Served) 思路,是优先处理时序上可以尽早发出的请求,尤其是行命中;同等条件下再照顾较早到达者。这不是无条件让所有行命中插队:调度器仍须遵守 tRAS、tRP、tRCD、tCCD、刷新限制及读写切换约束。
在多 Bank 场景中,控制器还能让一个 Bank 执行预充电或激活准备,同时在另一个已就绪的 Bank 发出列命令,以隐藏部分等待。写请求较多时,部分实现会集中排空写队列,减少读写方向切换;代价可能是读请求排队延长。
持续偏向热门行会让冷门行挨饿,因此实际调度器通常需要等待年龄、公平性或 QoS 约束。以设计规则为例,可以在请求等待超过 64 个控制器周期后提高其优先级;这是示意性的策略参数,不是 JEDEC 规定的统一阈值。
物理 DRAM 命令被重排,也不意味着 CPU 能看到违反协议的结果。控制器和互连必须维护事务标识、必要的响应顺序及屏障语义;例如 AXI4 同 ID 事务有保序要求,不同 ID 的独立事务则可能乱序完成。即使 C 先从 DRAM 取到数据,接口上仍可能需要缓冲结果,等待先前同 ID 事务完成。
怎样衡量重排是否真的有效
比较调度策略时,应使用同一地址映射和请求轨迹,同时记录行命中率、读请求平均及 P99 延迟、有效数据带宽、队列等待时间。只看行命中率,容易漏掉 B 这类被推迟的请求;只看平均延迟,又可能掩盖少量 CPU 关键读的长尾。
若请求队列长期只有 1 笔待处理事务,控制器几乎没有重排空间;若 DMA 连续访问同一行且队列中还有其他行的请求,行命中优先才更有机会减少切换。工程上应同时验收带宽和最坏等待表现,必要时通过读写优先级、年龄提升或 QoS 限额保护延迟敏感的 CPU 请求。