
半导体与芯片 / 系统课时
AXI4 事务 ID 如何限制乱序返回
AXI4 事务 ID 如何限制乱序返回
当 AXI4 主设备同时发出多笔读写请求时,响应不一定按照请求发起的先后顺序到达。本篇通过三笔并发读事务,分析 ID 如何约束响应顺序,并用一个可运行的检查程序判断哪些响应序列合法、哪些违反协议。
学习目标
- 区分事务 ID、Outstanding Transaction 与事务完成条件。
- 判断相同 ID 和不同 ID 的读写响应顺序是否合法。
- 使用每 ID 队列检查读响应,并理解跨读写通道的顺序边界。
ID 与 Outstanding Transaction 的关系
AXI4 允许主设备在前一笔事务尚未完成时继续发出请求。这类已经发起、尚未完成的事务称为 Outstanding Transaction(未完成事务)。它们使主设备可以隐藏存储器访问延迟,提高互连利用率。
例如,某主设备在连续三个周期完成 AR 握手,发出三笔读请求,而第一笔读数据直到第四个周期才返回。此时最多有三笔未完成读事务,并不需要等待第一笔返回后才能发起第二笔。
AXI4 使用四个关键信号关联请求与响应:
| 请求通道及 ID | 响应通道及 ID | 事务完成条件 |
|---|---|---|
| AR 通道:ARID | R 通道:RID | RVALID、RREADY、RLAST 同时为 1 |
| AW 通道:AWID | B 通道:BID | BVALID、BREADY 同时为 1 |
一次读突发可以有多拍 R 数据,但只有最后一拍完成握手,整笔读事务才算完成。一次写事务则只产生一笔 B 响应,即使 W 通道传输了多个数据拍。
假设主设备的 ARID 宽度为 4 位,可以使用 0~15 共 16 种 ID。这不意味着它最多只能同时发出 16 笔事务:多个未完成事务可以重复使用一个 ID,只是必须遵守同 ID 的顺序约束。实际 Outstanding 上限取决于主设备、互连、目标设备及其队列容量。
读响应为什么只能在不同 ID 间乱序
AXI4 对读事务有两条必须同时满足的规则:相同 ARID 的不同读事务,必须按照 AR 地址请求被接受的顺序返回;不同 ARID 的读事务可以改变完成顺序,也允许其 R 数据拍交错传输。
假设三个 AR 请求都已完成握手,发起顺序如下:
| 事务 | ARID | ARLEN | 数据拍数 |
|---|---|---|---|
| A | 2 | 1 | 2 |
| B | 5 | 1 | 2 |
| C | 2 | 0 | 1 |
这里的拍数为 ARLEN + 1。A 与 C 使用相同 ID=2,B 使用 ID=5。虽然 C 的请求在 B 之后被发起,但 C 必须排在 A 的完整读突发之后返回。
假设所有响应拍的 RVALID 和 RREADY 均为 1,那么下面的实际返回顺序合法:
- B 第 1 拍:RID=5,RLAST=0。
- A 第 1 拍:RID=2,RLAST=0。
- B 第 2 拍:RID=5,RLAST=1,B 完成。
- A 第 2 拍:RID=2,RLAST=1,A 完成。
- C 第 1 拍:RID=2,RLAST=1,C 完成。
B 可以先于 A 完成,因为两者 ID 不同。A 和 B 的数据拍也可以交错;但同为 ID=2 的 C,必须等待 A 的最后一拍传输完成后才开始返回。
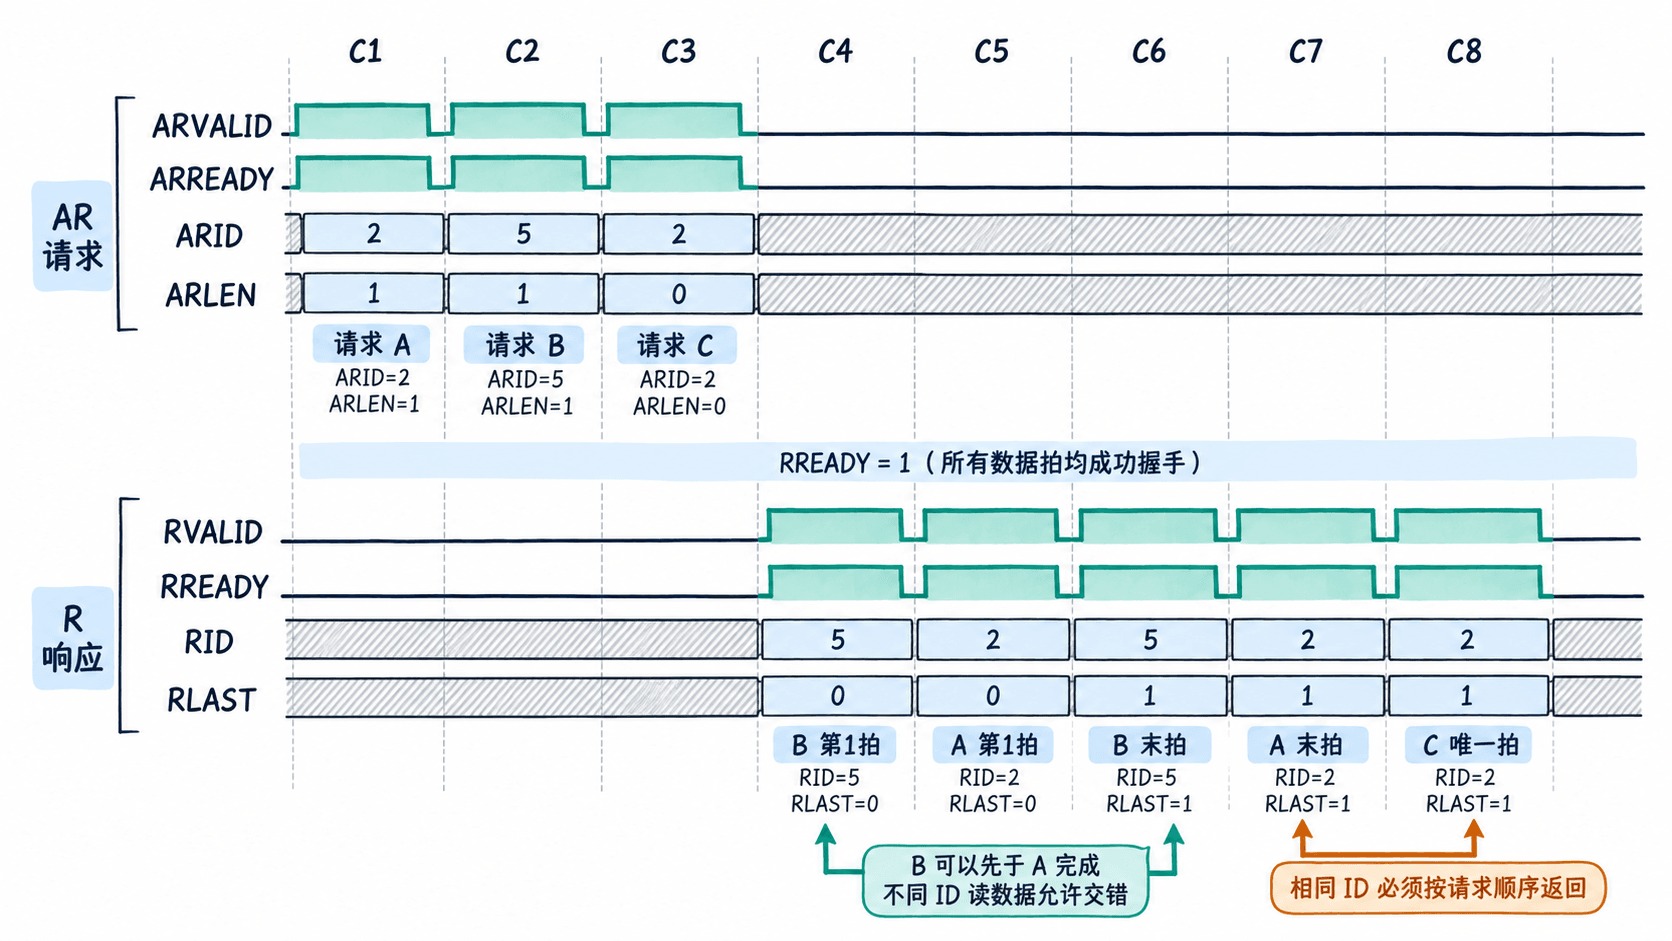
反过来,如果设备把 C 的真实数据提前放到 A 的数据之前,即使 RID 都填写为 2,也不能认为合法。RID 只能区分不同 ID,不能直接区分相同 ID 下的 A 和 C。主设备按同 ID 请求队列的先后次序解释数据,因此实际数据一旦错位,就可能被归属到错误的请求。
这一约束同样适用于通过互连访问不同目标设备的同 ID 读请求。即使后发往快速 SRAM 的请求先准备好了数据,互连仍须保证主设备接口看到的同 ID 响应顺序正确。
用每 ID 队列检查响应顺序
验证读响应时,可以按 ID 为每笔请求保存预期数据拍数。每接收一拍有效 R 数据,就检查对应 ID 队首事务的剩余拍数,并判断 RLAST 是否出现在正确位置。
以下示例使用 Python 3 标准库运行,不依赖 RTL 仿真器。输入是已经在 RVALID 与 RREADY 同时为 1 的周期完成传输的响应拍,因此不模拟背压与空闲周期。
from collections import defaultdict, deque

issued = [(2, "A", 2), (5, "B", 2), (2, "C", 1)]


def check(beats):
    pending = defaultdict(deque)
    for rid, name, count in issued:
        pending[rid].append([name, count])

    for rid, last in beats:
        if not pending[rid]:
            return f"非法:RID={rid} 没有待响应事务"

        # 相同 ID 的响应只能消耗该 ID 队首事务的数据拍
        name, remain = pending[rid][0]
        remain -= 1
        if (remain == 0) != last:
            return f"非法:{name} 的 RLAST 位置错误"

        if last:
            pending[rid].popleft()
        else:
            pending[rid][0][1] = remain

    # 所有请求都必须完整收到对应数量的数据拍
    return ("合法:全部读突发按各 ID 的顺序结束"
            if not any(pending.values()) else "非法:仍有未完成事务")


valid = [(5, False), (2, False), (5, True),
         (2, True), (2, True)]
invalid = [(5, False), (2, True), (5, True),
           (2, False), (2, True)]

print(check(valid))
print(check(invalid))
预期输出:
合法:全部读突发按各 ID 的顺序结束
非法:A 的 RLAST 位置错误
第二组数据中,ID=2 的第一拍就出现 RLAST=1,但队首事务 A 需要两拍,因此判定非法。
需要注意,这只是 RID、RLAST 和突发长度的一致性检查,不是完整的 AXI4 协议验证器。若设备错误交换了两笔相同 ID、相同长度事务的数据,返回信号可能仍符合拍数检查。真正的验证环境还需要根据地址、预期数据及请求顺序建立参考模型,检查每拍内容是否属于正确事务。
在 RTL 验证中,还应只在有效握手时更新计数器。若 RVALID=1 而 RREADY=0,即使 RLAST 已经为 1,也不能提前弹出队首事务,因为这一拍尚未被接收。
写响应顺序与跨通道边界
写事务遵循类似的 ID 规则,但 W 数据通道还有额外限制。假设 AW 地址握手顺序为 A(AWID=2)、B(AWID=5)、C(AWID=2)。
| B 响应完成顺序 | 是否合法 | 原因 |
|---|---|---|
| A、B、C | 合法 | 所有响应按发起顺序完成 |
| B、A、C | 合法 | 不同 ID 的 B 可以先完成 |
| A、C、B | 合法 | 相同 ID 的 A 仍先于 C |
| C、A、B | 非法 | ID=2 的 C 超过了先发的 A |
这里讨论的是 B 响应的完成顺序,而非 W 数据顺序。AXI4 不支持不同写事务在 W 通道交错传输数据。写数据必须遵循对应 AW 请求的先后顺序,完成 A 的所有写数据拍后,才能传输 B 的数据拍,再传输 C 的数据拍。不同 ID 的写响应仍可乱序返回。
另一个容易误解的边界是读写之间的顺序。ARID=2 与 AWID=2 即使数值相同,AXI4 也不会仅凭这个相同 ID 自动保证读与写的先后执行关系,因为 AR 和 AW 是独立的请求通道。
例如,软件要求先写入控制寄存器,再读取状态寄存器,并且必须观察到写入后的状态。主设备应先等待写事务的 B 响应完成握手,再发起依赖该写入结果的读请求;还应满足目标设备与内存属性所规定的可见性要求。不能只因为两笔请求使用相同 ID,就推断读取一定发生在写入生效之后。
实际分析波形时,先按 ARID 或 AWID 把事务划入各自的顺序队列,再检查 RLAST 或 B 响应的有效握手,最后考虑不同 ID 之间允许的重排。若经过互连,互连可以扩展 ID 来区分不同主设备,但必须保持每个主设备原有的顺序约束,并正确还原返回的 ID。
协议示例与顺序规则可对照 Arm《Introduction to AMBA AXI4》第 7.3~7.5 节。判断乱序是否合法时,应始终区分同方向同 ID 保序、不同 ID 可重排,以及读写跨方向不自动保序这三种情况。