
半导体与芯片 / 系统课时
DMA 传输为何不用 CPU 搬运
DMA 传输为何不用 CPU 搬运
假设串口持续送来一批数据,CPU 如果每收到一个字节就读寄存器、写内存,处理器时间会被搬运和中断打断。以接收 256 字节为例,下面追踪 DMA 如何直接占用总线写入 SRAM,以及 CPU 在启动和完成阶段仍要做什么。
学习目标
- 解释 DMA 作为总线发起方,与 CPU 逐字节搬运的区别。
- 沿着 UART、DMA、片上互连和 SRAM 追踪一次接收。
- 用 STM32 HAL 启动一次 256 字节 DMA 接收,并验证完成通知。
逐字节搬运的实际代价
CPU 轮询接收时,需要反复检查 UART 的接收状态、读取数据寄存器,再把字节写到数组;改成逐字节中断,只是把等待换成了中断进入、保存现场和退出,并未取消 CPU 的复制动作。
例如 UART 设置为 921600 bit/s、8N1,每字节在线路上占 1 个起始位、8 个数据位和 1 个停止位。接收 256 字节约需 256 × 10 ÷ 921600 ≈ 2.78 ms。若按每字节一次接收中断,可能进入 256 次 ISR;DMA 普通模式可把数据搬运交给硬件,只在半满、传输完成或出错时按配置通知 CPU。
DMA 不会提高 UART 的线路波特率;它节省的是 CPU 为每个字节参与搬运的开销,使 CPU 能同时运行协议解析之外的其他任务。
DMA 如何从 UART 写到 SRAM
DMA 控制器不是 CPU 执行的一段复制程序,而是具有总线请求能力的硬件模块。UART 的接收事件发出 DMA 请求,DMA 获得互连访问权后读取 UART 数据寄存器,再向 SRAM 写入数据;CPU 不必逐字节执行加载与存储指令。
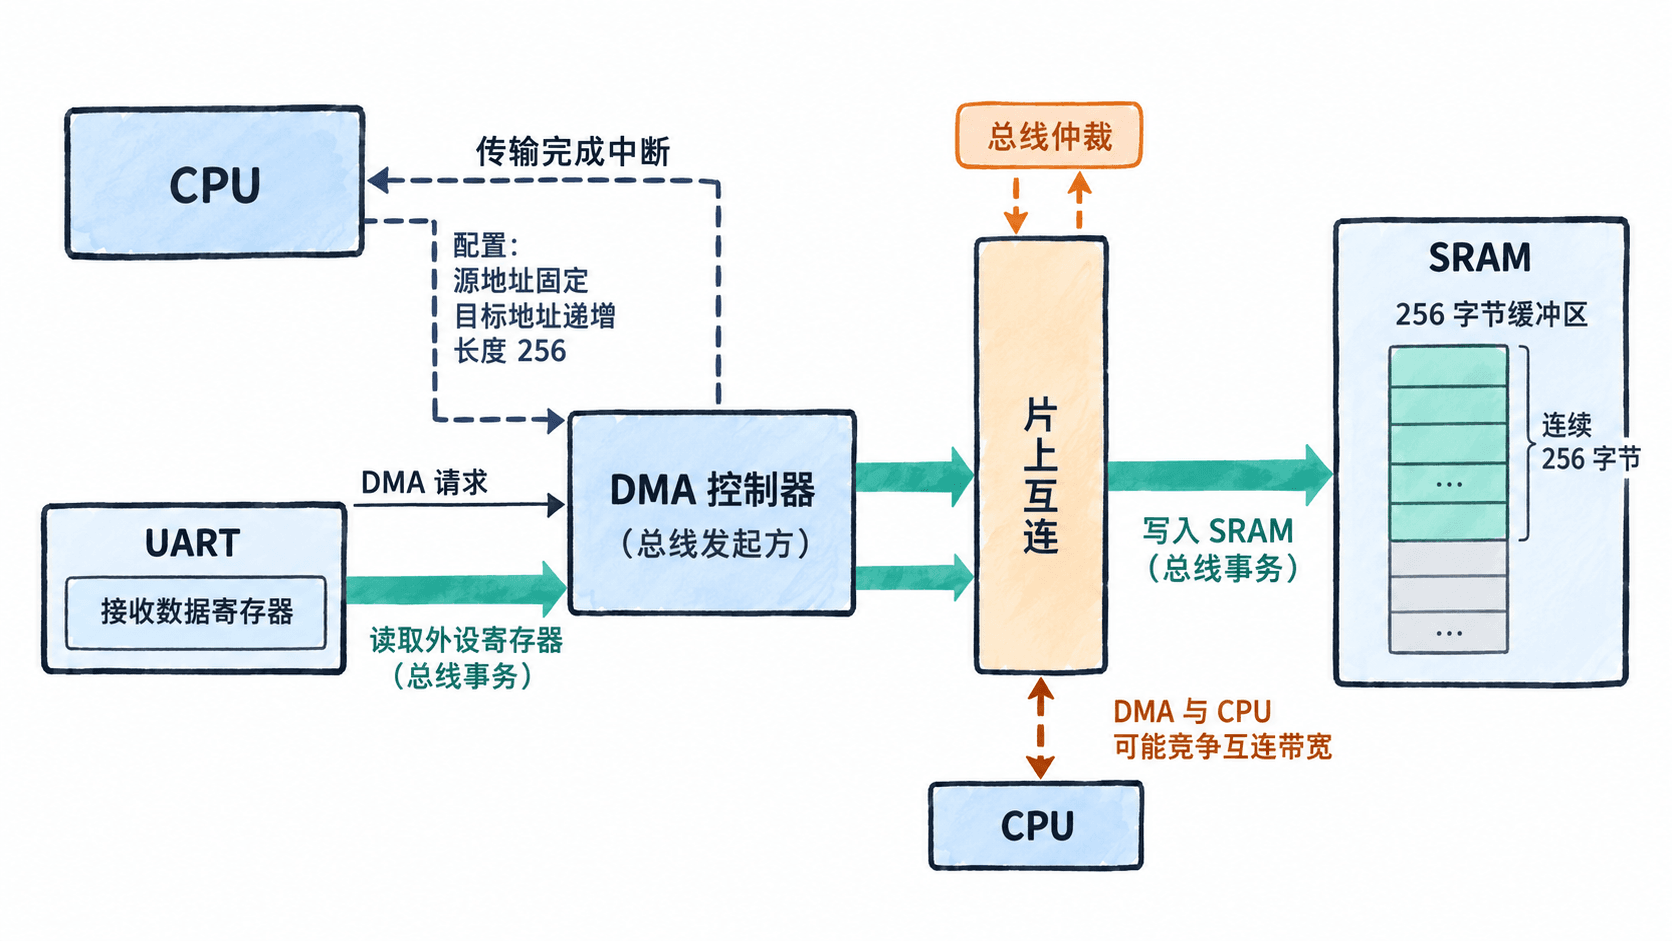
以普通模式单次接收 256 字节为例,硬件与软件分工如下:
- CPU 配置 DMA:源为 UART 接收数据寄存器(固定地址),目标为 SRAM 缓冲区(每次写后递增),方向为外设到内存,计数为 256,数据宽度为 8 位。
- UART 每收到一个字节,就产生接收 DMA 请求;DMA 经总线读取接收寄存器,再写入
rx_buf[0]、rx_buf[1],依此类推,并递减剩余计数。 - 计数归零时 DMA 产生完成事件。中断处理程序通知 CPU:这块缓冲区可以读取、校验或提交上层协议处理;CPU 决定何时重新启动接收。
注意 DMA 传输期间 CPU 仍可使用总线,因此 DMA 和 CPU 会争用 SRAM 或互连资源;“不经 CPU 搬运”不等于“零总线开销”。
在 STM32 上启动一次 DMA 接收
下面使用 STM32L4 系列的 STM32Cube HAL 1.x 接口演示。先在 STM32CubeMX 或 STM32CubeIDE 的设备配置中设置 USART2 → Asynchronous,参数为 921600、8 Bits、None、1 Stop Bit,并在 USART2 的 DMA Settings 中添加 RX 请求。DMA 设置为 Peripheral to Memory、Normal、外设地址不递增、内存地址递增、双方数据宽度均为 Byte,同时使能对应 DMA 通道的 NVIC 中断。DMA 通道及引脚必须按具体芯片和电路板选择。
以下为片段示例,放入 CubeMX 已生成且初始化了 GPIO、DMA、USART2 的工程中;huart2、Error_Handler() 和相关 IRQ Handler 由该工程提供。启动时在 MX_DMA_Init()、MX_USART2_UART_Init() 之后调用 DmaAppStart(),并在主循环反复调用 DmaAppPoll()。
#include "main.h"

extern UART_HandleTypeDef huart2;
static uint8_t rx_buf[256];
static volatile uint8_t rx_done = 0;
static volatile uint32_t last_sum = 0;

void DmaAppStart(void) {
    // 一次配置接收长度,后续由 DMA 搬运 256 个字节
    if (HAL_UART_Receive_DMA(&huart2, rx_buf, sizeof(rx_buf)) != HAL_OK) {
        Error_Handler();
    }
}

void HAL_UART_RxCpltCallback(UART_HandleTypeDef *huart) {
    if (huart == &huart2) {
        rx_done = 1;  // 只记录完成事件,不在中断中扫描缓冲区
    }
}

void DmaAppPoll(void) {
    if (!rx_done) return;
    rx_done = 0;
    uint32_t sum = 0;
    for (uint32_t i = 0; i < sizeof(rx_buf); ++i) {
        sum += rx_buf[i];
    }
    last_sum = sum;  // 让调试器观察处理后的结果
    if (HAL_UART_Receive_DMA(&huart2, rx_buf, sizeof(rx_buf)) != HAL_OK) {
        Error_Handler();
    }
}
预期结果: 上位机在接收启动后连续发送 256 个 0x01 字节,暂停发送;DMA 写满数组后进入 HAL_UART_RxCpltCallback(),主循环处理完成时调试器可看到 last_sum = 256。无固定串口打印,因为本例的 USART2 用于接收测试。若回调不触发,优先检查 DMA 请求映射、DMA IRQ 是否使能,以及生成的 IRQ Handler 是否调用 HAL 的 DMA 中断处理函数。
哪些工作仍由 CPU 负责
DMA 负责搬运,不自动完成数据的业务处理。CPU 仍需指定地址、长度和方向,检查完成或错误状态,解析协议并决定缓冲区何时可以复用。若每次只传 1~2 字节,DMA 初始化和中断管理开销可能不值得;连续采样或成块收发更适合 DMA。
上面的普通模式示例在“处理数据、重新使能 DMA”期间存在接收空档,适合分帧发送并允许暂停的测试。若 UART 字节流从不停止,可使用循环 DMA 配合半传输/全传输事件,或支持时用空闲线检测区分变长帧,再配合环形缓冲区避免覆盖未处理数据。
若换成带数据缓存的 Cortex-M7 SoC,还必须确保 DMA 缓冲区位于 DMA 可访问的内存,并按缓存一致性要求处理接收数据;否则 DMA 已写入 SRAM,CPU 仍可能读到旧缓存。判断 DMA 是否真正减轻负担,应同时测量 CPU 占用、丢包数和总线延迟,而不只看传输是否完成。