
半导体与芯片 / 系统课时
一致性与内存顺序有什么区别
一致性与内存顺序有什么区别
两个 CPU 核即使维护着一致的缓存副本,也可能同时读到旧值。本篇用写缓冲导致的双核读写结果区分 Cache Coherence 与 Memory Consistency,再用 C++17 原子操作验证怎样约束跨核访问的顺序。
学习目标
- 区分单地址的缓存一致性与跨地址的内存顺序约束。
- 解释双核写缓冲为何允许两次读取都返回零。
- 根据跨线程通信目标选用
relaxed、release/acquire或seq_cst。
缓存一致不代表访问全局有序
**缓存一致性(Cache Coherence)**回答的是:多个核缓存同一地址时,写入如何被统一管理。例如两个核先后向 x 写入 1 和 2,处于同一个一致性域的观察者不能对这两次写的相对次序得出互相矛盾的结论。MESI 一类协议通过缓存行所有权与失效消息协调副本,但不能要求每次写立即被所有核看到。
**内存顺序模型(Memory Consistency Model)**回答的是:当访问涉及 x、y 两个地址时,别的核允许看到哪些读写先后关系。处理器可能让存储先留在写缓冲中,编译器也可能在语言模型许可范围内调整操作;因此“每个地址各自一致”并不等于“所有核都按源码顺序观察所有地址”。
区分时可以先问两个问题:冲突是否发生在同一个地址(检查一致性协议和原子修改顺序),还是读写跨越多个地址(检查内存序、同步操作和 happens-before)。
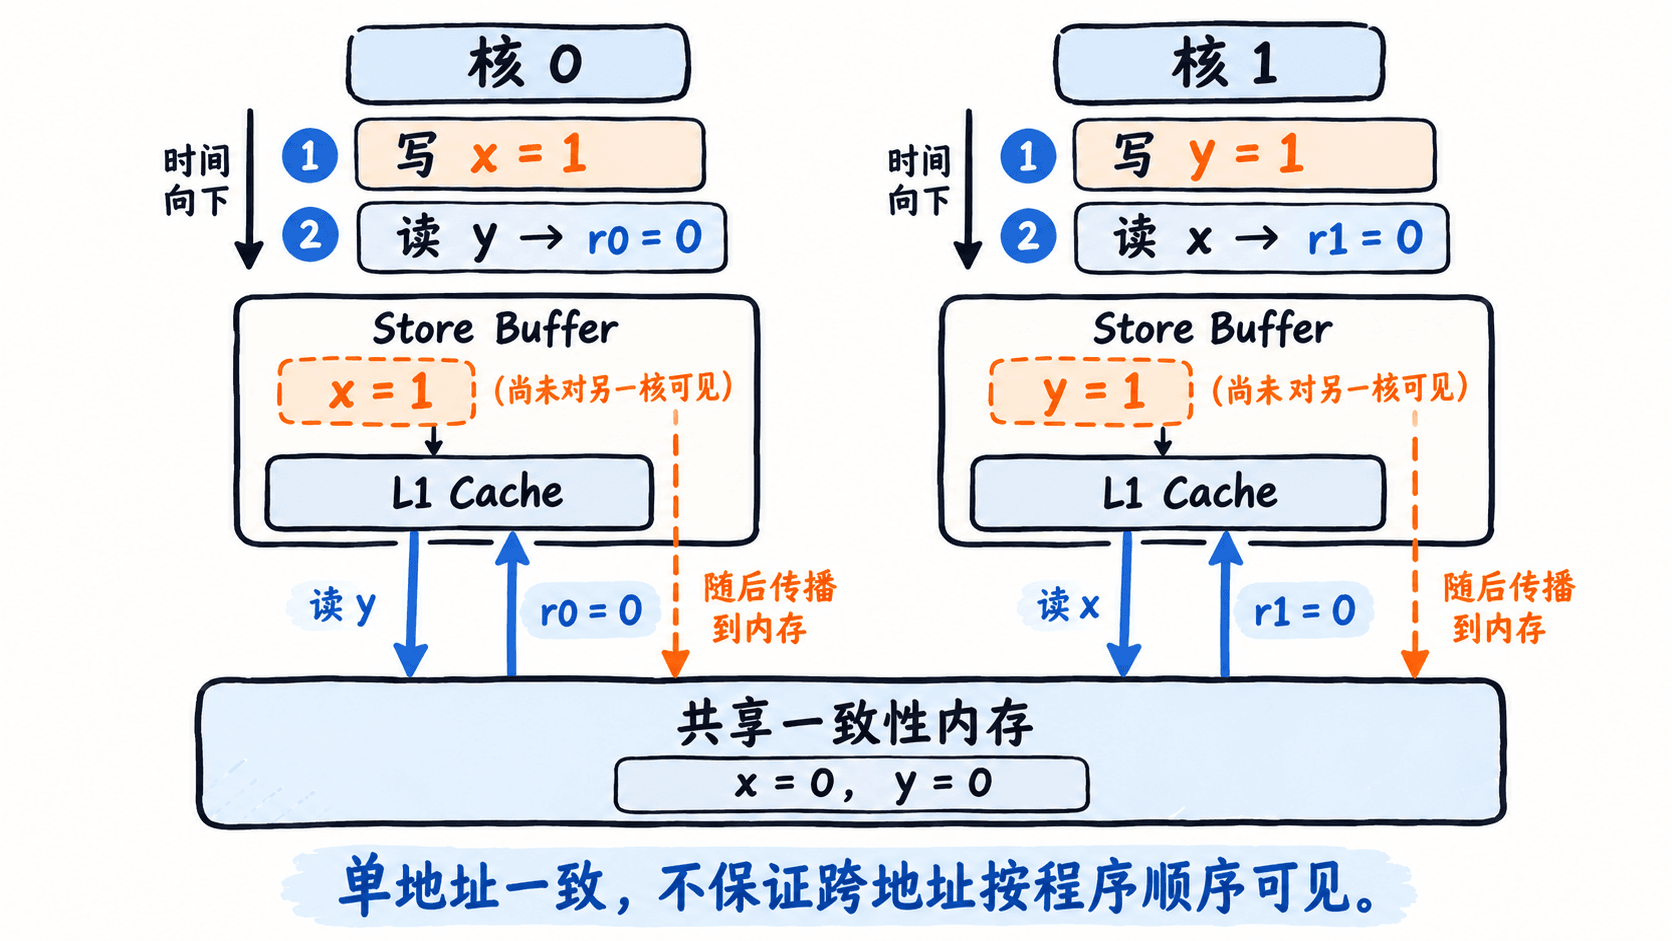
写缓冲为什么允许两边都读到零
设 x、y 是初值为 0 的两个共享原子整数。每个核先写自己的地址,再读对方的地址:
| 操作顺序 | 核 0 | 核 1 |
|---|---|---|
| 第一条 | x.store(1, std::memory_order_relaxed) |
y.store(1, std::memory_order_relaxed) |
| 第二条 | r0 = y.load(std::memory_order_relaxed) |
r1 = x.load(std::memory_order_relaxed) |
| 允许的结果 | r0 == 0 |
r1 == 0 |
在一种可能的执行中,两次写先分别进入本核的 Store Buffer,尚未对另一核可见;随后两次读都看到对方地址的旧值。这不违反缓存一致性,因为 x、y 各自的写入顺序没有冲突。x86-TSO 硬件也可能因写缓冲表现出这种 Store→Load 可见性差异,虽然它保留其他多种程序顺序约束。
用 C++17 验证两种顺序保证
std::memory_order_seq_cst 使参与的原子操作满足单一的顺序一致次序,并遵守各线程的程序顺序,因此能排除上面的 r0 == 0 && r1 == 0。但如果只是生产者写数据、消费者等通知后读取,用 release/acquire 建立一次发布同步就够了。
将下面的完整程序保存为 main.cpp,用 g++ -std=c++17 -O2 -pthread main.cpp -o main && ./main 编译运行:
#include <atomic>
#include <iostream>
#include <thread>

int main() {
    std::atomic<int> x{0}, y{0};
    int r0 = -1, r1 = -1;

    // 顺序一致约束两个核各自的先写后读。
    std::thread t0([&] {
        x.store(1, std::memory_order_seq_cst);
        r0 = y.load(std::memory_order_seq_cst);
    });
    std::thread t1([&] {
        y.store(1, std::memory_order_seq_cst);
        r1 = x.load(std::memory_order_seq_cst);
    });
    t0.join();
    t1.join();
    std::cout << "seq_cst both_zero=" << (r0 == 0 && r1 == 0) << '\n';

    int payload = 0, received = 0;
    std::atomic<bool> ready{false};

    // 发布标志之前写好的普通数据。
    std::thread sender([&] {
        payload = 42;
        ready.store(true, std::memory_order_release);
    });
    std::thread receiver([&] {
        // 读到 true 后,才能安全地读取 payload。
        while (!ready.load(std::memory_order_acquire)) {
            std::this_thread::yield();
        }
        received = payload;
    });
    sender.join();
    receiver.join();
    std::cout << "release_acquire payload=" << received << '\n';
}
预期输出:
seq_cst both_zero=0
release_acquire payload=42
第一行不随线程调度变化:两个读不可能同时为零。第二行成立的关键是消费者的 acquire 读取确实观察到了生产者的 release 写入,才建立同步关系,让较早的 payload = 42 对消费者可见。
怎样选择内存序和屏障
| 通信需求 | 合适做法 | 关键限制 |
|---|---|---|
| 只做原子计数,不发布其他数据 | fetch_add(1, std::memory_order_relaxed) |
保证计数原子性,不保证其他地址的顺序 |
| 写好普通数据后发布就绪标志 | store(..., std::memory_order_release) 与观察到该写入的 load(std::memory_order_acquire) |
必须通过同一个原子对象完成发布与接收 |
| 排除上表 Store Buffering 测试的双零结果 | 两边的 store、load 均用 std::memory_order_seq_cst |
需要跨地址更强的顺序约束 |
把上面的两次存储改成 release、两次读取改成 acquire,仍不能单凭这些操作排除双零:当两次读取都读到初始 0,就没有读到对方发布值,也就没有对应的同步关系。使用 volatile 同样不能建立 C++ 线程间同步。
硬件层面,x86 的 MFENCE、Arm 的 DMB ISH 可以约束各自架构定义的访存顺序,但屏障不是刷新全部缓存的命令。实际 C++ 程序应优先表达为原子操作及其内存序,再让编译器为目标架构生成正确指令;非一致性 DMA 和 MMIO 则需单独查 SoC 手册中的屏障作用域、设备内存属性及缓存维护要求。
遇到“缓存值最终正确,但另一个核看到的先后次序不对”时,先逐核列出读写顺序和用于同步的原子变量,再核对哪个 acquire 真正读到了哪个 release,不要只检查缓存行是否已经失效或更新。