
半导体与芯片 / 系统课时
共享总线何时需要交叉开关
共享总线何时需要交叉开关
当 CPU 访问存储器、DMA 同时搬运数据时,共享总线可能把本可并行的访问串行化。本篇通过两个主设备和两个目标设备的实例,计算共享总线与 Crossbar 的并行能力,分析面积和布线代价,并确定什么情况下值得升级互连拓扑。
学习目标
- 区分共享总线与 Crossbar 的连接方式和仲裁位置。
- 根据主设备访问的目标,计算理想情况下每拍可完成的传输数量。
- 结合带宽需求、目标设备冲突和硬件成本选择互连结构。
共享总线与 Crossbar 的结构差异
假设 SoC 包含两个总线发起方:CPU 和 DMA,以及两个独立目标:SRAM A 和 SRAM B。CPU 正在访问 SRAM A,DMA 同时访问 SRAM B。
共享总线使用一个公共传输路径。CPU 和 DMA 先经过统一仲裁器,再使用同一条路径访问目标设备。即使两个请求指向不同 SRAM,也必须争用共享路径。在每拍只允许一次数据传输的简化模型中,两笔访问需要分两拍完成。
**Crossbar(交叉开关)**为不同目标提供可独立工作的连接路径。CPU 可以连接 SRAM A,同时 DMA 连接 SRAM B。由于两个目标及其数据路径独立,理想情况下两笔传输能够同拍进行。
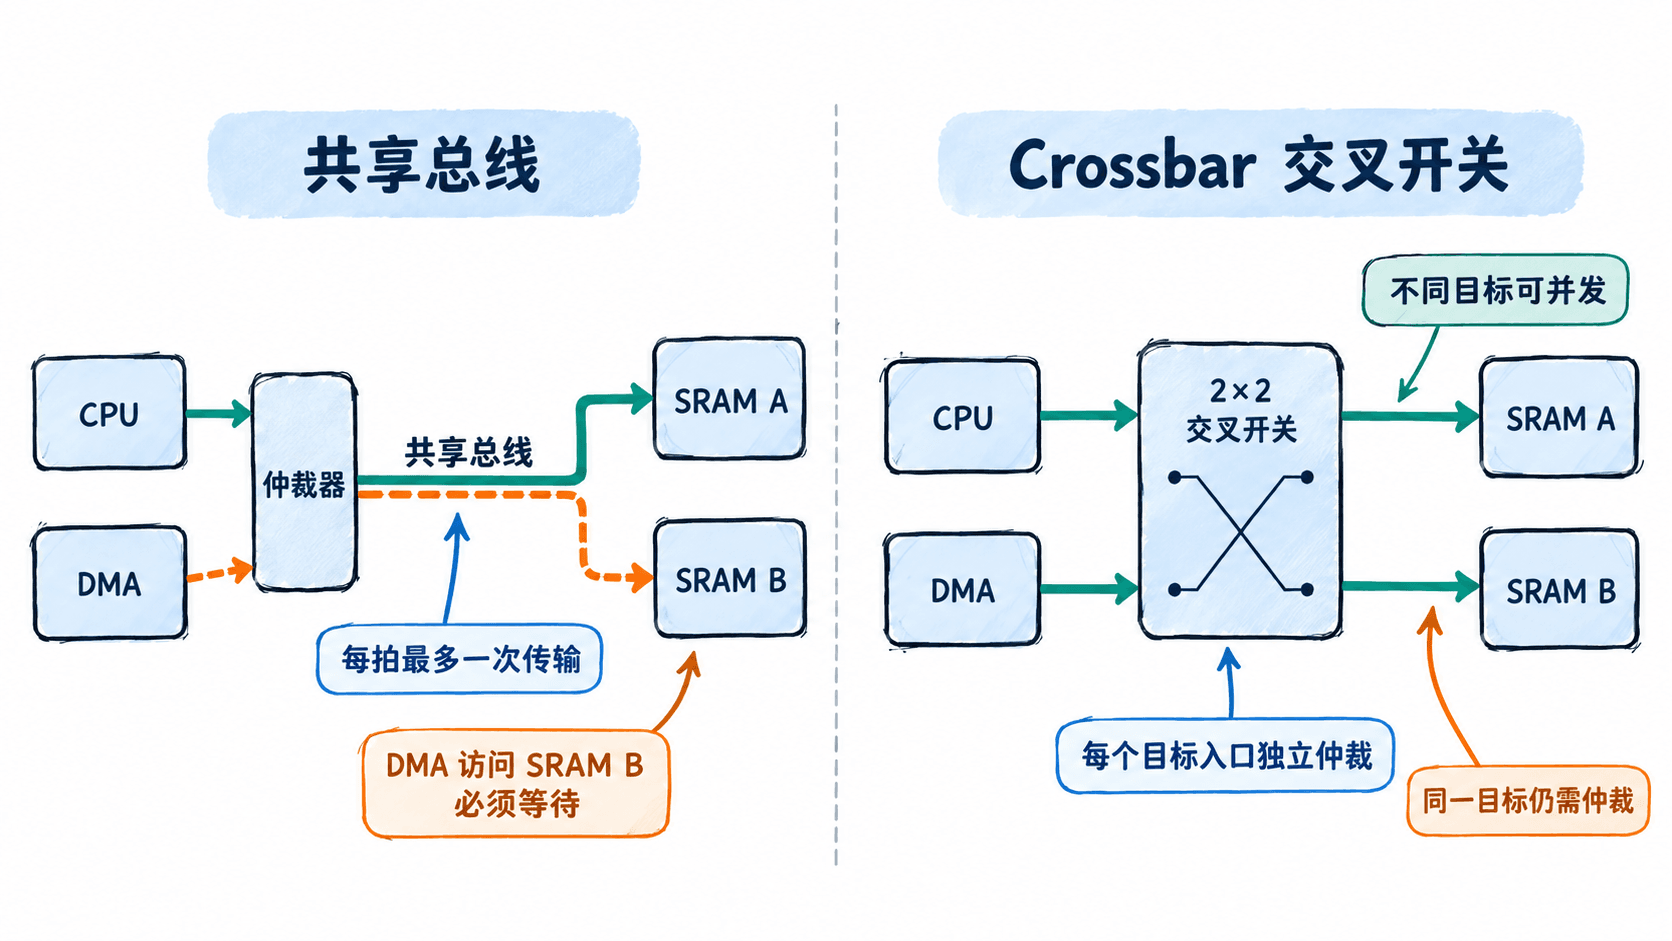
Crossbar 并不意味着任意两个请求都能并行。如果 CPU 和 DMA 同时访问 SRAM A,两个请求仍然需要在 SRAM A 的入口仲裁。并行能力取决于请求是否落在独立目标,以及中间是否存在其他共享瓶颈。
在 AXI4 系统中,地址、写数据和响应通道具有各自的握手机制。这里比较的是简化后的单条数据路径传输能力,不能直接等同于完整 AXI4 的所有通道吞吐量。
用两主两从模型计算并行度
为了排除突发长度和等待周期的影响,先设定三个条件:每个主设备每拍最多请求一次传输,每个目标每拍最多接收一次传输,目标设备始终能够接收数据。
| 同周期访问组合 | 共享总线可完成数 | 2×2 Crossbar 可完成数 |
|---|---|---|
| CPU→SRAM A,DMA→SRAM B | 1 笔/拍 | 2 笔/拍 |
| CPU→SRAM A,DMA→SRAM A | 1 笔/拍 | 1 笔/拍 |
| 只有 CPU→SRAM A | 1 笔/拍 | 1 笔/拍 |
下面用 Python 3 模拟单拍内的请求授予。模型按照输入顺序处理请求,用于验证不同目标可并行、相同目标必须仲裁的性质,并不模拟实际 AXI4 的 VALID/READY、突发和响应时序。
def count_grants(targets, crossbar):
    busy_targets = set()
    granted = 0

    for target in targets:
        # 共享路径每拍只能接受一笔传输
        if not crossbar and granted == 1:
            break
        # 每个目标每拍最多接受一笔传输
        if target in busy_targets:
            continue
        busy_targets.add(target)
        granted += 1

    return granted


cases = {
    "不同目标": ("SRAM_A", "SRAM_B"),
    "同一目标": ("SRAM_A", "SRAM_A"),
}

for name, targets in cases.items():
    shared = count_grants(targets, False)
    crossbar = count_grants(targets, True)
    print(f"{name}: 共享总线={shared}, Crossbar={crossbar}")
预期输出:
不同目标: 共享总线=1, Crossbar=2
同一目标: 共享总线=1, Crossbar=1
再考虑实际数据宽度。假设互连数据宽度为 64 bit,工作频率为 100 MHz,并且没有等待和协议开销。每拍传输 8 字节,一条路径的理论数据带宽为 800 MB/s。
当两个独立 SRAM 都能持续接收数据时,共享路径的理想总带宽上限为 800 MB/s,而具有两条独立 64 bit 数据路径的 Crossbar 理论上可达到 1600 MB/s 的聚合带宽。这里的 MB 按十进制计算,实际吞吐量还会受到突发、反压、仲裁和存储器速度影响。
Crossbar 增加了哪些硬件成本
共享总线通常只需要一个主要共享传输路径、相应的仲裁和目标选择逻辑。Crossbar 则要在不同主设备与目标之间实现可选择的连接,并在目标入口处理请求竞争。
以每个主设备都能访问所有目标的完整连接关系为例:
| 拓扑规模 | 可能的主从连接关系 | 理想最大并发目标数 |
|---|---|---|
| 2 主 × 2 从 | 4 种 | 2 |
| 4 主 × 4 从 | 16 种 | 4 |
| 8 主 × 4 从 | 32 种 | 4 |
连接关系数量等于主设备数乘以目标设备数,但这不等于实际物理导线数或门电路数。真实面积还取决于数据位宽、地址译码、仲裁器、选择器、缓冲、流水线和支持的协议功能。
例如,在 64 bit 数据通路上扩展到四个主设备、四个目标设备,通常需要更复杂的数据选择逻辑以及更多跨模块布线。长距离连线会增加扇出、拥塞和时序收敛压力,必要时还要插入寄存器或缓冲级。
因此,Crossbar 的成本不仅是额外逻辑门,还包括布线资源、动态功耗、验证复杂度和可能增加的路径延迟。完整 Crossbar 也不是唯一方案:可以只为经常并发访问的主从组合建立独立通路,形成部分互连拓扑。
根据访问流量选择拓扑
假设分析一段稳定运行的工作负载,得到 CPU 平均请求速率为每拍 0.55 个数据拍,DMA 为每拍 0.50 个数据拍,并且 CPU 只访问 SRAM A、DMA 只访问 SRAM B。
两者合计需要每拍 1.05 个数据拍,超过单条共享路径每拍 1 个数据拍的理想服务能力。长期持续运行时,共享总线无法满足全部需求,请求会累积等待。两个目标彼此独立的 Crossbar 则有机会分别承担 0.55 和 0.50 的负载。
如果两者实际都访问 SRAM A,即使采用 Crossbar,SRAM A 每拍只能接收一笔的约束仍然存在。此时应该优先检查存储器端口数量、存储控制器带宽或数据放置方式,而不是直接增加交叉开关。
实际项目可以按以下顺序判断:
- 统计发起方流量。 分别记录 CPU、DMA 等发起方的访问目标、平均吞吐量、突发长度和高峰时段,不只统计请求总数。
- 检查冲突位置。 结合互连性能计数器或仿真波形,区分共享路径拥塞、同一目标仲裁和目标自身反压。对于 AXI4,重点观察各相关通道的 VALID 有效但 READY 未就绪的等待周期。
- 计算容量上限。 对照各段数据路径的位宽和时钟计算理论吞吐量,再核对目标端口的接收能力。如果需求超过共享路径容量,但分别落在独立目标上,Crossbar 才能带来明显收益。
- 评估实现代价。 比较共享总线、部分 Crossbar 和完整 Crossbar 的面积、最高可达频率、布线拥塞以及关键请求延迟,并通过同一工作负载仿真验证。
在主设备访问时间较少重叠、共享路径容量足够且延迟满足要求时,优先选择较简单的共享结构。当多个发起方长期并行访问不同目标、共享路径已成为可测量的性能瓶颈时,再引入 Crossbar 或部分并行互连,并用实际仲裁等待、吞吐量与时序结果确认收益。