
半导体与芯片 / 系统课时
多主设备争用时怎样做仲裁
多主设备争用时怎样做仲裁
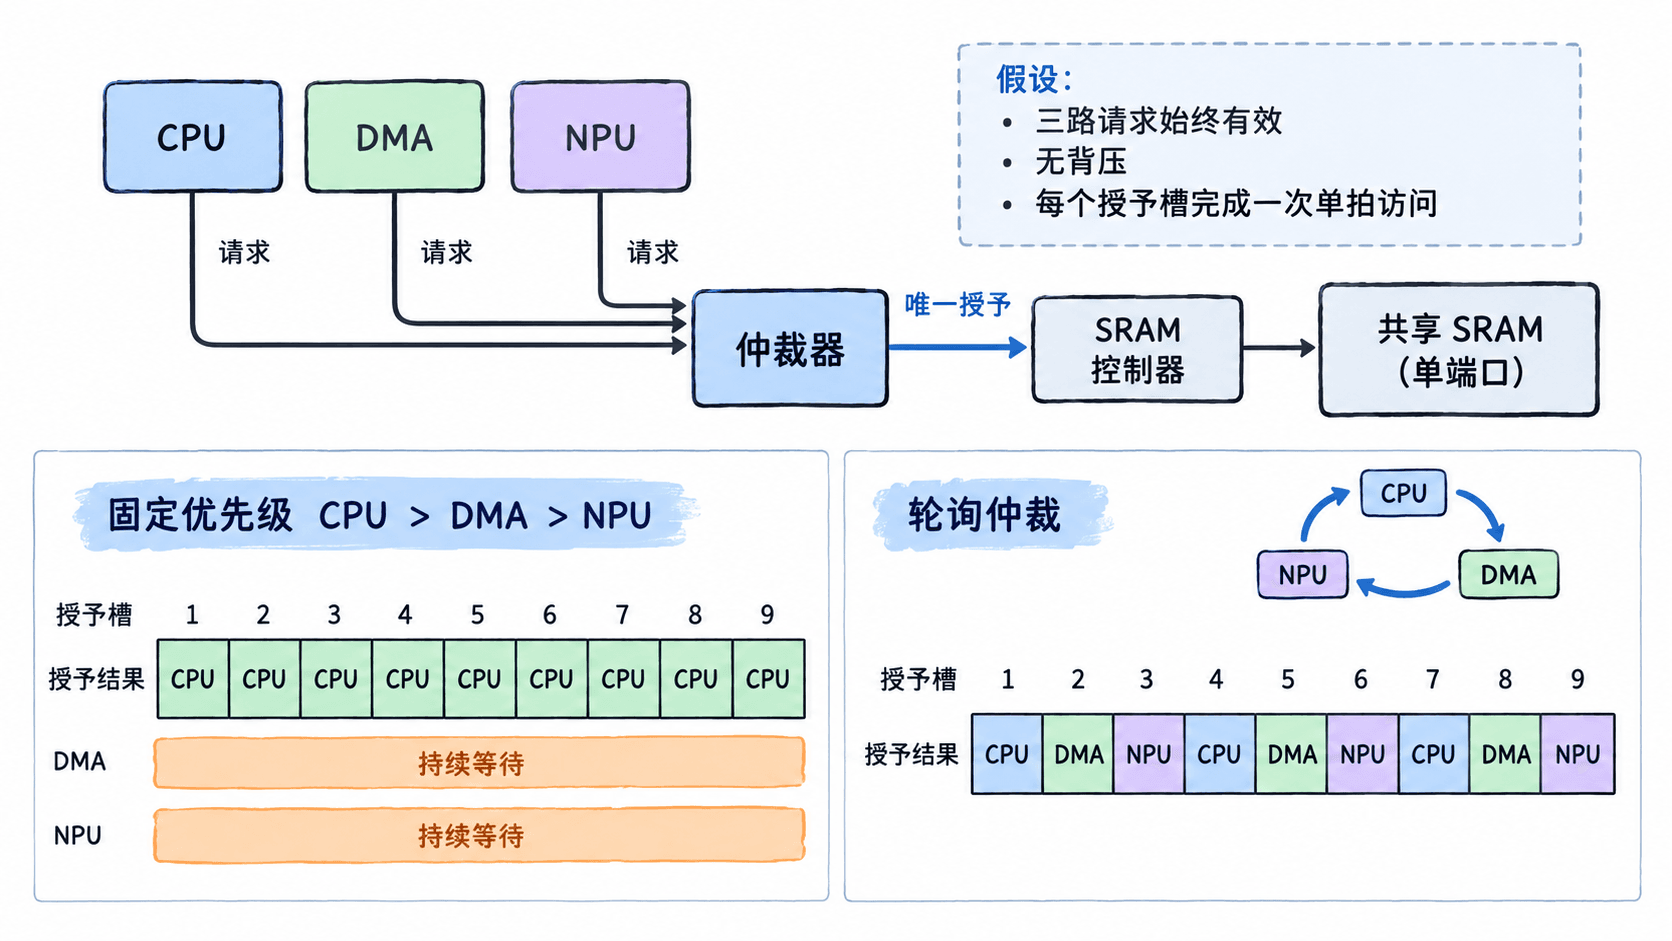
当 CPU、DMA 和 NPU 同时请求一块共享 SRAM 时,互连必须决定谁先得到访问机会。本篇使用三个请求源持续有效、一次只完成一个单拍访问的模型,模拟固定优先级与轮询仲裁,算出各设备获得的服务次数与等待上界。
学习目标
- 识别请求、授予和下游接受之间的区别。
- 运行最小仲裁模拟,比较固定优先级与轮询的结果。
- 根据时延和公平性要求选择策略,并确定硬件验证点。
明确共享资源与授予单位
假设 CPU、DMA、NPU 都连接到同一个 SRAM 控制器,其入口在任一访问机会只能服务一笔单拍事务。三者持续请求,控制器始终可接受请求;每完成一次访问,就重新仲裁。CPU 在固定优先级方案中排第一,轮询方案初始从 CPU 开始。
授予并不等于请求发出:请求信号只表明设备想访问;只有下游实际接受该请求,才算消耗一次访问机会。本文把一次已接受且完成的单拍访问记作一个“授予槽”,用于隔离仲裁策略本身的影响。
两种仲裁规则怎样选中设备
固定优先级每次按 CPU、DMA、NPU 顺序检查请求,选第一个有效者。只要 CPU 持续占用所有访问机会,DMA 和 NPU 就会饥饿;“低优先级以后总能轮到”并无保证。
轮询仲裁保留一个指针,从指针所指设备开始依次检查有效请求;授予成功后,将指针移到被服务设备的下一位。没有请求的设备直接跳过。关键是只在下游接受请求后推进指针,而不是每经过一个时钟周期就推进。
以下 Python 3 示例固定三路请求始终有效;每轮代表一个无背压的成功授予槽,不模拟 SRAM 内部延迟。
MASTERS = ("CPU", "DMA", "NPU")
REQUESTED = (True, True, True)  # 三路始终有请求

def simulate(policy, slots=9):
    cursor = 0
    grants = []
    for _ in range(slots):
        start = 0 if policy == "fixed" else cursor
        # 从本轮起点寻找首个有效请求,空闲设备自动跳过
        winner = next(
            (start + step) % len(MASTERS)
            for step in range(len(MASTERS))
            if REQUESTED[(start + step) % len(MASTERS)]
        )
        grants.append(MASTERS[winner])
        # 仅在成功授予后更新轮询起点
        if policy == "round_robin":
            cursor = (winner + 1) % len(MASTERS)
    return grants

for policy in ("fixed", "round_robin"):
    grants = simulate(policy)
    print(f"{policy}: {' '.join(grants)}")
    print("count: " + " ".join(
        f"{master}={grants.count(master)}" for master in MASTERS
    ))
预期输出:
fixed: CPU CPU CPU CPU CPU CPU CPU CPU CPU
count: CPU=9 DMA=0 NPU=0
round_robin: CPU DMA NPU CPU DMA NPU CPU DMA NPU
count: CPU=3 DMA=3 NPU=3
从授予结果计算等待与公平性
| 方案 | CPU | DMA | NPU | 连续请求时的风险 |
|---|---|---|---|---|
| 固定优先级 | 9 | 0 | 0 | DMA、NPU 等待无上界 |
| 轮询 | 3 | 3 | 3 | 每台设备至多先让另外两台成功授予 |
两种方案都完成了 9 次访问,所以相同服务能力下的总吞吐没有因轮询提高;差异是访问机会怎样分配。在本例中,轮询下某个持续请求者两次服务之间最多插入另外两次授予,而固定优先级无法给低优先级者类似上界。
上界必须带着单位读。如果实际仲裁按完整事务而非单拍进行,且每个事务最多占用 4 拍、全程无等待,那么三个设备轮询时,最坏可能先等其他两个事务,共 8 个数据拍。下游背压、刷新或未限制长度的占用都会让实际等待更久。
接入 AXI4 互连时怎样验收
在 AXI4 中,读地址使用 ARVALID 与 ARREADY,写地址使用 AWVALID 与 AWREADY。统计一次请求被接受,必须以对应通道的 VALID && READY 同时为真为准;只有请求被选中、下游却没有 READY 时,不应误记为完成授予并推进轮询指针。
- 让 CPU、DMA、NPU 持续对同一个目标发起请求,分别统计每个主设备完成的地址握手数,以及从发起请求到地址握手的最长等待周期。
- 人为使目标端
READY拉低 3 拍,确认选中的请求及地址信息保持稳定,没有丢请求、重复计数或跳过设备。 - 对轮询方案检查持续请求者不会长期得不到地址握手;对固定优先级方案检查 CPU 持续请求时,DMA/NPU 是否符合预先定义的容忍等待时间。
若 CPU 有紧迫时延而 DMA 也不能被饿死,可以考虑带有明确服务配额的加权轮询。例如持续请求、无背压时按 CPU: DMA: NPU = 2:1:1 分配,8 个授予槽可分别得到 4、2、2 次;实现前还要单独计算最长等待和每次占用时长。