
半导体与芯片 / 系统课时
用 FIFO 与寄存切片缓解时序
用 FIFO 与寄存切片缓解时序
当 CPU、DMA 等发起方通过共享互连访问 SRAM 时,长连线、仲裁多路选择器和反向 READY 链可能造成时序违例。本课比较寄存切片与 FIFO 的切分效果,实现一个可仿真的双深度弹性缓冲,并检查吞吐、延迟与背压传播。
学习目标
- 根据静态时序报告区分前向数据路径和反向 READY 路径。
- 选择单级寄存切片或双深度 FIFO,并说明各自的延迟和容量代价。
- 用仿真验证传输顺序、满队列背压及恢复后的连续传输。
从关键路径决定插入位置
假设系统时钟为 250 MHz,周期只有 4 ns;仲裁器到 SRAM 端口的组合路径若达到 5.1 ns,即使暂不计建立时间和时钟偏斜,也至少超出 1.1 ns。应先在静态时序分析(STA)中确认路径的起点、终点和逻辑级数,而不是随意增加缓存。
对于 READY/VALID 接口,每次传输只在时钟上升沿且 VALID && READY 为真时完成。VALID=1、READY=0 时,发送方必须保持 VALID 和有效载荷稳定。若最长路径从发起方的数据寄存器穿过仲裁多路选择器到目标端,就要切前向 DATA/VALID;若从目标的 READY 经仲裁逻辑回到发起方,就要切反向控制链。
在 AXI4 中,AW、W、B、AR、R 是五条独立握手通道。对某条通道插入切片时,其 ID、LAST、STRB、RESP 等属于该通道的有效载荷字段必须与 VALID 一起保持,不可只缓存 DATA。
比较寄存切片与 FIFO
| 方案 | 首拍新增延迟 | 可暂存拍数 | 反向 READY 是否直通 |
|---|---|---|---|
| 无缓冲直连 | 0 拍 | 0 | 可能贯穿整段互连 |
| 单级前向寄存切片 | 通常 1 拍 | 1 | 若 s_ready 依赖 m_ready,仍有组合路径 |
| 双深度弹性 FIFO(本文实现) | 至少 1 拍 | 2 | 否,输入 READY 由本地占用量产生 |
单级寄存切片能把前向长路径拆成两段,但常见的单槽高吞吐实现会把下游 READY 组合反馈到上游。若 STA 的关键路径恰好在 READY 上,应使用带额外暂存槽的 skid buffer,或采用下面这种双深度 FIFO。它用一个空槽吸收尚未来得及传播的背压,代价是额外寄存器和首拍延迟。
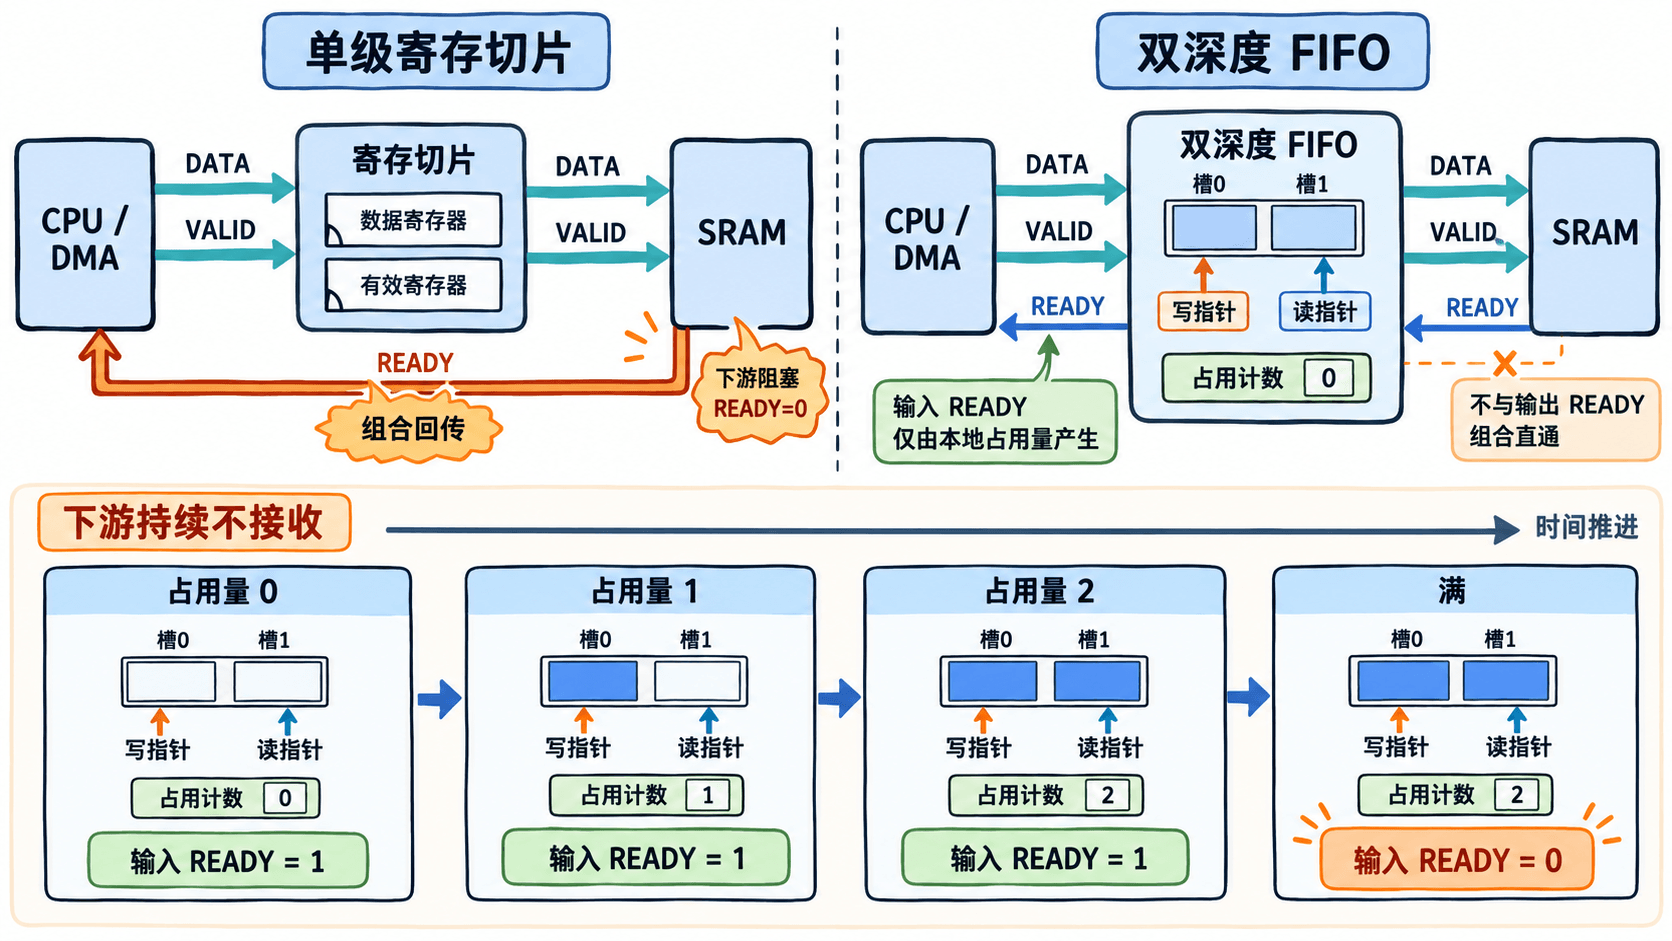
当下游停住且 FIFO 原本为空时,两拍深度允许上游再成功写入两拍;满后 s_ready=0,背压才传播到发起方。若队列已占用一拍,就只剩一拍缓冲余量。这里的“深度”表示存储容量,不等于必然增加的流水级数。
实现双深度弹性缓冲
下面的 SystemVerilog 实例针对同一时钟域的一个 READY/VALID 数据通道。两位占用计数和一位读写指针管理两个数据槽;s_ready 只读取寄存后的 count,从而避免下游 m_ready 到上游的组合路径。测试平台先堵住出口五个周期,再恢复接收并检查六拍数据的顺序。
module rv_fifo2 #(parameter integer WIDTH = 8) (
  input  logic clk, rst_n,
  input  logic s_valid,
  output logic s_ready,
  input  logic [WIDTH-1:0] s_data,
  output logic m_valid,
  input  logic m_ready,
  output logic [WIDTH-1:0] m_data
);
  logic [WIDTH-1:0] mem [0:1];
  logic wr_ptr, rd_ptr;
  logic [1:0] count;
  wire push = s_valid && s_ready;
  wire pop  = m_valid && m_ready;

  // READY 不依赖下游当前拍的 READY。
  assign s_ready = (count != 2);
  assign m_valid = (count != 0);
  assign m_data  = mem[rd_ptr];

  always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) begin
      wr_ptr <= 0;
      rd_ptr <= 0;
      count <= 0;
    end else begin
      if (push) begin
        mem[wr_ptr] <= s_data;
        wr_ptr <= ~wr_ptr;
      end
      if (pop) rd_ptr <= ~rd_ptr;
      // 同拍入队和出队,容量占用不变。
      case ({push, pop})
        2'b10: count <= count + 1'b1;
        2'b01: count <= count - 1'b1;
        default: count <= count;
      endcase
    end
  end
endmodule

module tb;
  logic clk = 0, rst_n = 0;
  logic s_valid = 0, m_ready = 0;
  logic [7:0] s_data = 0;
  wire s_ready, m_valid;
  wire [7:0] m_data;
  integer sent = 0, got = 0, cycle = 0, stalled = 0;

  always #5 clk = ~clk;
  rv_fifo2 #(.WIDTH(8)) dut (
    .clk(clk), .rst_n(rst_n),
    .s_valid(s_valid), .s_ready(s_ready), .s_data(s_data),
    .m_valid(m_valid), .m_ready(m_ready), .m_data(m_data)
  );

  initial begin
    repeat (2) @(negedge clk);
    rst_n = 1;
    // 上游持续请求;下游前五个测试周期不接收。
    while (got < 6 && cycle < 30) begin
      @(negedge clk);
      s_valid = (sent < 6);
      s_data = 8'hA0 + sent;
      m_ready = (cycle >= 5);
      @(posedge clk);
      if (s_valid && !s_ready) stalled = stalled + 1;
      if (s_valid && s_ready) sent = sent + 1;
      if (m_valid && m_ready) begin
        if (m_data !== (8'hA0 + got))
          $fatal(1, "reorder or data loss");
        got = got + 1;
      end
      cycle = cycle + 1;
    end
    if (got != 6 || stalled == 0) $fatal(1, "timeout or no stall");
    $display("PASS: 6 beats, ordered, backpressure handled");
    $finish(0);
  end
endmodule
将代码保存为 rv_fifo2.sv,在已安装 Icarus Verilog 的终端运行:
iverilog -g2012 -s tb -o simv rv_fifo2.sv
vvp simv
预期输出:
PASS: 6 beats, ordered, backpressure handled验收吞吐和时序边界
在波形中检查:复位后占用量从 0 增至 1、2;满时 s_ready=0;出口恢复后按 A0、A1、A2、A3、A4、A5 的顺序交付,既不丢拍也不重拍。正式验证还应覆盖空队列、同拍入队和出队、长时间背压,以及停顿期间 m_valid 与 m_data 的稳定性。
对 128 位宽、250 MHz 的通道,理想情况下每拍交付一次,峰值数据吞吐为 128/8 × 250 MHz = 4 GB/s;若只有 75% 的周期完成输出握手,实际有效数据吞吐是 3 GB/s。本例在队列已满且同拍出队时仍拒绝新输入,不追求该边界的零气泡接收,以免重新引入 READY 组合反馈。首拍还需先写入寄存槽,因此相比纯组合直连至少多一个时钟周期。
最后重新跑 STA,确认 DATA/VALID 和 READY 两个方向的关键路径都被拆短,并检查新增寄存器面积与端到端延迟。此模块只适合同步时钟域;跨时钟传输必须改用带指针同步和跨域校验的异步 FIFO,不能直接复用这套计数逻辑。