
半导体与芯片 / 系统课时
缓存行未命中后谁发起填充
缓存行未命中后谁发起填充
CPU 只读取 8 字节,片上互连却可能返回整条 64 字节缓存行,甚至同时承担另一条脏行的写回。本课用一次具体地址访问追踪未命中、请求下发、数据填充与写回,算清真正发起事务的硬件和增加的流量。
学习目标
- 说明 CPU、各级缓存控制逻辑和 DDR 控制器在填充中的不同职责。
- 根据行大小、总线宽度和 AXI4 参数计算读突发的数据量。
- 区分填充缓冲、未命中跟踪项及脏行写回造成的流量。
谁把未命中变成总线请求
以普通、可缓存的 DDR 内存地址为例,CPU 的加载指令只提出读取某个地址的需求,不会亲自发送一条“去 DDR 取 64 字节”的总线命令。常见多级缓存系统的处理顺序如下:
- CPU 执行加载指令,L1 数据缓存检查目标地址是否命中;地址转换与查找可能部分并行。
- L1 未命中时,缓存控制逻辑登记这次缺失,向 L2 请求所属缓存行。如果 L2 命中,数据可从 L2 返回,不访问 DDR。
- 若下级缓存也未命中,末级缓存控制器或内存系统代理才经片上互连发出外存读事务。不同 SoC 的请求发起接口位置可能不同。
- DDR 控制器接收请求、调度 DRAM 操作并送回数据;沿途缓存根据分配策略安装缓存行,CPU 等待的加载指令取得所需字节。
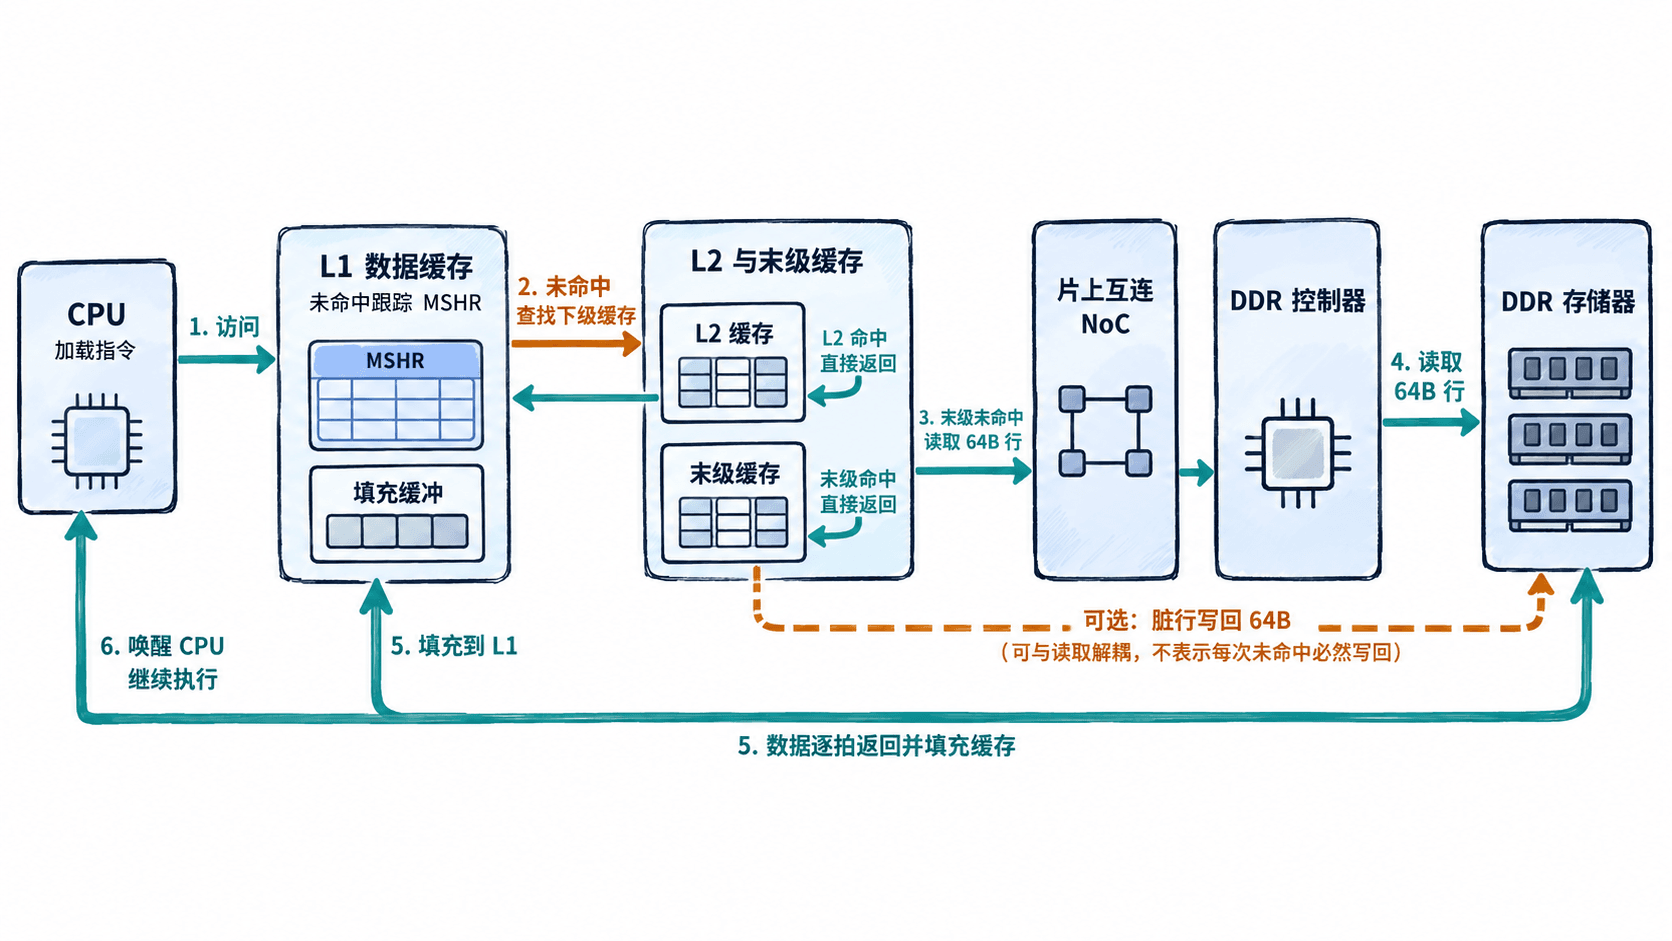
关键区别是:缓存控制器或内存系统代理负责生成填充请求,DDR 控制器负责执行收到的内存访问。单次 L1 未命中不等于一次 DDR 读取;要一路检查到末级缓存是否仍未命中。
一次 8B 读取会搬运多少数据
假设 CPU 读取物理地址 0x80001058 开始的 8 字节,缓存行大小为 64B,面向内存的 AXI4 数据通道宽度为 128 位,即每拍可传 16B。所需缓存行起点向下对齐到 0x80001040,覆盖 0x80001040~0x8000107F。
在采用对齐 INCR 突发的这个例子里,读地址通道参数为 ARADDR=0x80001040、ARLEN=3、ARSIZE=4、ARBURST=INCR。ARLEN 表示拍数减一,ARSIZE 表示每拍字节数的以 2 为底指数,因此数据通道需要 4 拍,每拍 16B。
以下 Python 3 程序可以直接保存为 cache_fill.py 并执行 python3 cache_fill.py,核对地址和传输量:
LINE_BYTES = 64
BEAT_BYTES = 16
load_addr = 0x80001058
load_bytes = 8

# 本例将行请求按缓存行边界对齐
line_addr = load_addr & ~(LINE_BYTES - 1)
beats = LINE_BYTES // BEAT_BYTES
beat_addrs = [line_addr + i * BEAT_BYTES for i in range(beats)]

# AXI4 的长度编码比实际拍数少一
print(f"行起始地址: 0x{line_addr:08X}")
print(f"AXI4: ARLEN={beats - 1}, ARSIZE={BEAT_BYTES.bit_length() - 1}, ARBURST=INCR")
print("拍地址: " + ", ".join(f"0x{x:08X}" for x in beat_addrs))
print(f"读数据载荷: {LINE_BYTES} B")
print(f"有效利用率: {load_bytes / LINE_BYTES:.1%}")
预期输出:
行起始地址: 0x80001040
AXI4: ARLEN=3, ARSIZE=4, ARBURST=INCR
拍地址: 0x80001040, 0x80001050, 0x80001060, 0x80001070
读数据载荷: 64 B
有效利用率: 12.5%
假设本次只有这条 8B 加载实际用到数据,64B 中的即时有效利用率就是 12.5%;余下 56B 并非无用,它们可能让后续访问命中缓存。示例采用完整行、对齐 INCR 访问;其他实现可能使用 WRAP、不同突发宽度或在互连中转换事务,不能把这些参数当作所有 SoC 的固定配置。
填充缓冲如何管理等待中的读
当 DDR 尚未返回时,缓存不能只记住“有一次 miss”。非阻塞缓存通常使用 MSHR(未命中状态保持项)记录缺失行地址、挂起的读取以及事务状态;行填充缓冲则负责暂存陆续返回的数据拍。两者的具体实现和合并方式由微架构决定。
例如 0x80001058 和 0x80001060 都位于起点为 0x80001040 的同一条 64B 行。如果第一条未命中尚未完成,第二次加载通常可以合并到同一个行填充请求,而不再发起另一笔 64B 外存读取。假设硬件只有 8 个可用的独立未命中跟踪项,第 9 个涉及新缓存行的未命中就可能因为资源不足而等待。
有些实现支持所需数据拍一到就先恢复 CPU 执行,称为提前重启;另一些实现需要等待整行填充。不能仅看到第二拍含有所需 8B,就断言 CPU 一定在第二拍恢复。若返回包含错误响应,也不能把填充标为有效命中。
哪些写回会使外存流量增加
填充新行可能需要腾出缓存位置。采用写回策略时,干净的被替换行可以直接丢弃;脏行含有尚未向下一层传播的修改,必须先交由下层接收或进入写回队列。L1 的脏行写回到 L2 或末级缓存,并不必然立刻写入 DDR。
以下以 64B 缓存行为例,仅统计由本次访问及其相关逐出引起的 DDR 数据载荷,不包括其他主设备的事务:
| 场景 | DDR 读数据 | DDR 写数据 | 合计 |
|---|---|---|---|
| 下级缓存命中,无需 DDR | 0B | 0B | 0B |
| 末级缺失,替换干净行 | 64B | 0B | 64B |
| 末级缺失,同时逐出一条脏行并写回 DDR | 64B | 64B | 128B |
第三种情况多出的 64B 是被逐出的旧行,不是把新读取的数据再次写一遍。写回可以排队、与读取重叠,所以上表是字节量,不是延迟加倍的结论。写直达缓存的写流量规则也不同;实际物理接口流量还受其他主设备、预取和控制器调度影响。
用互连波形验证填充
在可观测到 AXI4 接口的仿真环境中,先确保测试地址为可缓存 DDR 区域,并尽量排除预取及其他主设备干扰,再按顺序检查:
- 确认 L1 与下级缓存都未命中,找到一次
ARVALID && ARREADY的读地址握手;在本例的观测接口应看到ARADDR=0x80001040、ARLEN=3、ARSIZE=4。 - 检查
RVALID && RREADY是否完成 4 次数据握手;第四拍应带有RLAST=1,并检查RRESP是否表示正常完成。 - 对照填充缓冲的有效位或缓存行状态,确认所需数据返回后加载才完成;如果下级缓存命中,则不应强求 DDR 接口出现相同请求。
- 若外存写流量增加,另查
AW、W、B通道和脏行逐出记录,不要把一次 L1 替换直接算成 DDR 写事务。
真实芯片不一定开放内部波形,可结合末级缓存未命中计数器和内存控制器读写字节计数器排查,但计数通常混有 DMA、预取和其他核心的流量。判断带宽时应分别核算CPU 实际使用的字节、缓存行填充字节和最终写回 DDR 的字节。