
半导体与芯片 / 系统课时
估算链路带宽与争用等待时间
估算链路带宽与争用等待时间
总线标称 4 GB/s,不代表 CPU 与 DMA 并发访问时各能获得 4 GB/s。本篇用一条 128 位、250 MHz 的共享链路,算清有效吞吐、突发长度造成的阻塞,以及该用哪些计数验证性能瓶颈。
学习目标
- 根据位宽、频率和成功握手次数计算单向带宽。
- 按突发轮询计算 CPU、DMA 的吞吐份额与仲裁等待。
- 运行 Python 算例,区分链路饱和、仲裁等待与接收方背压。
从接口参数算到有效吞吐
先选定观察点:CPU 与 DMA 共用的读数据出口。假设位宽为 128 bit,时钟为 250 MHz,每周期最多传输一拍,且数据对齐、满宽。一拍是一次成功的数据握手;有停顿时,一拍数据可能等待多个周期。
理论带宽为 ,所以 B/s,即 4000 MB/s。本文采用十进制单位,1 MB 等于 B;一个时钟周期为 4 ns。
实际吞吐必须使用完整观测时间。令 为成功传输的有效字节数, 为观测窗口的全部周期数,包含空闲、仲裁开销和背压,则:
例如 100 个周期内完成 80 次满宽数据握手,传输 1280 B,用时 400 ns,吞吐就是 3200 MB/s,达到理论值的 80%。只统计正在传数据的周期,会把等待时间漏掉。
AXI 的读、写数据通道彼此独立,可以并行工作。本篇只计算一个读数据出口;读写合计吞吐应使用对应的合计上限。此处使用片上接口时钟,DDR 物理接口的传输速率另行计算。genui{"citation":{"ref":"turn1view0"}}
用一轮服务计算份额与等待
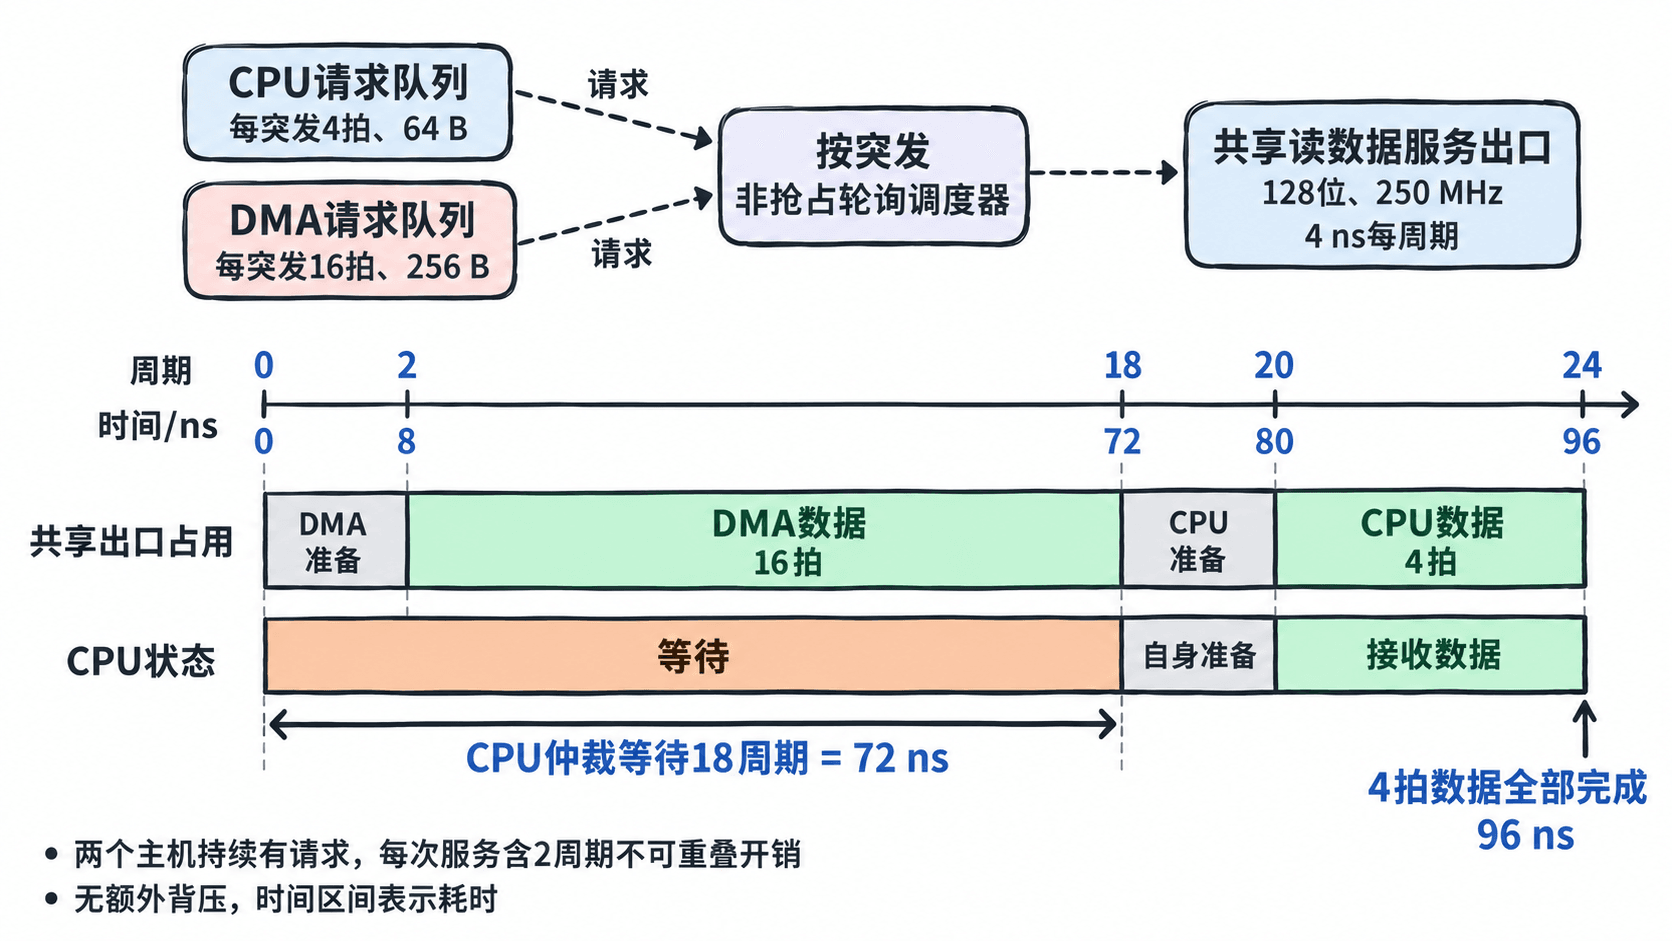
采用一个可手算的模型:CPU 与 DMA 始终有请求,按突发非抢占轮询,每轮各服务一次。每次服务先占用 2 个准备周期,再逐周期传数据;准备开销不可与其他服务重叠,基线没有额外停顿。
若突发包含 拍数据,服务过程中额外停顿 个周期,则占用时间为 个周期。基线取 ,两个主机的服务量如下:
| 请求方 | 每突发有效数据 | 准备开销 | 每次服务占用 |
|---|---|---|---|
| DMA | 16 拍,256 B | 2 周期 | 18 周期 |
| CPU | 4 拍,64 B | 2 周期 | 6 周期 |
整轮需要 24 个周期,即 96 ns,共传输 320 B,总吞吐为 3333.33 MB/s。CPU 获得 666.67 MB/s,DMA 获得 2666.67 MB/s。两者都必须除以整轮时间;轮询次数相同,传输字节数仍是 1∶4。
设 时两者都已就绪,本轮先选 DMA,CPU 请求位于自己的队首。CPU 等待 18 周期,即 72 ns 后获准;再准备 2 周期,于 80 ns 开始数据阶段,4 拍数据全部完成于 96 ns。
按该轮询规则,已就绪的 CPU 队首请求最多被一次 DMA 服务挡住,因此 18 周期也是基线最大仲裁等待。额外背压会延长 DMA 服务,必须一起加入等待估算。
运行算例比较突发长度
下面是可直接运行的 Python 3.8 及以上版本程序,无第三方依赖。保存为 bandwidth.py,执行 python3 bandwidth.py。它依次计算基线、DMA 每次服务额外停顿 4 周期,以及 DMA 突发加长到 64 拍的情况。
def main():
    bytes_per_beat = 128 // 8
    freq_hz = 250_000_000
    cycle_ns = 1_000_000_000 / freq_hz
    cpu_beats = 4
    overhead = 2  # 每次服务独占出口的固定开销,是算例假设
    for dma_beats, dma_stalls in ((16, 0), (16, 4), (64, 0)):
        cpu_cycles = overhead + cpu_beats
        dma_cycles = overhead + dma_beats + dma_stalls
        round_cycles = cpu_cycles + dma_cycles
        # 两个主机的吞吐都必须除以整轮时间。
        scale = bytes_per_beat * freq_hz / round_cycles / 1_000_000
        cpu_bw = cpu_beats * scale
        dma_bw = dma_beats * scale
        # t=0 两者就绪且先服务 DMA;CPU 自身没有更早的排队请求。
        wait_ns = dma_cycles * cycle_ns
        done_ns = round_cycles * cycle_ns
        print(f"DMA={dma_beats}, stalls={dma_stalls}, round={round_cycles} cycles")
        print(f"MB/s total={cpu_bw + dma_bw:.2f}, CPU={cpu_bw:.2f}, DMA={dma_bw:.2f}")
        print(f"CPU wait={wait_ns:.0f} ns, data_done={done_ns:.0f} ns")

if __name__ == "__main__":
    main()
预期输出:
DMA=16, stalls=0, round=24 cycles
MB/s total=3333.33, CPU=666.67, DMA=2666.67
CPU wait=72 ns, data_done=96 ns
DMA=16, stalls=4, round=28 cycles
MB/s total=2857.14, CPU=571.43, DMA=2285.71
CPU wait=88 ns, data_done=112 ns
DMA=64, stalls=0, round=72 cycles
MB/s total=3777.78, CPU=222.22, DMA=3555.56
CPU wait=264 ns, data_done=288 ns
wait 是 CPU 队首请求等待获准的时间,data_done 是从共同起点到 CPU 数据全部完成的时间。额外 4 周期停顿使等待增加 16 ns;64 拍突发使总吞吐比基线提高约 13.3%,但 CPU 吞吐降为三分之一。
若设计要求 CPU 的仲裁等待不超过 100 ns,前两种情况满足该模型的预算,64 拍方案不满足。调整 DMA 突发长度时,应同时验收总吞吐与 CPU 等待,而不能只比较搬运速度。
用同一窗口定位性能损失
验证时固定时钟、目标地址范围和缓存状态,分别运行 CPU 单独访问、DMA 单独访问、两者并发三个场景。保持各主机突发参数一致,并确认 CPU 请求确实到达监测出口,避免把缓存命中误认为出口性能改善。
对于 AXI,读数据只在时钟上升沿 RVALID 与 RREADY 同时为 1 时计入;写数据对应 WVALID 与 WREADY。满宽对齐读每次计 16 B;写入则累计 WSTRB 中值为 1 的位数,不能把部分字节写入也记成 16 B。genui{"citation":{"ref":"turn3view1"}}
例如窗口取 25000 周期,即 100 μs;若得到 20000 次满宽读握手,应累计 320000 B,吞吐为 3200 MB/s。按主机归属分别计数后,两者字节数之和应等于共享出口的总字节数。
| 观测现象 | 优先检查与验证动作 |
|---|---|
| 出口接近每周期一次数据握手,CPU 等待增加 | 检查出口容量和份额;缩短 DMA 突发后复测 CPU 等待 |
| 出口存在空闲,CPU 队首已就绪却长期未获准 | 检查仲裁策略、配额和发射限制,记录就绪到获准的周期差 |
RVALID=1、RREADY=0 的周期很多 |
检查接收方 FIFO 空间与消费速度,这是返回通道的背压 |
有未完成读请求,但 RVALID=0 的周期很多 |
检查下游数据准备、存储访问延迟及可并行请求数 |
72 ns 的等待上界依赖两主机轮询、DMA 服务时长有界,以及 CPU 自身无更早排队请求。下游停顿无上界,或固定优先级让持续请求的 DMA 始终获胜时,就不能继续承诺该上界。实测最大值与平均值应分开记录。