
半导体与芯片 / 系统课时
描述符链表怎样驱动 DMA 搬运
描述符链表怎样驱动 DMA 搬运
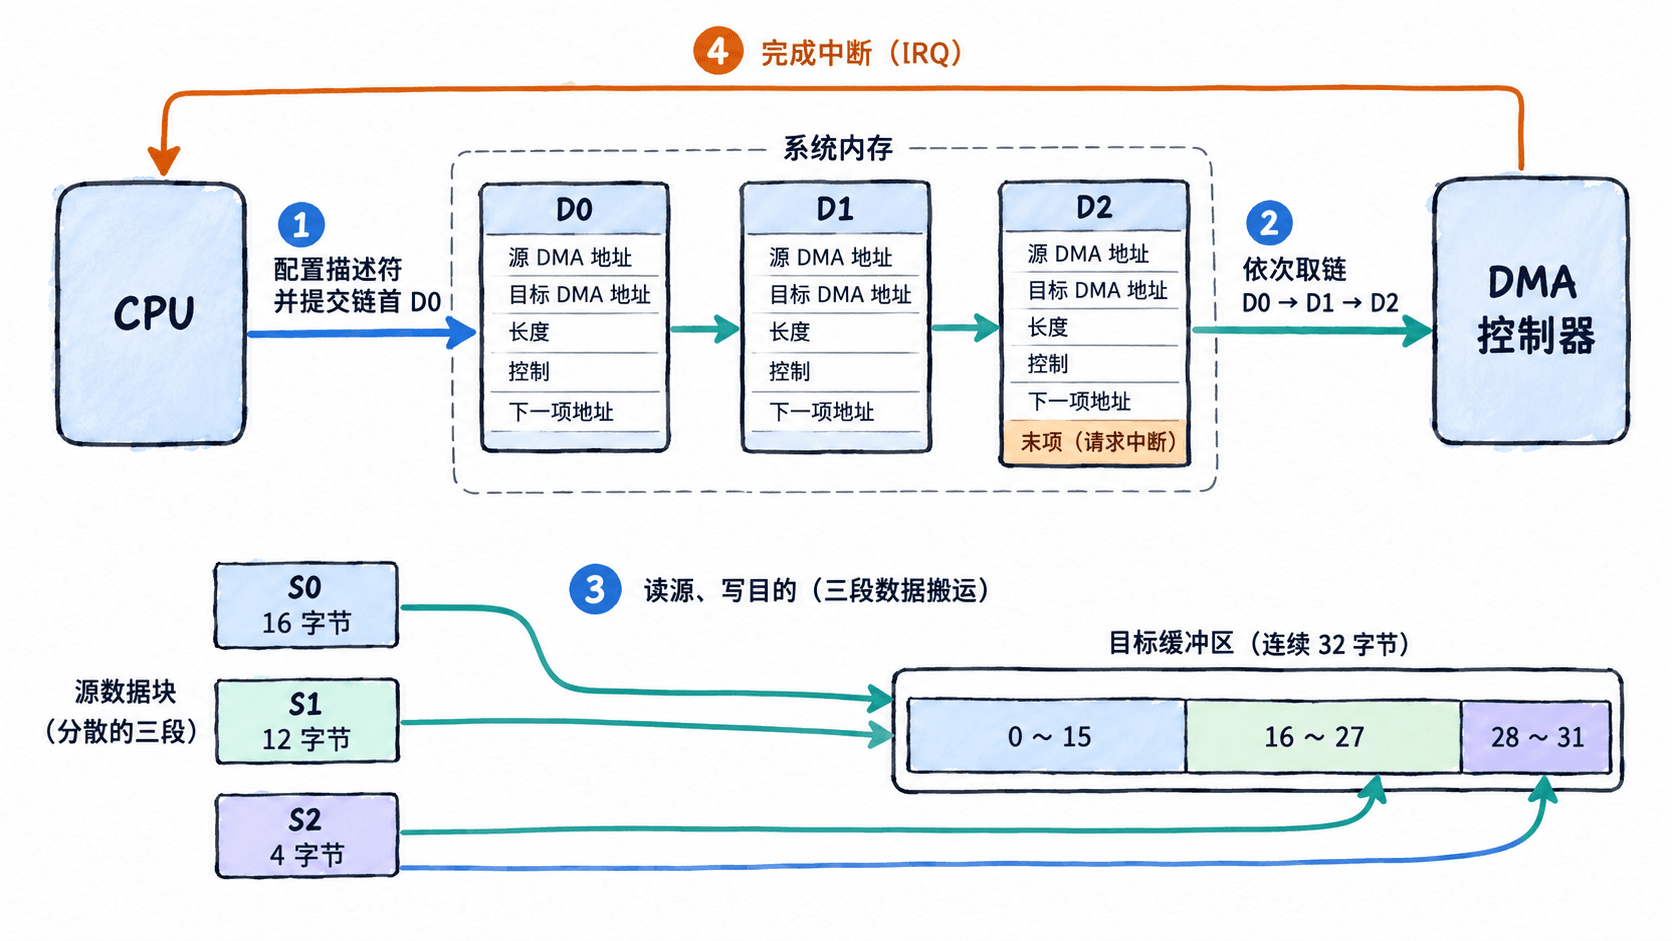
需要将多个分散的数据块拼接到目标缓冲区时,CPU 不必为每一块重复启动 DMA。它先在内存中准备描述符,再提交链首地址;支持链式模式的 DMA 控制器会逐项取描述符、搬运数据,并按控制信息结束或发出中断。下面用三段共 32 字节的数据说明全过程。
学习目标
- 识别描述符的源地址、目标地址、长度、控制位和下一项地址。
- 解释 DMA 如何从链首自主完成三段搬运并触发末项中断。
- 用可运行的 C11 模拟程序验证链表顺序,并排查真机上的地址与缓存问题。
描述符如何组织分散数据
常见链式 DMA 描述符保存五类信息:源 DMA 地址、目标 DMA 地址、传输长度、控制标志和下一描述符的 DMA 地址。控制标志可能包含末项、完成中断或所有权位,但实际布局和位定义由具体 DMA 控制器决定,不能套用统一寄存器格式。
假设三个源缓冲区 S0、S1、S2 在内存中彼此不连续,目标是长度为 32 字节的连续缓冲区:
| 描述符 | 源缓冲区 | 目标偏移 | 长度 | 结束条件 | 下一项 |
|---|---|---|---|---|---|
| D0 | S0 | 0 | 16 字节 | 继续 | D1 |
| D1 | S1 | 16 | 12 字节 | 继续 | D2 |
| D2 | S2 | 28 | 4 字节 | 末项并请求中断 | 无 |
三段长度相加为 16 + 12 + 4 = 32 字节,写入范围分别是目标缓冲区的 [0,16)、[16,28) 和 [28,32),互不重叠。描述符本身可以独立于数据区存放;下一项字段描述的是取链顺序,不代表数据块必须连续。
DMA 如何沿链表执行
CPU 与 DMA 都可能通过片上互连访问系统内存,但职责不同:CPU 构造描述符并提交链首;DMA 成为总线发起方,读取描述符指定的数据,再写入目标地址。一次典型的链式提交按下面的顺序进行:
- 为 S0~S2 和目标缓冲区取得设备可访问的 DMA 地址,准备 D0、D1、D2,并填写长度和目标偏移。
- 将 D0 的下一项设为 D1,D1 指向 D2;按控制器规定给 D2 设置末项与中断标志。链接字段填写DMA 地址而不是 CPU 虚拟指针。
- 确保数据及描述符已对设备可见,按硬件要求执行内存屏障,再向控制器提交 D0 的 DMA 地址并启动通道。
- 控制器依次取 D0、D1、D2,每项完成源端读取和目的端写入后再处理下一项;碰到末项后停止,并在请求中断且通道允许中断时上报完成。
- CPU 在收到完成通知后读取状态、核对传输结果,再安全地读取目的缓冲区并回收描述符。
用 C11 模拟三段搬运
下面的程序用内存指针模拟描述符链接,用 memcpy 模拟 DMA 对数据的搬运。它是 CPU 执行的软件模型,不会启动真实 DMA 硬件;CTRL_LAST 和 CTRL_IRQ 仅为教学定义,不能直接当作芯片寄存器位值。将代码保存为 dma_chain.c,在装有 GCC 或 Clang 的环境执行 cc -std=c11 -Wall -Wextra dma_chain.c -o dma_chain && ./dma_chain。
#include <stdio.h>
#include <string.h>

enum { CTRL_LAST = 1u, CTRL_IRQ = 2u };

typedef struct Desc {
    const char *src;
    char *dst;
    size_t bytes;
    unsigned ctrl;
    const struct Desc *next;
} Desc;

static void simulate(const Desc *d) {
    for (unsigned i = 0; d != NULL; d = d->next, ++i) {
        // DMA 模型先取当前描述符,再按长度搬运一段
        if (d->bytes == 0 || d->src == NULL || d->dst == NULL) {
            puts("ERROR: invalid descriptor");
            return;
        }
        memcpy(d->dst, d->src, d->bytes);
        printf("D%u: %zu bytes\n", i, d->bytes);

        // 末项控制本次链式执行的结束与通知
        if (d->ctrl & CTRL_LAST) {
            if (d->ctrl & CTRL_IRQ) puts("IRQ: complete");
            return;
        }
    }
    puts("ERROR: missing last descriptor");
}

int main(void) {
    const char s0[] = "ABCDEFGHIJKLMNOP"; // 16 字节
    const char s1[] = "QRSTUVWXYZ12";     // 12 字节
    const char s2[] = "3456";             // 4 字节
    char dst[33] = {0}; // 预留字符串结束符,便于验证

    Desc d2 = {s2, dst + 28, 4, CTRL_LAST | CTRL_IRQ, NULL};
    Desc d1 = {s1, dst + 16, 12, 0, &d2};
    Desc d0 = {s0, dst,      16, 0, &d1};

    simulate(&d0);
    printf("result: %s\n", dst);
    return 0;
}
预期输出:
D0: 16 bytes
D1: 12 bytes
D2: 4 bytes
IRQ: complete
result: ABCDEFGHIJKLMNOPQRSTUVWXYZ123456
程序从 d0 开始访问 next,并不要求三个描述符在内存中相邻;目标缓冲区则按 0、16、28 的偏移连续写入。最后的 IRQ: complete 只是模拟中断事件的打印,不代表操作系统真的收到了硬件中断。
真机移植时重点检查什么
在真实 SoC 上,CPU 虚拟地址、物理地址与设备看到的 DMA 地址可能不同,尤其启用 IOMMU 后不能把普通指针强转后填入硬件描述符。在 Linux 内核驱动中,可用 dma_alloc_coherent() 分配设备可见的描述符内存,使用 dma_map_single() 映射适合的传输缓冲区,完成后根据方向调用 dma_unmap_single();这些内核接口不能直接在上面的用户态示例中调用。
检查链式 DMA 是否正常时,优先核对以下项目:
- 只执行 D0:确认 D0 的
next填的是 D1 的 DMA 地址,D1 描述符已经写入且对设备可见;再核对链模式是否开启。 - 结果偶尔是旧数据:非缓存一致性平台必须按 DMA API 同步源缓冲区、目标缓冲区和描述符的可见性;描述符有所有权位时,在交给设备之前做好必要的写入排序。
- 搬运完成却无中断:逐项检查 D2 的完成中断标志、通道中断使能、屏蔽状态和中断状态清除方式,而不是假设设置末项就一定产生 IRQ。
- 报总线错误或数据越界:检查地址对齐、单项最大长度、DMA 地址宽度以及是否禁止跨越某种地址边界;这些限制取决于芯片手册,不能套用固定的 4 KiB 规则。
对于循环描述符环,末项可能重新指向 D0,而不再表示一次任务结束。此时还需依据控制器的所有权与生产消费规则更新描述符,绝不能在 DMA 仍可能读取某项时将其覆盖。