
半导体与芯片 / 系统课时
CPU 读请求如何抵达 DDR
CPU 读请求如何抵达 DDR
一次 CPU Load 指令并不一定访问 DDR:数据可能直接来自缓存。只有缓存层级和其他一致性数据源都无法满足读取时,请求才需要继续进入内存系统。本篇以一次 8 字节 Load 为例,追踪地址翻译、缓存未命中、片上互连、DDR 控制器以及数据返回的完整路径。
学习目标
- 解释 Load 指令在什么条件下会产生 DDR 读取请求。
- 识别 CPU 缓存、片上互连、DDR 控制器和 DDR PHY 的职责与数据流向。
- 根据缓存行大小和 AXI4 总线宽度,计算一次缓存行填充所需的读突发参数。
Load 如何变成片外内存请求
假设一颗支持虚拟内存和多级缓存的 Arm SoC 正在执行一条 AArch64 指令 LDR X0, [X1],其中 X1 保存虚拟地址 0x40001234。该指令希望读取连续 8 字节,并把结果写入寄存器 X0。
从指令执行到决定访问 DDR,通常涉及以下过程:
- 计算有效地址:Load/Store 单元根据指令和寄存器得到虚拟地址
0x40001234。 - 地址翻译:MMU 通过 TLB 中的映射获取物理地址。假设本例翻译结果为
0x80001234;TLB 未命中时还可能触发页表遍历。 - 查询缓存:处理器查找 L1 数据缓存,未命中后继续查询 L2 以及可能存在的系统级缓存。实际实现中,部分地址翻译和缓存查询可以并行进行。
- 形成缺失请求:如果所有相关缓存都未命中,且其他一致性缓存不能提供有效数据,缓存控制逻辑才向片上内存系统发起读取请求。
还需要区分指令读取宽度和外部存储器传输宽度。一条 8 字节 Load 可能触发整条 64 字节缓存行填充,因此外部读流量可以大于指令实际需要的数据量。
读请求怎样穿过片上互连
建立一个具体的示例系统:CPU 使用 64 字节缓存行,SoC 把 0x80000000 至 0xBFFFFFFF 的 1 GiB 物理地址空间映射到 DDR,缓存系统通过 AXI4 兼容的片上互连访问 DDR 控制器。
CPU 缓存控制逻辑发出的读请求并不是直接送到 DDR 芯片,而是先经过片上互连。互连根据物理地址完成目标译码,把请求路由到 DDR 控制器端口。如果 DMA 或其他 CPU 同时访问相同出口,还可能需要经过仲裁和队列等待。
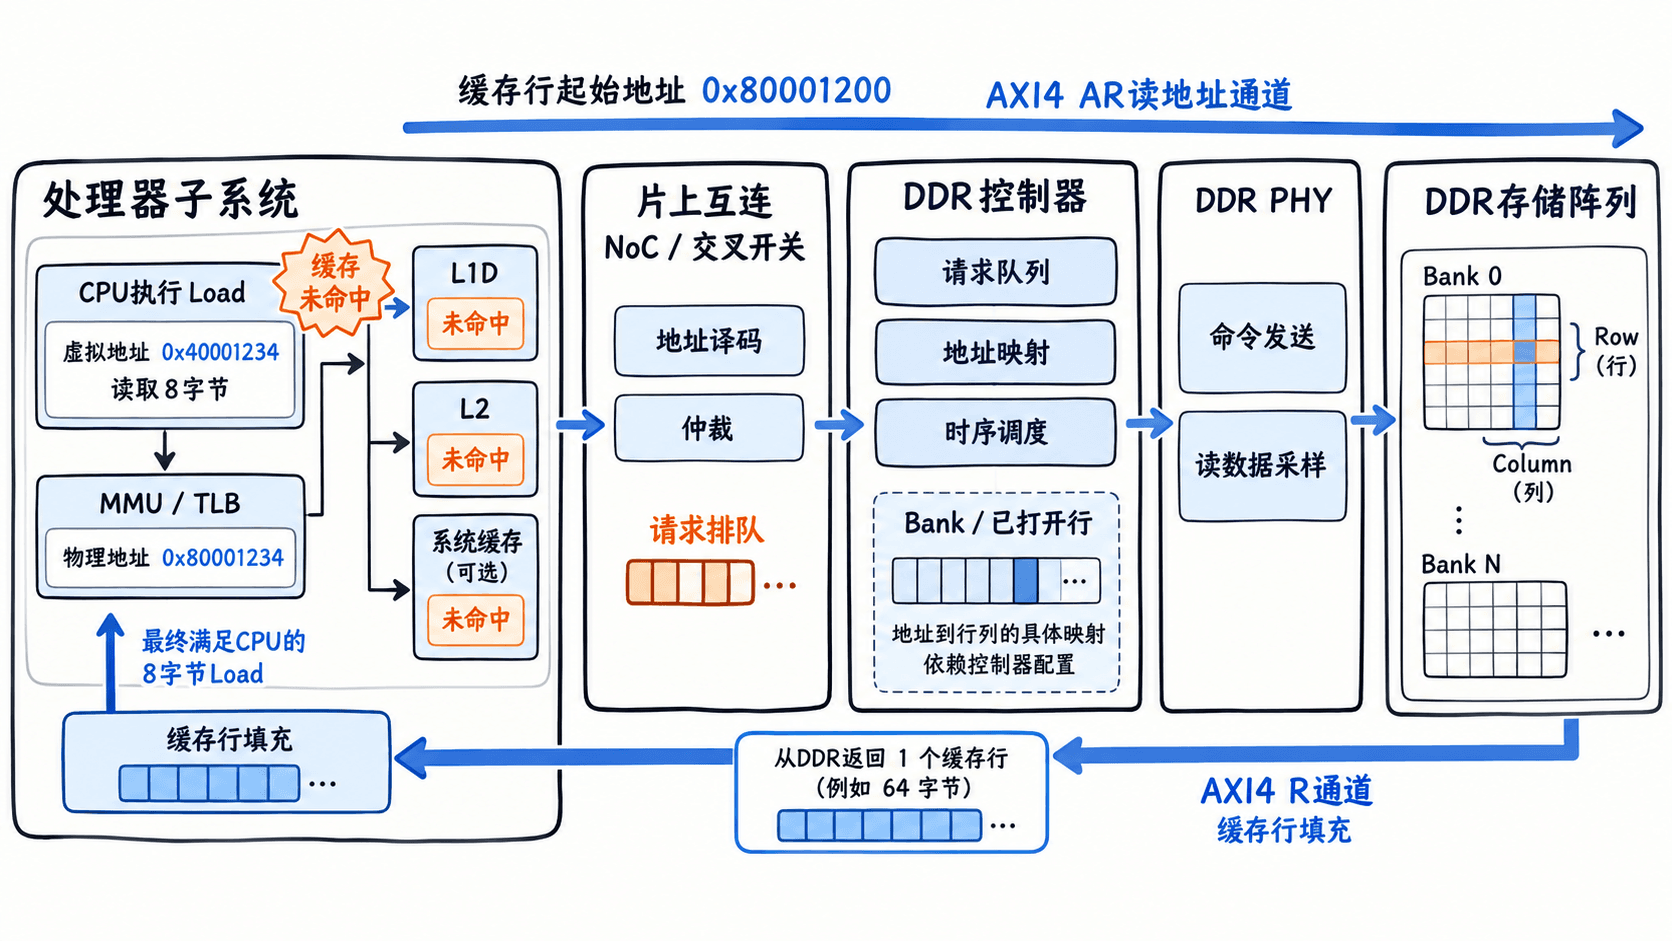
沿图中的请求方向,主要组件各负其责:
- CPU 缓存控制逻辑:决定读取哪个缓存行,以及是否需要发起外部请求。
- 片上互连:传递地址、控制信息和返回数据,完成目标路由、仲裁及必要的协议转换。
- DDR 控制器:接收内存读事务,进行地址映射、请求排队和 DRAM 时序调度。
- DDR PHY:处理与 DDR 设备之间的物理时序、电气接口及读数据采样。
- DDR 芯片:按照接收到的 DRAM 命令访问存储阵列,并通过数据接口返回内容。
这里至少存在两个不同层次的协议:片上互连可能使用 AXI4 或其他一致性互连协议,而 DDR 控制器面向 DRAM 产生的是 ACT、READ、PRE 等存储器命令。不能把 AXI4 读地址握手误认为 DDR 已经执行了 READ 命令。
计算一次缓存行填充的 AXI4 突发
继续使用物理地址 0x80001234。假设缓存行大小为 64 字节,片上 AXI4 读数据通道宽度为 64 位,并且缓存控制逻辑选择一次 INCR 突发读取完整缓存行。
缓存行的起始地址必须按 64 字节对齐,因此当前访问所在的缓存行为 0x80001200 至 0x8000123F。原始 Load 的地址位于该行内偏移 52 字节处。
在这一特定配置中,AXI4 读事务参数如下:
| 参数 | 示例取值 | 含义 |
|---|---|---|
ARADDR |
0x80001200 |
突发起始物理地址 |
ARLEN |
7 |
实际传输 8 拍 |
ARSIZE |
3 |
每拍 2 的 3 次方,即 8 字节 |
ARBURST |
INCR |
每拍地址递增 |
| 总读取量 | 64 字节 | 8 拍乘以每拍 8 字节 |
可以使用 Python 3 运行下面的完整示例,检查地址对齐和突发参数。它计算的是教学模型中的请求,不会真正访问 DDR 或控制硬件总线。
pa = 0x80001234
ddr_start, ddr_end = 0x80000000, 0xC0000000
line_bytes, beat_bytes = 64, 8

# 示例假设:64B 缓存行,64bit AXI4 数据通道。
assert ddr_start <= pa < ddr_end
assert line_bytes % beat_bytes == 0
line_addr = pa - pa % line_bytes
beats = line_bytes // beat_bytes
arsize = beat_bytes.bit_length() - 1

print(f"PA=0x{pa:08X}, 行内偏移={pa - line_addr}B")
print(f"ARADDR=0x{line_addr:08X}")
print(f"ARLEN={beats - 1}, ARSIZE={arsize}, ARBURST=INCR")
预期输出:
PA=0x80001234, 行内偏移=52B
ARADDR=0x80001200
ARLEN=7, ARSIZE=3, ARBURST=INCR
AXI4 使用 ARLEN + 1 表示实际突发拍数,ARSIZE 表示每拍字节数的以 2 为底的对数。读地址通道只有在 ARVALID 与 ARREADY 同时为高的采样边沿才完成握手。
DDR 控制器怎样完成真正的读取
片上互连接收并转发请求后,DDR 控制器通常会先把事务放入请求队列,再按照控制器配置将物理地址映射为通道、Rank、Bank Group、Bank、Row 和 Column 等信息。具体使用哪些位进行映射,以及是否进行地址交织,都由 SoC 的内存控制器实现决定。
DDR 是按行组织的动态存储器。控制器是否需要先打开目标行,会直接影响这次读取的等待时间。
| 目标 Bank 的行状态 | 简化命令顺序 | 性能影响 |
|---|---|---|
| 目标行已经打开 | READ | 可以省去重新激活目标行 |
| 当前没有打开的行 | ACT、READ | 激活后需满足 tRCD 等时序约束 |
| 打开的是其他行 | PRE、ACT、READ | 还需满足预充电时间 tRP 等约束 |
例如,CPU 连续访问落在同一已打开 DRAM 行内的两个缓存行,第二次请求可能获得 Row Hit;如果第二次访问的是同一个 Bank 的另一行,就可能遇到 Row Conflict,需要先关闭旧行再激活新行。
实际控制器还要处理刷新、不同 Bank 的并行访问、读写切换与请求调度。即使两个 CPU Load 最终访问同一 DDR 控制器,它们的完成顺序和延迟也不一定相同。上述命令顺序是简化模型,并未展开所有 DDR 代际与时序条件。
当 READ 命令完成对应的数据获取后,DDR 芯片通过数据引脚和选通信号返回数据。DDR PHY 负责接收和采样,内存控制器再将数据整理为片上互连能够接受的读响应。
数据返回后 CPU 怎样完成 Load
在本例 AXI4 读取中,DDR 控制器接口通过读数据通道返回 8 拍数据。每拍只有在 RVALID 和 RREADY 同时为高时才完成传输;最后一拍以 RLAST=1 标记。正常完成时,读响应状态可以为 RRESP=OKAY。
读数据经过片上互连返回请求方,缓存控制逻辑接收相应数据并完成缓存行填充。CPU 最初需要的只有从 0x80001234 开始的 8 字节,缓存系统会从返回的缓存行中选出该部分,满足等待中的 Load。某些微架构允许关键数据先到先用,不必等整条缓存行全部填充完成。
实际分析性能或总线波形时,可按以下顺序检查:
- 确认是否真的访问 DDR:检查 L1/L2 缓存缺失及系统级缓存、一致性缓存的命中情况,不要把每条 Load 都计为 DDR 请求。
- 确认请求是否发出:在对应 AXI4 接口观察
ARVALID、ARREADY、ARADDR、ARLEN和ARSIZE,记录读地址完成握手的位置。 - 定位等待阶段:区分互连仲裁等待、DDR 控制器排队、行激活以及实际读数据返回等阶段。
- 确认数据完整返回:检查
RVALID、RREADY、RRESP和RLAST,确保所需数据已经被成功接收。
判断读延迟时还要注意,TLB 未命中引发的页表遍历可能产生额外内存请求,缓存一致性处理也可能改变数据来源。仅凭一条 CPU Load 指令,无法直接推断实际 DDR 请求次数。
对这个 8 字节读取案例,最重要的验证结果是:CPU 访问的物理地址为 0x80001234,在所选配置中缓存缺失请求读取从 0x80001200 开始的 64 字节缓存行;互连负责传输片上事务,DDR 控制器负责调度 DRAM 命令,最终返回数据才由缓存系统交付给 CPU。