
半导体与芯片 / 系统课时
TCM 与 Cache 的延迟差在哪
TCM 与 Cache 的延迟差在哪
同样一次 CPU 读取,访问 TCM、命中 Cache 与发生 Cache 未命中,等待周期可能相差数十倍。本课以 Cortex-M7 类 SoC 为例,梳理存储访问路径、计算延迟差,并为实时指令、数据和 DMA 缓冲区选择合适的存储区域。
学习目标
- 区分 TCM 直达访问与 Cache 命中、未命中路径。
- 用命中率估算平均访问延迟,并识别最坏情况风险。
- 按实时截止时间和 DMA 可达性安排代码、数据与缓冲区。
CPU 为何走不同的存储路径
TCM(紧耦合存储器)是映射到处理器地址空间的本地存储区。以 Cortex-M7 为例,ITCM 常放关键指令,DTCM 常放关键数据;CPU 通过专用接口访问对应 TCM,不必先查 L1 Cache。
软件通过链接脚本和启动初始化决定内容的位置。TCM 访问通常不必穿过外部存储器互连,因此能减少总线争用带来的延迟波动。
Cache 保存主存数据或指令的副本。命中时由 I-Cache 或 D-Cache 快速返回;未命中时要经互连访问下级 SRAM 或 DDR,再获取数据并可能回填 Cache。
是否命中取决于先前访问、替换策略和工作集大小。Cache 没有供应用程序独立选择的物理地址段,与 TCM 的软件显式放置方式不同。
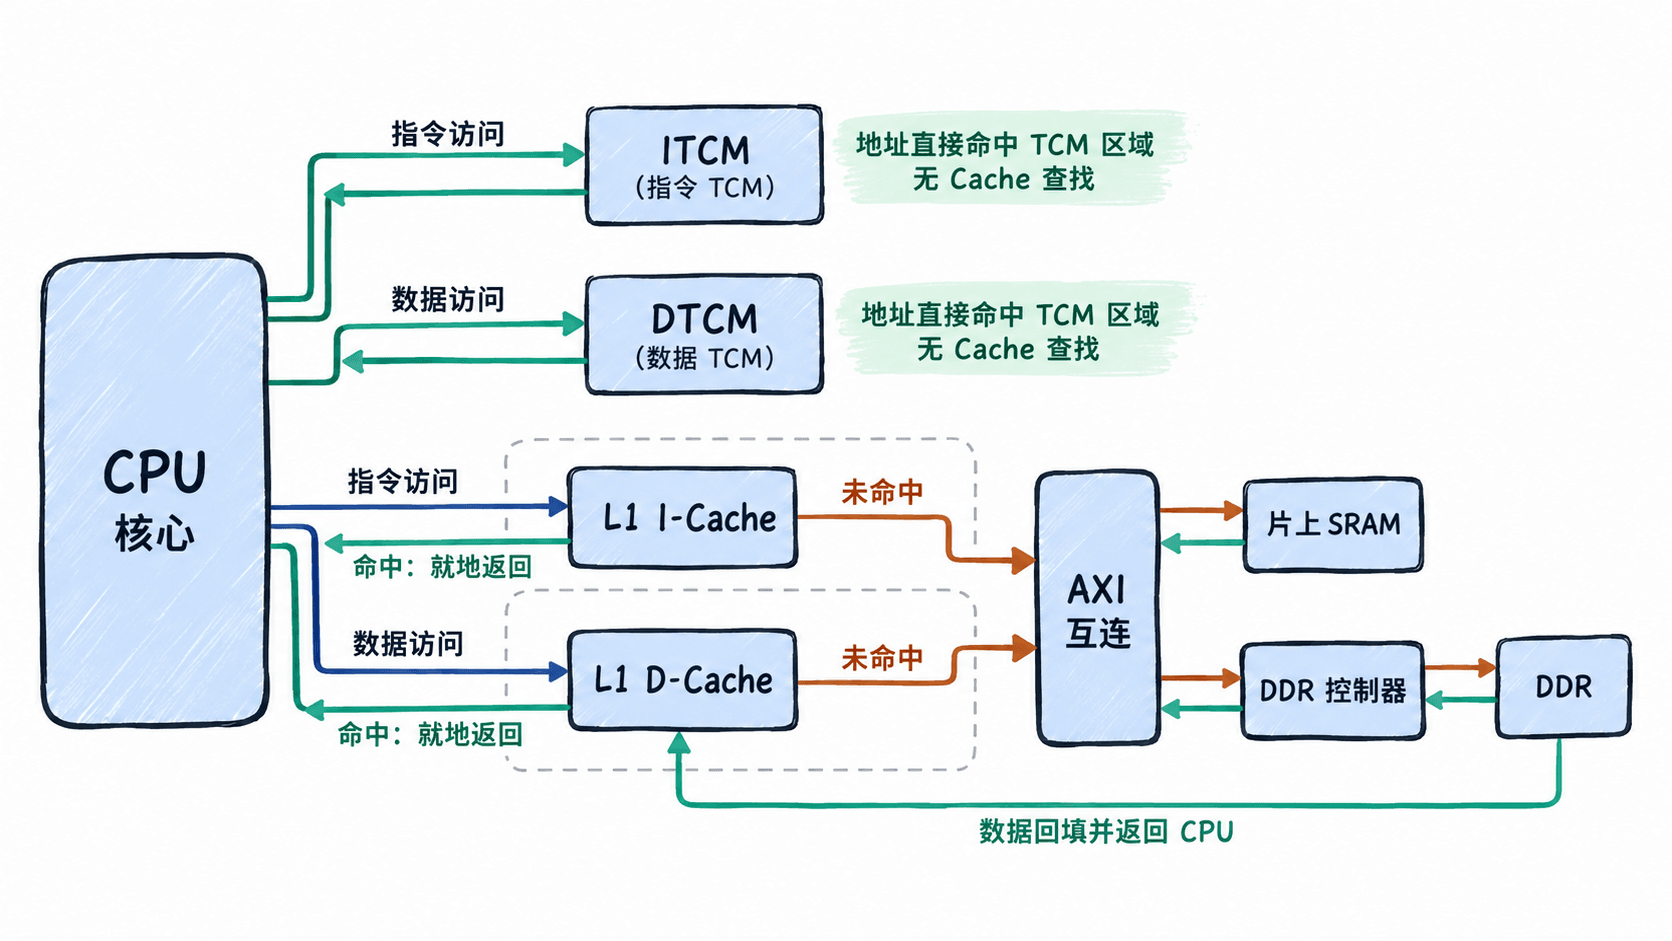
延迟差究竟有多大
先用一组教学假设比较单次读取:TCM 为 1 周期,Cache 命中为 2 周期,Cache 未命中并完成下级读取为 80 周期。80 周期已包含未命中的全部等待,不是在 2 周期上再加 80;这些数值不是芯片规格。
| 访问情况 | 单次延迟 | 决定因素 |
|---|---|---|
| TCM 读取 | 1 周期 | 专用接口及本地存储器实现 |
| Cache 命中 | 2 周期 | 标签查找及缓存数据读取 |
| Cache 未命中 | 80 周期 | 下级存储器、互连争用及回填 |
运行下面的 Python 3 小程序,可以改变未命中率观察平均值:
def main():
    # 单次访问成本仅用于教学,不代表实际芯片测量值
    tcm, hit, miss = 1, 2, 80
    for miss_rate in (0.0, 0.05, 0.20):
        average = (1 - miss_rate) * hit + miss_rate * miss
        # 平均值会掩盖一次未命中的长等待
        print(f"未命中率={miss_rate:.0%} Cache均值={average:.1f}周期 TCM={tcm}周期")

if __name__ == "__main__":
    main()
预期输出:
未命中率=0% Cache均值=2.0周期 TCM=1周期
未命中率=5% Cache均值=5.9周期 TCM=1周期
未命中率=20% Cache均值=17.6周期 TCM=1周期
即使未命中率只有 5%,一次读取仍可能耗时 80 周期。主频为 400 MHz 时,80 周期相当于 200 ns;DDR 排队可能让等待进一步增加。硬实时设计要核算最坏执行时间,不能只看 5.9 周期的平均值。
实时任务如何分配存储区
假设某 SoC 提供 16 KiB ITCM、32 KiB DTCM,并以 100 μs 周期运行电机控制中断。这是容量规划示例,实际容量必须查询芯片内存映射和链接文件。
- 将约 4 KiB 的中断处理及控制环热点指令放入 ITCM,并检查启动时是否已从非易失存储器复制到位。
- 将约 8 KiB 的状态、系数和关键任务栈放入 DTCM,避免控制路径依赖 Cache 是否命中。
- 将日志、图像、较大的查表数据留在可缓存的片上 SRAM 或 DDR;这些数据适合利用容量与局部性,不必占用有限的 TCM。
- 将 DMA 收发缓冲区放在该 DMA 控制器确实可访问的存储区;若采用可缓存 SRAM,应按芯片规定处理 D-Cache 的清理、失效及缓冲区对齐。
怎样验证延迟与实时性
先检查链接生成的 .map 文件,确认关键函数和变量落在 ITCM/DTCM 的有效地址范围。仅给变量取名为 dtcm_buffer 并不会改变存储位置。
再用 Cortex-M7 的 DWT->CYCCNT 在目标板上记录周期数,分别测试 TCM 读取、Cache 预热后的读取,以及工作集超过 Cache 容量时的读取。
每类场景可重复至少 10000 次,统计平均值、最大值与延迟分布;测量时记录优化级别、主频、中断及 DMA 负载,并扣除计数操作本身的开销。为防止编译器把读取优化掉,需要让测试产生可观察的结果。实测最大值只是观测值,不等于已经证明的最坏上界。
如果控制任务无法容忍偶发长等待,优先将其关键指令与状态放入 TCM;若主要目标是大容量数据吞吐,且允许命中率变化造成抖动,Cache 通常更划算。