
PostgreSQL / 系统课时
确定时间分区粒度
确定时间分区粒度
时间分区不是越细越好。日、周、月分区会同时影响单分区数据量、查询需要访问的分区数、归档操作的最小单位以及数据库对象数量。本课建立一套可计算、可验证的粒度选择方法,并用月分区与日分区的裁剪范围理解实际差异。
学习目标
- 从数据量、查询跨度、维护周期和分区数量评估时间粒度
- 判断日、周、月分区分别适合什么工作负载
- 使用执行计划检查一个典型查询会访问多少个分区
先确定四个约束
选择粒度前至少要收集四个量:单位时间写入量、典型查询时间跨度、归档或删除频率,以及计划保留多长时间。它们共同决定“一个分区应该承载多少数据”和“一个查询通常需要跨多少分区”。
例如,每天新增 5 GB、通常查询最近 30 天、每月归档一次、在线保留 12 个月时,月分区往往比日分区更自然。若每天新增数百 GB,并且维护必须以单日为窗口,月分区可能过大,日分区会更容易控制索引构建、迁移和删除的单次影响范围。
估算粒度而不是凭感觉选择
可以先用两个简单估算量筛选候选方案。假设在线保留天数为 ,每个分区覆盖天数为 ,则时间维度上的分区数量大约为:
如果典型查询跨度为 天,那么一次查询可能涉及的时间分区数量约为 ,边界不对齐时还可能多访问一个分区。这个估算不直接代表查询耗时,但可以帮助发现明显失衡的方案。
假设在线保留 730 天,日分区约有 730 个时间分区;按月划分通常只有约 24 个。若绝大多数查询一次读取 90 天,日分区需要规划和访问大量子表,而月分区只覆盖少数几个分区。相反,如果日写入量巨大且每天都需要独立卸载昨天的数据,日分区提供的维护边界会更精确。
比较日、周和月分区
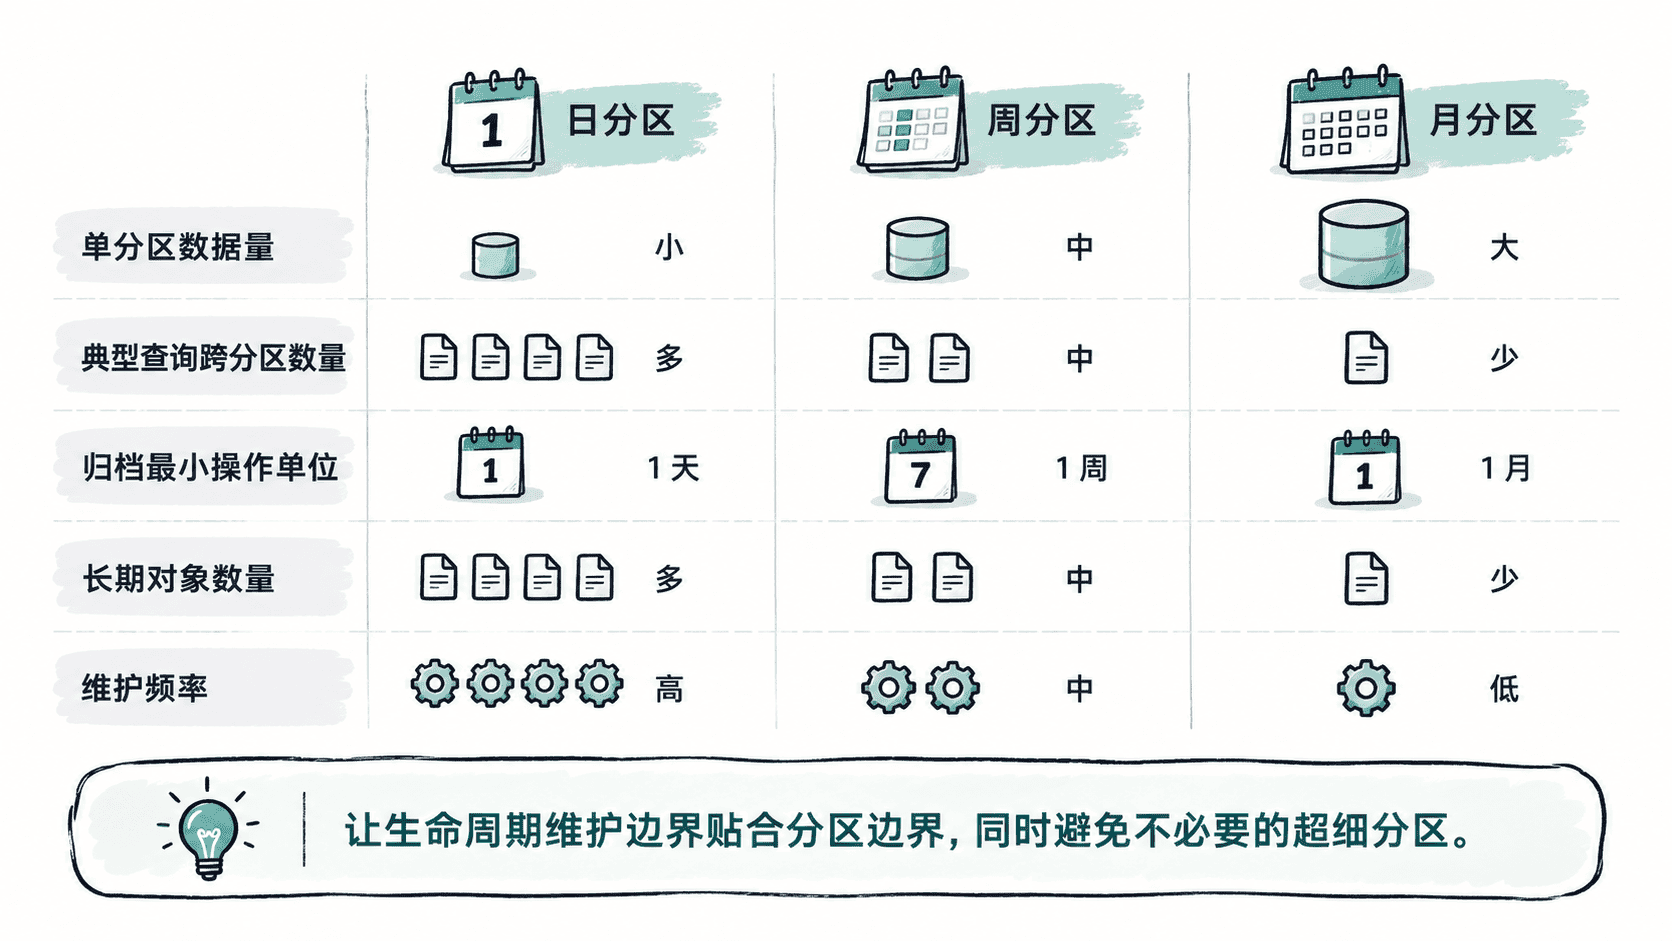
日分区适合数据增长很快、按天删除或迁移、单日数据已经足够大的场景。它的代价是对象增长快,长时间范围查询会跨更多分区。
周分区可以在单分区大小和对象数量之间折中,但自然月、账期和业务周边界未必与七天周期一致。若运维制度没有明确的周粒度,使用周分区反而会让归档边界更难解释。
月分区适合大多数按月保留、按月归档且单月数据规模可控的历史表。对象数量少,边界也容易理解;如果单月达到极大规模,或者一次删除整月数据的窗口过大,再考虑缩细到日级,而不是一开始就过度拆分。
建立月分区并观察裁剪范围
下面建立三个连续月分区,并检查一个跨越 1 月下旬到 2 月上旬的查询。该查询应访问 1 月和 2 月两个分区,不需要访问 3 月。
CREATE TABLE audit_log (
    id bigint NOT NULL,
    happened_at timestamptz NOT NULL,
    detail text NOT NULL
) PARTITION BY RANGE (happened_at);

CREATE TABLE audit_log_2026_01
PARTITION OF audit_log
FOR VALUES FROM ('2026-01-01 00:00:00+00')
         TO ('2026-02-01 00:00:00+00');

CREATE TABLE audit_log_2026_02
PARTITION OF audit_log
FOR VALUES FROM ('2026-02-01 00:00:00+00')
         TO ('2026-03-01 00:00:00+00');

CREATE TABLE audit_log_2026_03
PARTITION OF audit_log
FOR VALUES FROM ('2026-03-01 00:00:00+00')
         TO ('2026-04-01 00:00:00+00');

EXPLAIN (COSTS OFF)
SELECT id, happened_at
FROM audit_log
WHERE happened_at >= '2026-01-25 00:00:00+00'
  AND happened_at <  '2026-02-08 00:00:00+00';
预期结果
Append
  ->  Seq Scan on audit_log_2026_01 audit_log_1
        Filter: ...
  ->  Seq Scan on audit_log_2026_02 audit_log_2
        Filter: ...
实际计划中的别名、常量转换和成本信息可能不同,但核心检查点是只出现 1 月和 2 月两个分区,不应访问 audit_log_2026_03。如果将同一套两周查询放到日分区设计中,它通常需要访问十几个日分区,因此粒度选择会直接改变查询需要协调的对象数量。
让归档单位和分区边界对齐
分区治理的主要价值之一,是把历史数据处置从大量逐行 DELETE 转换为分区级操作。因此,如果业务规定“每月完成一次历史归档”,月分区天然提供完整月份边界;如果要求每天把超过 90 天的数据移走,日分区则更容易精确执行。
同时要检查单个候选分区是否已经大到难以维护。需要创建或重建局部索引、执行备份迁移、校验数据时,单分区越大,单次维护窗口和失败恢复成本通常越高。粒度因此不是纯查询优化参数,而是查询、归档和维护共同使用的控制面。
合理的起点是选择能够与生命周期操作自然对齐的最粗粒度,再根据单分区数据量和维护窗口决定是否拆细。这样可以避免大量碎片化分区,又能在单个分区过大时保留进一步细化的依据。