
PostgreSQL / 系统课时
制定数据生命周期治理方案
制定数据生命周期治理方案
本课把增长趋势、访问热度、保留要求和恢复目标合并成一份可执行的数据生命周期方案。完成后,你能够为一张持续增长的大表确定在线保留窗口、分区粒度、归档边界、清理条件和恢复路径,而不是只写一条按时间删除数据的 SQL。
学习目标
- 根据数据增长速度和查询热度划分在线、归档与到期数据边界
- 把保留要求、恢复目标转换为分区、归档和清理策略
- 用 SQL 验证治理方案中的数据规模与生命周期边界
从可量化数据开始设计
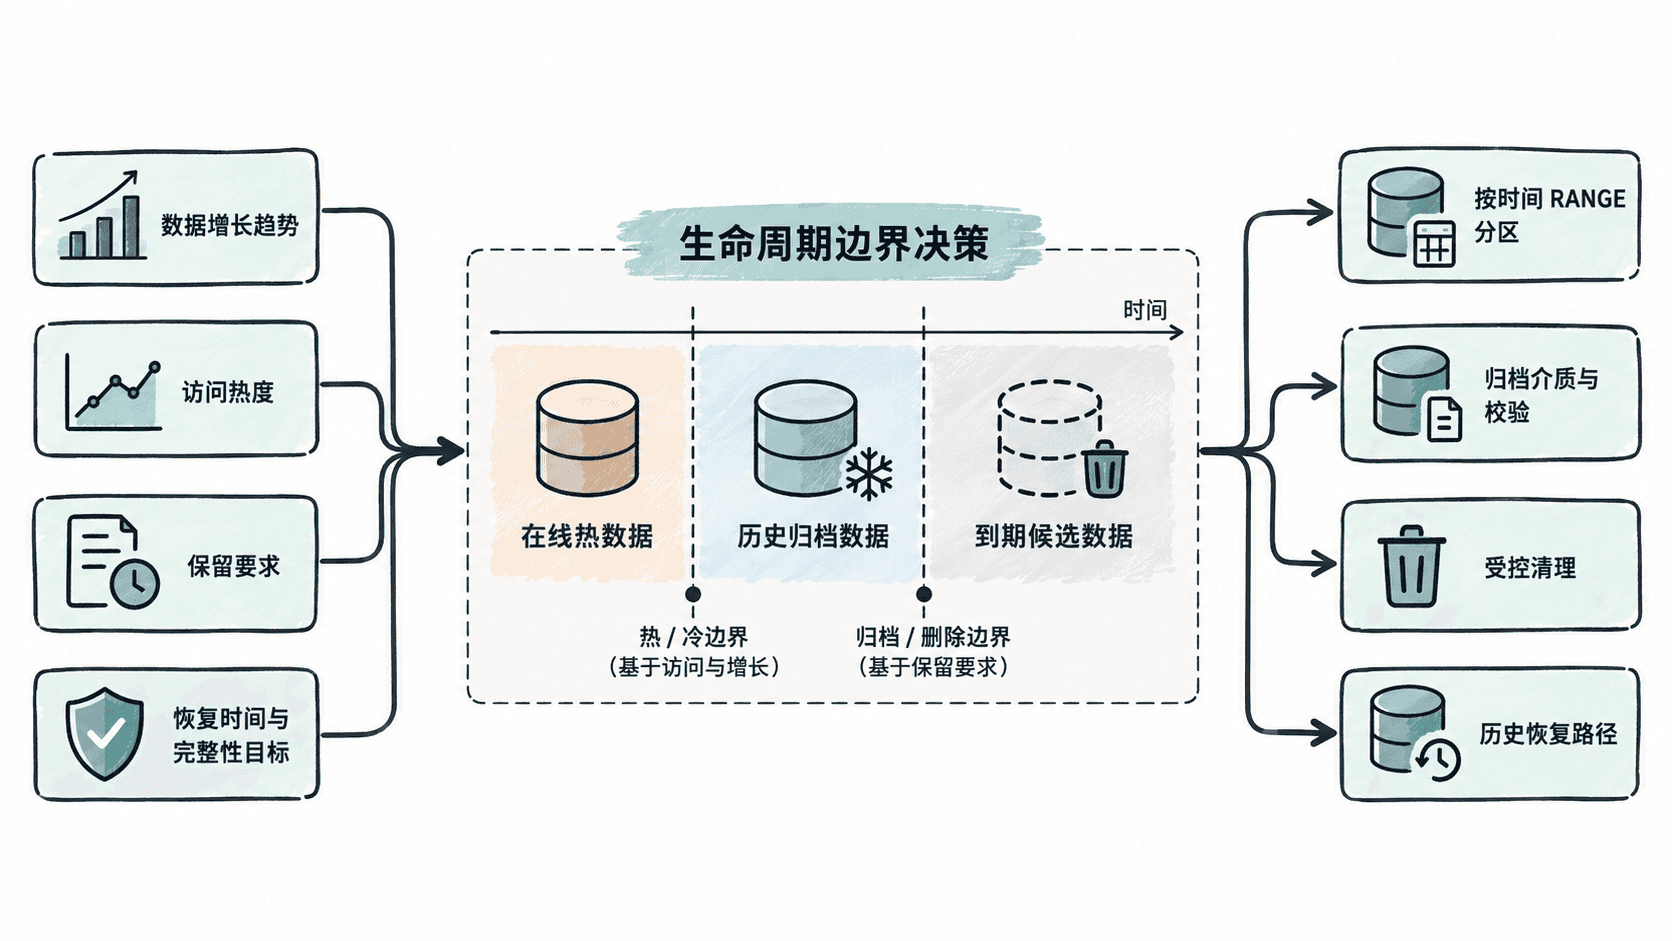
生命周期治理首先要回答四个问题:数据每天增长多少、业务通常查询多老的数据、法规或业务要求必须保留多久、历史数据需要多快恢复。只有这些条件明确后,分区周期和归档时间点才有依据。
假设 event_log 按 occurred_at 记录业务事件。先统计不同时间窗口的数据量,确认真正的热数据范围,而不是直接假设“超过三个月就是冷数据”。
SELECT
    CASE
        WHEN occurred_at >= CURRENT_DATE - INTERVAL '7 days' THEN '0-7d'
        WHEN occurred_at >= CURRENT_DATE - INTERVAL '30 days' THEN '8-30d'
        WHEN occurred_at >= CURRENT_DATE - INTERVAL '90 days' THEN '31-90d'
        ELSE '90d+'
    END AS age_bucket,
    count(*) AS row_count
FROM event_log
GROUP BY 1
ORDER BY 1;
预期结果
 age_bucket | row_count
------------+-----------
 0-7d       | <VALUE>
 8-30d      | <VALUE>
 31-90d     | <VALUE>
 90d+       | <VALUE>
实际行数取决于业务数据。除了行数,还应结合查询日志或 pg_stat_statements 判断旧数据是否仍被频繁访问;“数据很老”并不等于“访问很冷”。
把约束转换成生命周期边界
可以把治理策略拆成三个时间边界。例如业务要求数据保留七年,最近六个月要求低延迟在线查询,六个月以前仅用于审计,那么可以制定为:六个月在线、六个月到七年归档、七年以上满足审批和合规条件后删除。
分区粒度应同时匹配数据量和治理动作。如果每月数据量可控,按月 RANGE 分区通常便于整体摘除;如果单月数据已经过大,可以缩短为周或日,但会增加分区对象数量和自动维护成本。
明确归档与删除的门禁
归档不应只由定时器触发。一个批次进入归档前,至少要确认目标范围已经冻结、归档目标可写、磁盘空间足够,并且数据库负载与复制延迟处于允许范围。只有目标端校验成功后,源端数据才有资格进入清理阶段。
删除门禁要比归档更严格。建议至少保存批次标识、时间范围、源端行数、目标端行数和校验状态,并要求“归档成功且完整性验证通过”成为删除的前置条件。这样即使任务中断,也能知道哪些数据只复制了、哪些已经验证、哪些已经从在线库清理。
把恢复目标写进方案
归档介质不能只按存储成本选择。若历史数据偶尔需要分钟级查询,可以保留可直接查询的 PostgreSQL 归档库;若主要用于长期审计且恢复允许数小时,则可以使用成本更低的离线存储,但必须保留可验证的导入和恢复流程。
治理方案最终应能明确回答:哪个时间范围在线、哪个时间范围归档、什么条件允许删除、一次处理多少数据、失败后从哪里继续、历史数据怎样恢复。只要其中一个问题没有确定,自动化生命周期任务就仍缺少可执行边界。