
PostgreSQL / 系统课时
识别大表增长带来的风险
识别大表增长带来的风险
表持续增长并不只是磁盘占用变大。当行数、索引和历史版本不断累积时,查询读取、缓存效率、备份恢复、复制压力与 VACUUM 成本都可能变化。本课建立一套可观测的大表风险基线,用持续数据判断何时需要归档治理。
学习目标
- 识别大表增长对查询、缓存、备份、复制和维护操作的主要影响
- 使用 PostgreSQL 系统函数和统计视图检查表、索引与 dead tuple 规模
- 根据持续趋势区分容量增长和维护能力不足带来的风险
大表风险不只是容量问题
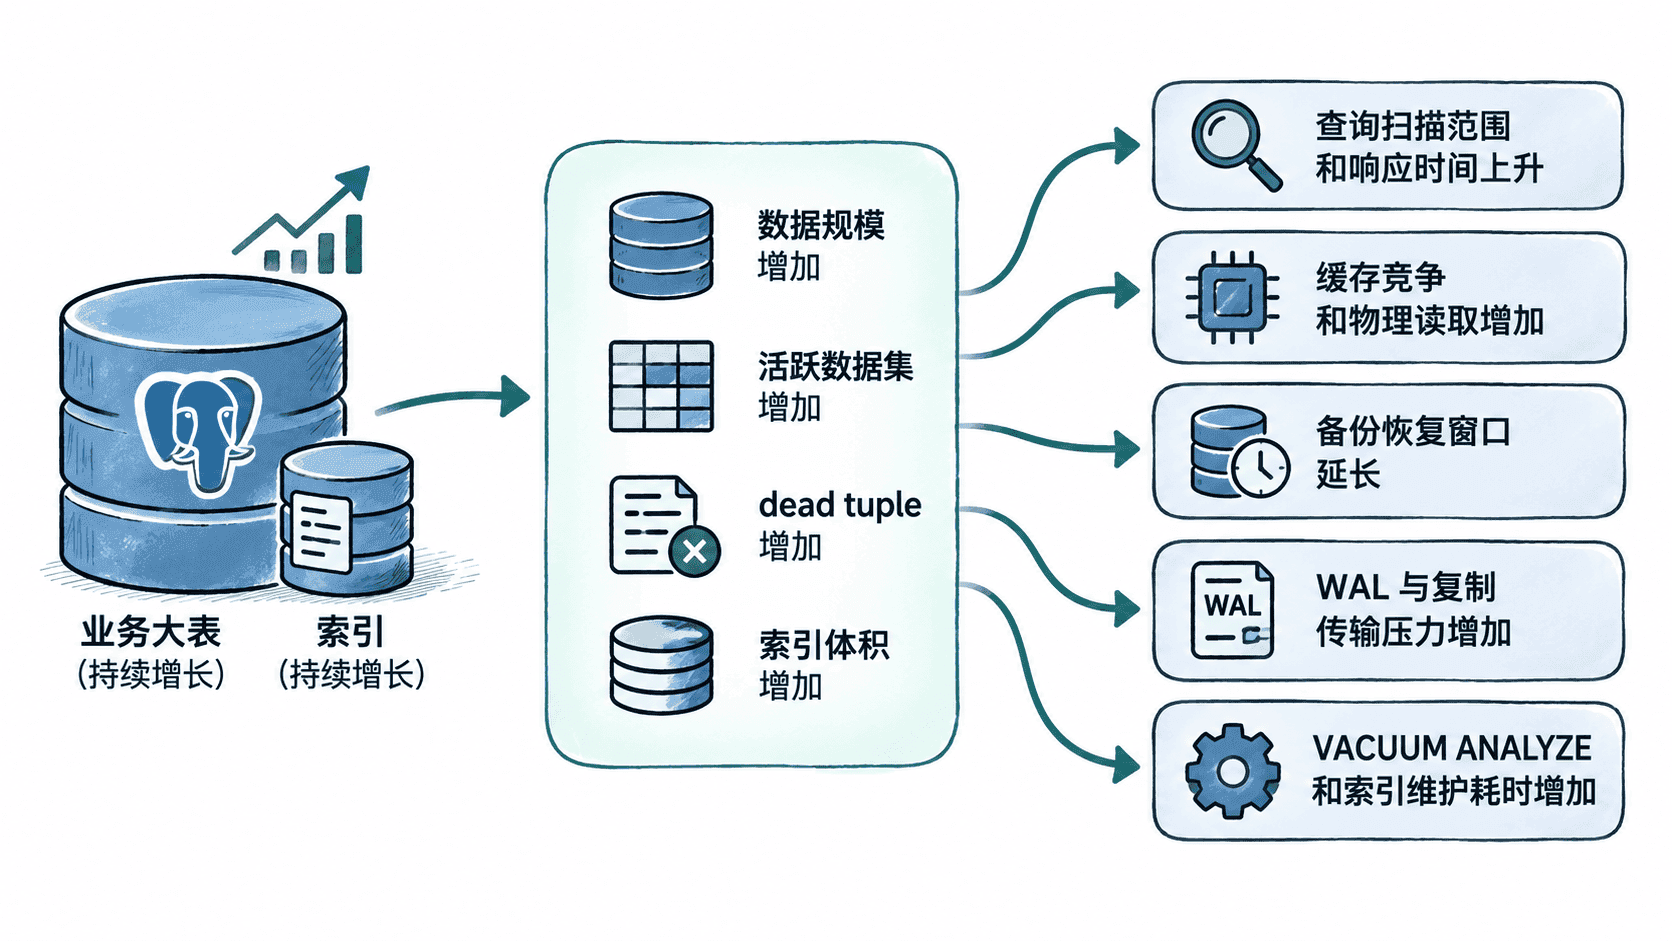
同一张业务表从几十 GB 增长到数百 GB 后,最先暴露的问题未必是磁盘不足。更重要的是判断数据规模是否开始超过数据库现有的查询、缓存、备份、复制和维护能力。
查询方面,缺少高选择性索引或需要扫描大量历史数据的 SQL,会随着表增长读取更多页面。即使执行计划形态没有明显变化,实际访问的数据量仍可能增加,最终表现为响应时间上升和 I/O 压力增大。
缓存方面,PostgreSQL 的共享缓冲区和操作系统页缓存容量有限。活跃数据集扩大后,低频历史页面可能与高频页面竞争缓存,从而增加物理读取。增加磁盘容量只能缓解存储不足,不能直接改善由工作集扩大造成的缓存压力。
维护方面,表和索引越大,VACUUM、索引创建或重建、备份和恢复等操作通常需要处理更多数据。原本能够在低峰期完成的维护动作,可能逐渐超过可接受的窗口。
先测量表和索引到底有多大
判断大表风险时,不要只看主表文件。普通业务表通常还伴随多个索引,大字段还可能进入 TOAST 存储,因此应同时检查总关系大小、主表大小和索引大小。
下面的查询可以建立基础容量快照。把 public.orders 替换为需要检查的实际表名。
SELECT
    pg_size_pretty(pg_total_relation_size('public.orders')) AS total_size,
    pg_size_pretty(pg_relation_size('public.orders')) AS heap_size,
    pg_size_pretty(pg_indexes_size('public.orders')) AS indexes_size;
预期结果
total_size | heap_size | indexes_size
-----------+-----------+-------------
<VALUE>    | <VALUE>   | <VALUE>
pg_total_relation_size 会统计目标表及其索引和 TOAST 等关联存储,pg_relation_size 只统计指定关系自身的主分叉大小,pg_indexes_size 统计该表索引占用。实际值会随数据量、TOAST 使用情况和索引设计变化,因此单次大小不是治理阈值,更值得关注的是持续增长速度和空间构成。
如果索引空间增长明显快于主表,应进一步检查重复索引、低收益索引或被频繁更新的宽索引。若主表本身增长很快,则要继续判断新增数据仍属于高频在线数据,还是已经失去业务活跃度的历史数据。
检查 VACUUM 是否开始跟不上
PostgreSQL 的 UPDATE 和 DELETE 通常不会立即缩小数据文件。旧 tuple 在不再被任何事务需要后,可由 VACUUM 清理,并将相应空间标记为可再次使用。如果更新和删除产生旧版本的速度长期超过清理能力,dead tuple 可能持续累积,并增加扫描、缓存和维护压力。
可以从统计视图检查活跃行估算、无效行估算以及最近一次自动 VACUUM 时间。
SELECT
    relname,
    n_live_tup,
    n_dead_tup,
    last_autovacuum,
    autovacuum_count
FROM pg_stat_user_tables
WHERE schemaname = 'public'
  AND relname = 'orders';
预期结果
relname | n_live_tup | n_dead_tup | last_autovacuum | autovacuum_count
--------+------------+------------+-----------------+-----------------
orders  | <VALUE>    | <VALUE>    | <TIME>          | <VALUE>
n_live_tup 和 n_dead_tup 都是统计估算值,不应把单次采样当成精确计数。更有价值的是观察 n_dead_tup 的长期趋势,以及 autovacuum 是否能够周期性完成清理。如果 dead tuple 持续增加,还应继续排查长事务、autovacuum 触发阈值、工作频率和可用资源等因素。
备份、复制和维护窗口也会被增长拖长
全量备份通常需要读取更多数据,恢复过程也需要处理更大的数据集。如果数据增长速度长期高于备份基础设施的吞吐扩展速度,备份窗口和恢复时间就可能逐步超过既定目标。
复制风险需要区分“表很大”和“对大表执行大量写操作”。表尺寸本身不会持续制造 WAL,但大量 INSERT、UPDATE、DELETE、索引维护以及批量历史清理都会生成 WAL,并增加主库写入、WAL 传输和备库 replay 的压力。归档方案如果直接执行一次性大规模 DELETE,生命周期治理本身就可能制造复制延迟和 WAL 峰值。
维护窗口同样会受到对象规模影响。索引创建或重建、表重写、备份恢复以及需要处理大量数据页的维护动作,通常会随着对象增长消耗更多 I/O、CPU 或时间。原来一小时内能够完成的动作,可能最终跨越整个低峰窗口。
用趋势而不是单个阈值判断是否需要治理
没有一个适用于所有 PostgreSQL 系统的“大表大小阈值”。一张 500 GB、访问模式稳定且分区合理的只追加表可能运行良好,而一张 50 GB、持续高频更新且维护能力不足的表可能已经产生明显风险。
应持续记录表总大小、主表与索引大小、增长速度、dead tuple、关键查询耗时或读取量、备份时长和复制延迟。把这些指标放到时间轴上,才能区分偶发波动和持续恶化,也能判断瓶颈究竟来自容量增长、访问模式变化,还是维护能力跟不上。
真正需要生命周期治理的信号不是单纯“表很大”,而是大量低活跃历史数据持续占用在线查询、缓存、备份和维护资源。当容量增长开始同时侵蚀多个运行指标时,就应该评估归档、分区或清理策略,而不是继续只增加磁盘空间。