
PostgreSQL / 系统课时
排查清理后空间不下降
排查清理后空间不下降
历史数据已经清理,但磁盘监控没有明显下降时,本课不再重复 DELETE 与 VACUUM 的基础机制,而是直接沿着“清理是否完成 → 回收是否受阻 → 空间在哪个对象 → 是否需要物理收缩”的顺序定位问题,并用同一组证据决定下一步操作。
学习目标
- 按固定顺序判断清理后空间不下降卡在哪个环节
- 使用 PostgreSQL 统计视图和大小函数定位 heap、索引与 TOAST 占用
- 区分内部空间已经可复用与确实需要归还文件系统两种情况
建立清理后的空间快照
不要只观察文件系统中的单个关系文件。先记录目标表的 heap、索引和总关系大小,后续再结合 dead tuple 与事务状态判断问题究竟属于回收受阻,还是空间已经回收但仍保留在关系文件内部。
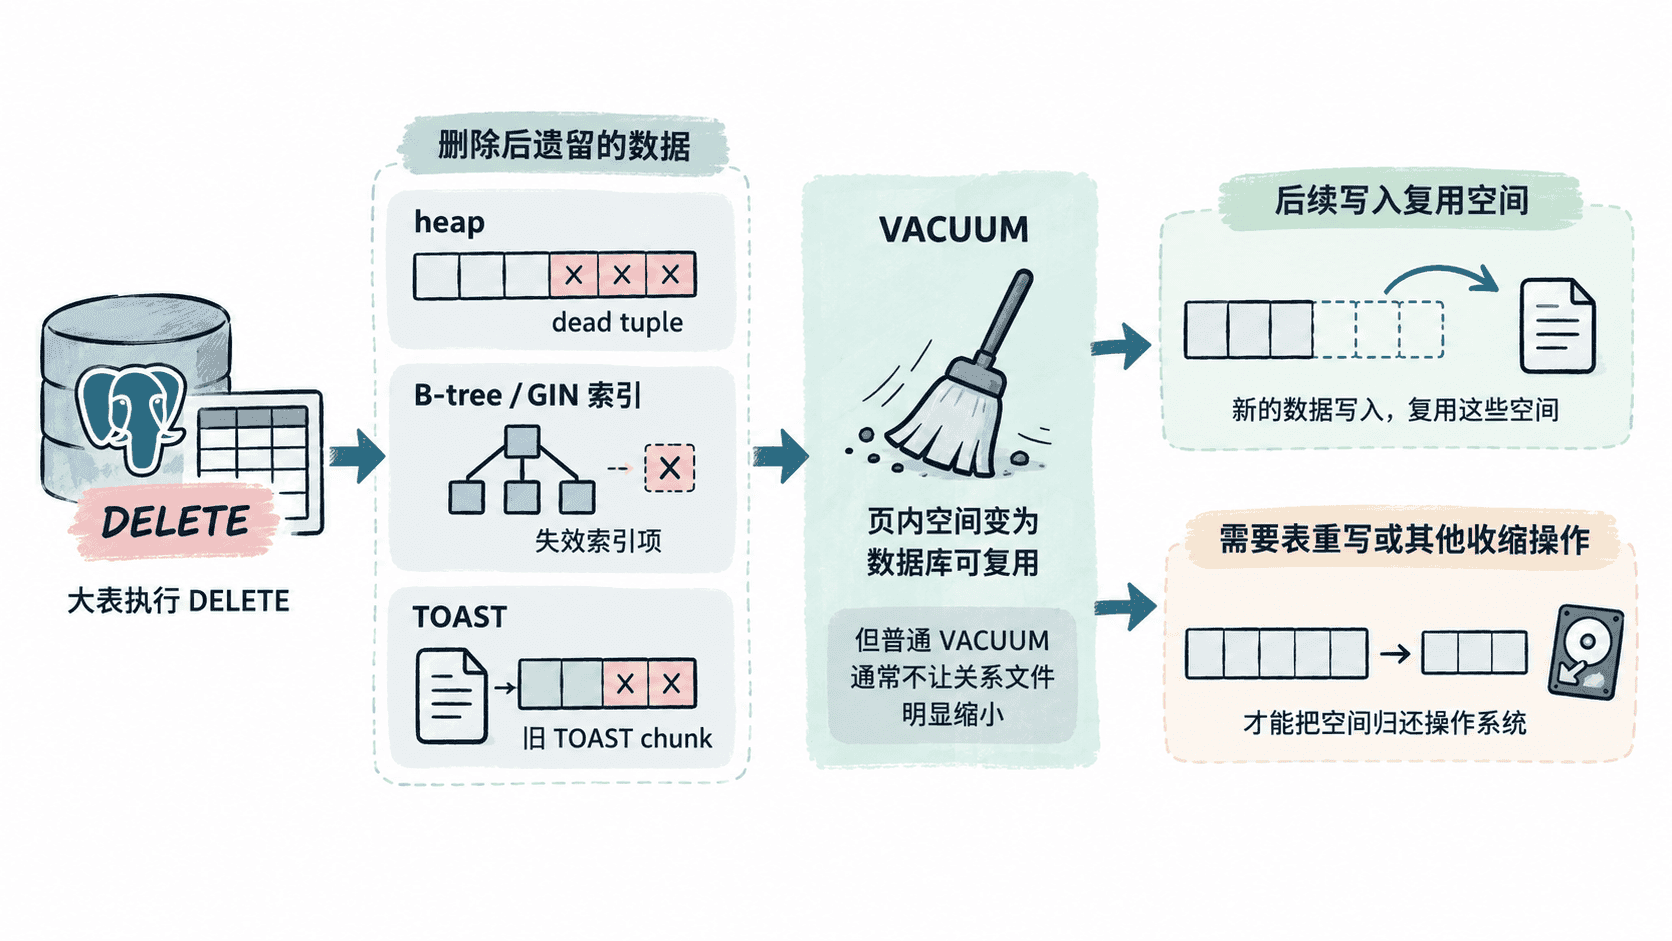
下面以 public.event_history 为例建立快照;实际排查时替换为目标关系名。
SELECT
    pg_size_pretty(pg_relation_size('public.event_history')) AS heap_size,
    pg_size_pretty(pg_indexes_size('public.event_history')) AS index_size,
    pg_size_pretty(pg_total_relation_size('public.event_history')) AS total_size;
预期结果
 heap_size | index_size | total_size
-----------+------------+-----------
 <VALUE>   | <VALUE>    | <VALUE>
(1 row)
heap_size 是主表本体,index_size 汇总该表索引,total_size 还包含 TOAST 等关联存储。这里先记录基线,不根据“文件没有变小”直接判断清理失败。
确认 VACUUM 是否追上清理进度
接着查看 live tuple、dead tuple,以及最近一次 VACUUM 和 autovacuum 时间。pg_stat_user_tables 中的 tuple 数量属于估算值,适合判断数量级和趋势,不应替代业务侧精确行数校验。
SELECT
    relname,
    n_live_tup,
    n_dead_tup,
    last_vacuum,
    last_autovacuum
FROM pg_stat_user_tables
WHERE schemaname = 'public'
  AND relname = 'event_history';
预期结果
    relname    | n_live_tup | n_dead_tup |      last_vacuum       |    last_autovacuum
---------------+------------+------------+------------------------+------------------------
 event_history | <VALUE>    | <VALUE>    | <TIME>                 | <TIME>
(1 row)
如果清理结束后 n_dead_tup 仍持续处于高位,先确认 VACUUM 是否能够正常推进。可以在可控窗口执行一次普通 VACUUM,并观察是否报错或长期无法结束。
VACUUM (VERBOSE, ANALYZE) public.event_history;预期结果
INFO:  vacuuming "public.event_history"
INFO:  finished vacuuming "public.event_history": <VALUE>
VACUUM
VERBOSE 的具体字段会随 PostgreSQL 版本和现场状态变化,只需确认目标关系完成 VACUUM 且没有错误。若 VACUUM 本身能完成,但 dead tuple 长时间降不下来,再继续检查是否有长事务或长期快照保留旧版本。
SELECT
    pid,
    usename,
    state,
    xact_start,
    backend_xmin,
    query
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start;
预期结果
 pid  | usename |        state        |       xact_start       | backend_xmin | query
------+---------+---------------------+------------------------+--------------+----------------
 <PID>| <VALUE> | <VALUE>             | <TIME>                 | <VALUE>      | <VALUE>
(<VALUE> rows)
重点关注持续时间异常长的事务,以及持有较老 backend_xmin 的会话。是否终止会话必须结合业务影响判断,不应仅因它“看起来很老”就直接执行 pg_terminate_backend。
找出真正占空间的对象
如果 dead tuple 已明显下降,就不要继续把问题归因于 VACUUM。此时回到空间快照,分别查看索引和 TOAST,找出真正占据大部分空间的对象。
SELECT
    indexrelname,
    pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE schemaname = 'public'
  AND relname = 'event_history'
ORDER BY pg_relation_size(indexrelid) DESC;
预期结果
       indexrelname        | index_size
---------------------------+-----------
 <INDEX_NAME>              | <VALUE>
 <INDEX_NAME>              | <VALUE>
(<VALUE> rows)
如果某个索引占据主要空间,应单独评估该索引的膨胀和重建收益,而不是直接重写整张表。索引重建会消耗额外 I/O、CPU、WAL 和临时磁盘空间,生产环境还要确认所选重建方式的锁行为。
对含有大文本、JSON、数组或二进制列的表,再检查对应 TOAST 关系。
SELECT
    c.relname AS table_name,
    t.relname AS toast_name,
    pg_size_pretty(pg_total_relation_size(t.oid)) AS toast_size
FROM pg_class c
JOIN pg_class t ON t.oid = c.reltoastrelid
JOIN pg_namespace n ON n.oid = c.relnamespace
WHERE n.nspname = 'public'
  AND c.relname = 'event_history';
预期结果
   table_name   |   toast_name   | toast_size
----------------+----------------+-----------
 event_history  | pg_toast_<ID>  | <VALUE>
(1 row)
如果没有返回行,说明该关系没有对应 TOAST 表;如果 TOAST 占用很高,则应把它视为独立空间来源,而不是仅凭主表 heap 大小判断清理效果。
决定是否需要物理收缩
当表还会持续写入时,只要 dead tuple 已得到处理,VACUUM 后留下的内部空间往往可以被后续 INSERT 或 UPDATE 复用。此时关系文件没有缩小,并不等同于空间治理失败,真正要观察的是文件是否停止无必要地继续增长。
只有业务明确要求把空间归还操作系统时,才进入关系重写、索引重建等更重方案的评估。实施前至少要核对额外磁盘需求、WAL 量、复制延迟、I/O 峰值和锁窗口,不能仅因为磁盘监控曲线没有下降就立即执行重型操作。
排查顺序可以固定为:确认清理结果,检查 VACUUM 与长事务,再定位具体空间对象,最后判断业务是否真的要求归还文件系统。这样能避免把正常的内部空间复用误判成清理失败,也能避免过早执行高风险重写。