
PostgreSQL / 系统课时
设置归档任务资源门禁
设置归档任务资源门禁
归档任务即使逻辑正确,也可能在数据库高负载、复制严重落后或磁盘空间紧张时放大生产风险。本课把负载、复制延迟、磁盘余量和维护窗口转成可执行的暂停与恢复门禁,让自动任务先判断环境是否适合运行。
学习目标
- 为归档任务选择可观测的资源门禁指标
- 设置不同的暂停阈值与恢复阈值,避免频繁启停
- 用 SQL 检查复制、容量和活动状态并决定是否继续执行
门禁应该阻止什么
资源门禁不是性能监控面板,而是任务开始一个新批次前的决策器。它需要回答一个问题:当前继续复制或删除历史数据,是否会明显增加生产风险?
典型信号可以分成四组:数据库当前是否繁忙、复制链路是否已经积压、源端与目标端是否有足够磁盘余量,以及当前时间是否处于允许执行的维护窗口。只要任一关键门禁失败,新批次就不应启动。
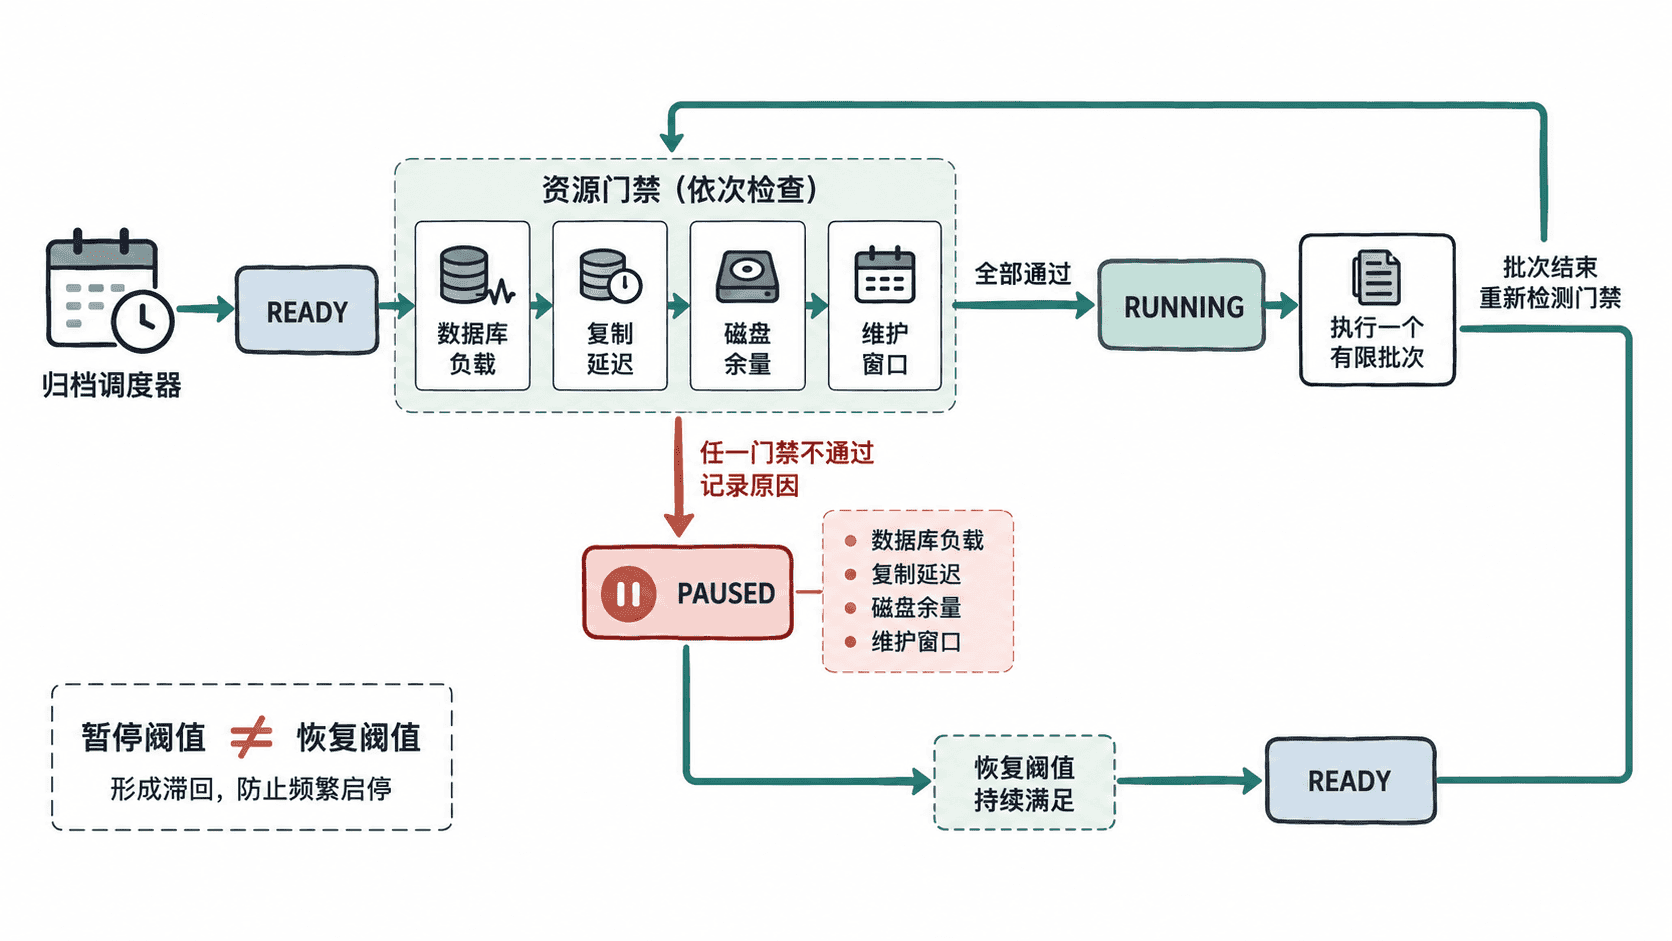
门禁应在批次之间检查,而不是等一个超大事务运行到一半再强行终止。归档任务因此应拆成可控的小批次,使调度器能在每批完成后重新评估资源状态。
检查数据库活动负载
不要仅依赖瞬时 CPU 数值,因为数据库内部最容易获得且更贴近归档风险的信号包括活跃会话数、长事务和等待事件。下面查询可以得到当前非空闲会话数量,作为一个简单的自动门禁输入。
SELECT count(*) AS active_sessions
FROM pg_stat_activity
WHERE state <> 'idle'
  AND pid <> pg_backend_pid();
预期结果
 active_sessions
-----------------
 <VALUE>
<VALUE> 会随业务负载变化。实际系统应根据正常峰值和连接池规模确定阈值,而不是照搬固定数字。更成熟的门禁还可以额外阻止存在超长事务时启动大批量删除,因为这会延迟死元组回收并增加空间压力。
用复制延迟阻止继续制造 WAL
批量 DELETE、索引维护和相关更新都会产生 WAL。如果存在物理流复制,归档任务在备库已经严重落后时继续运行,会进一步增加恢复和故障切换风险。
在主库上可以查看各个流复制连接的 WAL 字节差距:
SELECT
    application_name,
    pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS replay_lag_bytes
FROM pg_stat_replication;
预期结果
 application_name | replay_lag_bytes
------------------+-----------------
 <VALUE>          | <VALUE>
如果没有连接中的流复制备库,该查询可能返回 0 行。门禁程序应明确区分“没有配置备库”和“原本应该有备库但当前失联”,后者通常应视为风险条件,而不是自动放行。
给磁盘余量留下安全边界
归档并不意味着磁盘会立刻释放。普通 DELETE 主要产生可复用空间,表文件通常不会立即缩小;同时目标归档库还需要接收新数据。因此运行前必须分别评估源端和目标端容量,而不能假设“删多少就马上空出多少”。
PostgreSQL 可以直接查询数据库对象当前占用,用于判断增长趋势或估算本轮操作规模:
SELECT
    pg_size_pretty(pg_database_size(current_database())) AS database_size,
    pg_size_pretty(pg_total_relation_size('orders')) AS source_table_size,
    pg_size_pretty(pg_total_relation_size('orders_archive')) AS archive_table_size;
预期结果
 database_size | source_table_size | archive_table_size
---------------+-------------------+-------------------
 <VALUE>       | <VALUE>           | <VALUE>
这条 SQL 只能得到 PostgreSQL 对象大小,不能直接得到文件系统剩余空间。文件系统或云磁盘剩余容量应从操作系统或基础设施监控系统获取,再与数据库指标共同参与门禁判断。
用暂停阈值和恢复阈值避免抖动
如果只设置一个阈值,例如活跃会话超过 80 就暂停、低于 80 就恢复,指标在 79 与 81 之间波动时任务可能频繁启停。应为同一信号设置不同的暂停和恢复条件,也就是滞回机制。
例如可以定义:活跃会话达到高水位时暂停,只有下降到更低的恢复水位并持续一段观察时间后才恢复;复制延迟和磁盘余量也采用同样思路。具体数值必须来自本系统容量基线和业务 SLO,而不是使用通用模板值。
一个调度器可以把检查结果抽象成如下决策逻辑:
if ! ./check-maintenance-window; then
  echo "PAUSE: outside maintenance window"
  exit 10
fi

if ! ./check-db-load; then
  echo "PAUSE: database load above threshold"
  exit 11
fi

if ! ./check-replication-lag; then
  echo "PAUSE: replication lag above threshold"
  exit 12
fi

if ! ./check-disk-headroom; then
  echo "PAUSE: insufficient disk headroom"
  exit 13
fi

echo "READY: archive batch may start"
预期输出
READY: archive batch may start任一门禁失败时,脚本应输出对应的 PAUSE 原因并以非零状态退出。真正的自动化系统还应把原因和检测值记录到任务日志,便于区分“任务故障”和“资源门禁主动暂停”。
恢复后也只执行有限批次
门禁恢复不意味着可以一次归档全部剩余数据。更稳妥的循环是:检查门禁、执行一个有限批次、提交、再次检查门禁。这样业务负载突然升高时,任务最多再完成当前小批次,而不会长时间占用 I/O、锁和 WAL 带宽。
资源门禁的目标不是让归档跑得最快,而是在业务资源充足时主动利用空闲容量,在风险信号出现时自动让路。只有把暂停条件、恢复条件和小批次执行结合起来,自动化生命周期任务才具备长期无人值守运行的基础。