
PostgreSQL / 系统课时
跨在线与归档数据查询
跨在线与归档数据查询
当业务既要访问近期在线数据,又要偶尔查询历史归档数据时,关键不是“能不能查到”,而是由谁判断数据位置。本课比较应用层路由、统一视图和外部表三种路径,并说明如何在透明性、性能与故障隔离之间取舍。
学习目标
- 根据查询时间范围选择应用路由、视图或外部表等访问方式
- 理解透明访问与故障隔离之间的权衡
- 设计不会让归档库故障拖慢在线主链路的查询边界
先确定谁负责判断冷热边界
假设在线库只保存最近 90 天数据,更早的数据已经迁入归档库。任何跨冷热查询都必须先判断查询时间范围属于在线区、归档区,还是同时跨越两者。
这个判断可以放在应用层,也可以隐藏在数据库对象后面。不同方案最大的区别,是路由逻辑是否显式,以及归档端异常是否会传播到在线查询。
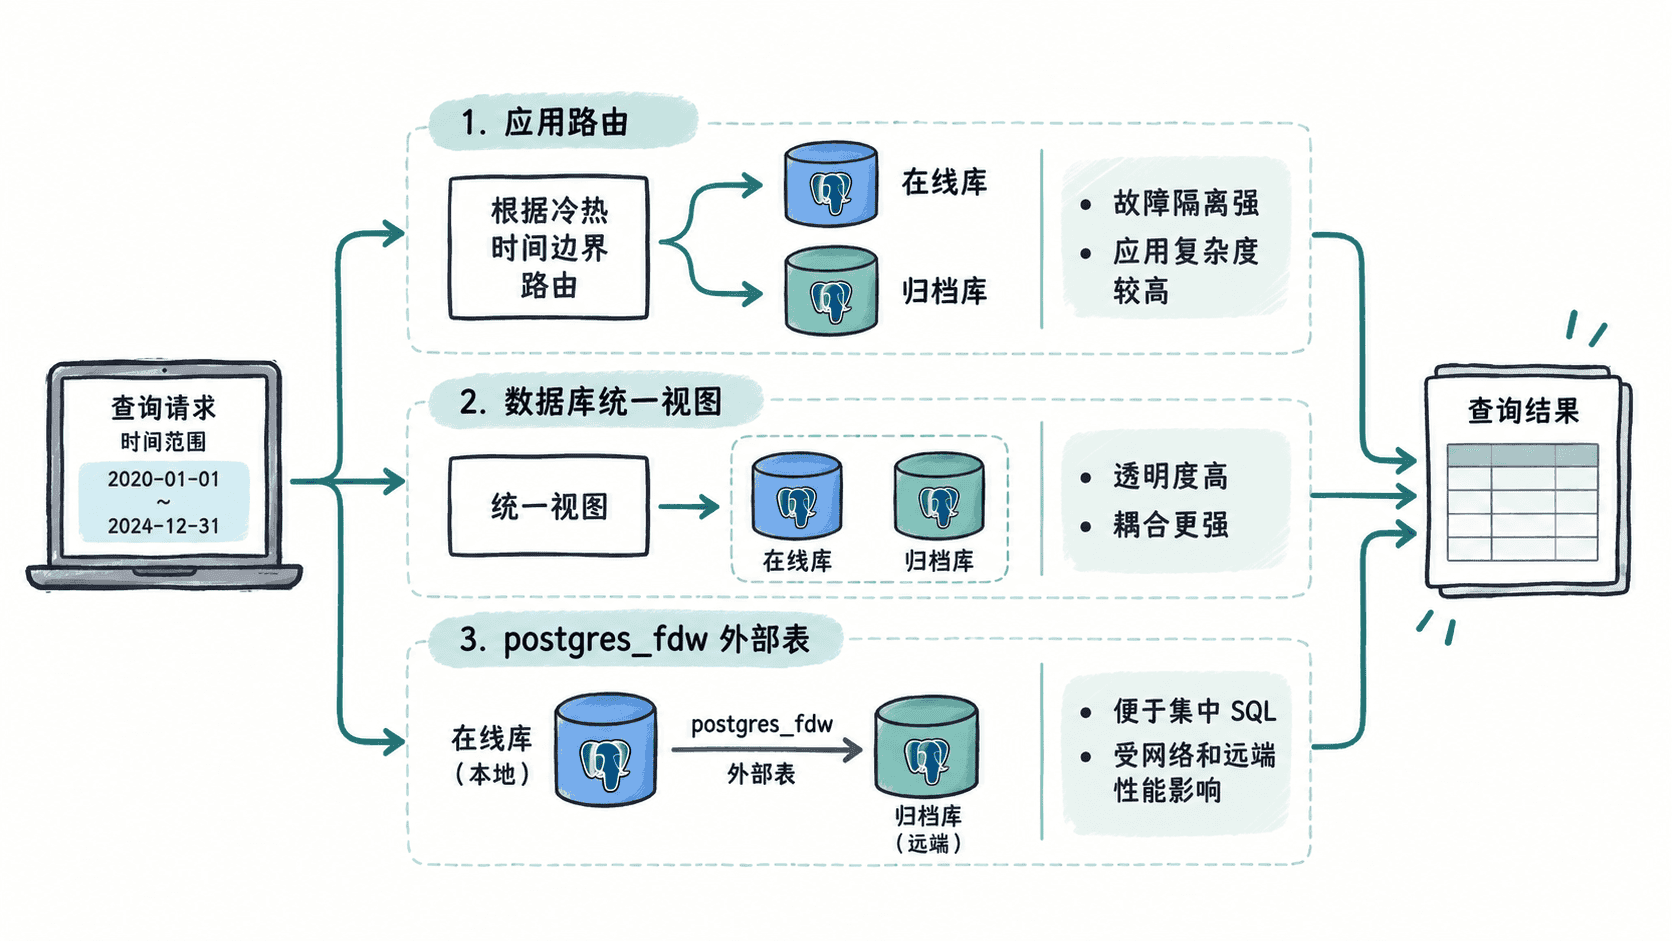
应用层路由最容易建立故障边界
应用层可以根据请求时间决定访问哪个连接池。若查询完全落在在线区,只访问在线库;完全落在历史区,只访问归档库;跨越边界时再分别查询并合并结果。
下面是路由逻辑的伪代码片段,依赖应用已经配置 onlineDb、archiveDb 两个数据源:
if query_end <= cold_boundary:
    query archiveDb
else if query_start >= cold_boundary:
    query onlineDb
else:
    query archiveDb for [query_start, cold_boundary)
    query onlineDb for [cold_boundary, query_end)
    merge results by occurred_at
这是片段示例,用于说明路由边界,不是某种编程语言的完整实现。生效行为是纯在线请求不会自动依赖归档库。验证时应分别测试纯在线区间、纯历史区间和跨边界区间,并确认只访问预期的数据源。
应用层路由的代价是业务代码需要理解冷热边界,还要负责排序、分页和去重等跨源语义。但它最容易把在线与归档故障域拆开,适合在线 SLA 明显高于历史查询 SLA 的系统。
统一视图适合同一个数据库实例内的冷热表
如果在线表和归档表位于同一 PostgreSQL 实例,且二者列结构兼容,可以使用视图隐藏物理位置差异。
CREATE VIEW event_all AS
SELECT event_id, tenant_id, occurred_at, event_type, payload
FROM event_online
UNION ALL
SELECT event_id, tenant_id, occurred_at, event_type, payload
FROM event_archive;
预期结果
CREATE VIEW随后可以检查视图是否存在:
SELECT table_name
FROM information_schema.views
WHERE table_schema = 'public'
  AND table_name = 'event_all';
预期结果
 table_name
------------
 event_all
(1 row)
查询方随后只面对 event_all。不过,透明性并不会自动带来高性能:应确保查询包含能作用于两个分支的时间与租户过滤条件,并分别检查在线表和归档表是否能使用合适索引;如果底层本身是分区表,还要确认分区裁剪是否生效。
外部表可以跨实例访问归档库
若归档库位于独立 PostgreSQL 实例,可以使用 postgres_fdw 将远端表映射为本地外部表。下面示例假设扩展可用,实际主机、端口和凭据应由受控部署流程提供。
CREATE EXTENSION IF NOT EXISTS postgres_fdw;

CREATE SERVER archive_server
FOREIGN DATA WRAPPER postgres_fdw
OPTIONS (host '<IP>', port '<PORT>', dbname 'archive_db');

CREATE USER MAPPING FOR CURRENT_USER
SERVER archive_server
OPTIONS (user 'archive_reader', password '<VALUE>');

CREATE FOREIGN TABLE event_archive_remote (
    event_id bigint,
    tenant_id bigint,
    occurred_at timestamptz,
    event_type text,
    payload jsonb
)
SERVER archive_server
OPTIONS (schema_name 'public', table_name 'event_archive');
预期结果
CREATE EXTENSION
CREATE SERVER
CREATE USER MAPPING
CREATE FOREIGN TABLE
示例中的 <IP>、<PORT> 和 <VALUE> 必须替换为实际环境值。这里把密码参数写入 SQL 只是为了展示 CREATE USER MAPPING 的完整语法,不应把真实凭据固化在课程脚本、版本库、迁移文件或自动化日志中。
postgres_fdw 的用户映射及其连接选项会保存在 PostgreSQL 系统目录中,因此这类配置不能按普通应用配置文件对待。生产环境应限制谁能够创建、查看和修改相关服务器对象与用户映射,并为归档端使用单独的最小权限只读账号。
更稳妥的边界是由受控部署系统在目标数据库内创建用户映射,并在执行 DDL 时从组织已有的秘密托管或轮换机制注入凭据。若环境支持证书、Kerberos 等 PostgreSQL 认证方式,还可以避免在用户映射中长期保存密码;具体方式取决于客户端、服务端和网络认证配置。
配置后应先用受限时间范围验证远端访问:
EXPLAIN (VERBOSE, COSTS OFF)
SELECT event_id, occurred_at
FROM event_archive_remote
WHERE tenant_id = 42
  AND occurred_at >= TIMESTAMPTZ '2024-01-01 00:00:00+00'
  AND occurred_at <  TIMESTAMPTZ '2024-02-01 00:00:00+00';
预期结果
Foreign Scan on public.event_archive_remote
  Remote SQL: <VALUE>
Remote SQL 的具体文本随 PostgreSQL 版本、远端表定义和执行计划变化,重点是确认过滤条件尽量下推到远端,而不是先把大批归档数据拉回在线库再过滤。还应为 FDW 查询设置独立的超时、连接与资源保护边界,避免远端抖动直接占满在线请求线程或数据库连接。
跨冷热查询最难的是分页和排序
如果查询跨两个数据源,并要求全局按 occurred_at DESC 分页,不能简单地让两个库各返回一页再直接拼接。通常应让两端按一致的排序键取得候选结果,再在应用层归并,并优先使用稳定游标而不是大偏移量分页。
游标最好同时包含时间与唯一键,例如 (occurred_at, event_id)。仅按时间排序时,同一时间戳出现多行可能导致翻页重复或遗漏;加入唯一键后才能形成稳定的全序关系。
对于高频接口,应尽量避免每次请求都跨在线与归档库。常见做法是把普通用户查询限制在在线窗口,把超出窗口的历史检索作为独立入口,从产品层面明确它具有不同的延迟和可用性目标。
选择访问方式时优先考虑故障隔离
如果在线业务不能接受归档端抖动,优先使用应用层路由和独立连接池;如果冷热数据仍在同一实例且查询规模可控,统一视图最简单;如果需要跨 PostgreSQL 实例集中执行 SQL,postgres_fdw 可以减少应用改造,但必须同时治理凭据、网络超时、远端慢查询和资源竞争。
透明查询不是最高目标。对大表生命周期治理而言,更重要的是让冷热边界可解释、查询代价可预测,并确保归档系统失效时不会扩大为在线故障。