
PostgreSQL / 系统课时
形成生命周期治理手册
形成生命周期治理手册
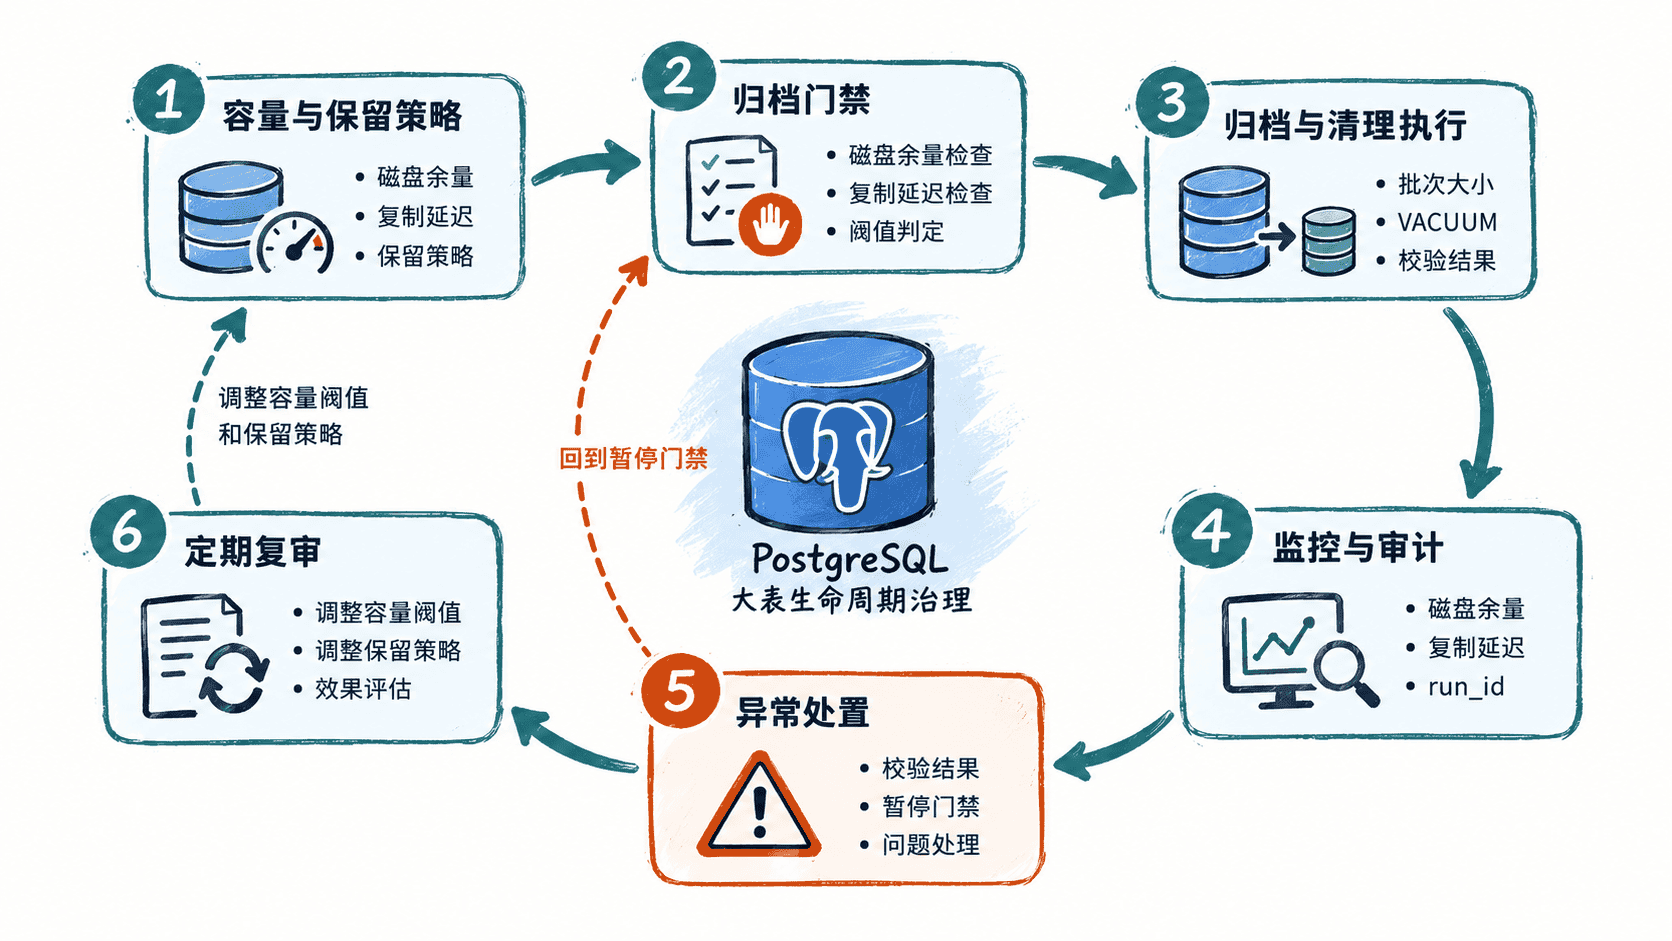
本节把大表生命周期治理沉淀成可执行手册:把容量阈值、归档门禁、清理流程、监控指标、异常处置和复审周期固定下来,使值班人员不依赖个人经验,也能按同一套证据和规则决定何时运行、暂停或调整任务。
学习目标
- 能把生命周期治理规则整理成可执行的门禁、操作和验收项。
- 能定义容量、复制、任务进度和数据完整性的最低监控集合。
- 能建立异常处置与定期复审机制,让阈值和流程随数据规模持续校正。
把手册写成可执行规则
治理手册不应只有原则描述,而要明确“谁在什么条件下做什么”。至少要固定在线保留边界、归档触发条件、删除前校验、任务暂停条件、恢复条件和最终数据验收方式。
建议把规则分成三层:策略层说明保留多久、归档到哪里;门禁层说明什么情况下允许执行;操作层说明执行 SQL、检查指标和异常处置步骤。这样策略变化时,不必重写整套操作流程。
固定容量与归档门禁
容量规则必须同时包含预警阈值和硬停止阈值。例如磁盘使用率达到预警阈值后降低归档批次,达到硬停止阈值后禁止继续产生大量 WAL 或临时文件。阈值不要只写百分比,还要结合剩余绝对容量,因为 90% 对 1 TB 与 20 TB 磁盘的风险并不相同。
归档门禁至少检查数据库负载、复制延迟、磁盘余量和维护窗口。门禁结果应写入任务审计表,使“为什么没有运行”能够被追溯,而不是只在调度日志里留下模糊错误。
下面是一条适合手册中的复制健康检查 SQL。
SELECT
    application_name,
    state,
    sync_state,
    pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS replay_lag_bytes
FROM pg_stat_replication
ORDER BY replay_lag_bytes DESC NULLS LAST;
预期结果
 application_name |   state   | sync_state | replay_lag_bytes
------------------+-----------+------------+-----------------
 <VALUE>           | streaming | <VALUE>    | <VALUE>
实际值会随环境变化。手册中应把“允许归档”的阈值写成明确规则,例如 replay_lag_bytes 高于内部门限时暂停新批次,而不是只写“延迟较高时注意观察”。
固化归档、清理和验收顺序
标准操作顺序应保持稳定:冻结归档边界,复制或摘除历史数据,完成完整性校验,再执行在线清理,最后检查 VACUUM、索引和磁盘空间状态。任何一步失败,都必须停在当前阶段,不能因为“归档文件已经生成”就跳过校验直接删除源数据。
手册中的验收项应至少覆盖计划范围、归档行数、异常行、删除行数、任务耗时和恢复点。对于分区表,还应记录被 DETACH 或 DROP 的分区名称和边界,避免只记录“清理完成”。
建立最小监控集合
监控指标不宜堆得过多,重点是覆盖容量、性能、复制和任务状态四类风险。容量关注数据库目录、WAL 和归档目标空间;性能关注归档批次耗时、业务延迟和 I/O;复制关注字节延迟与槽保留;任务状态关注最近成功时间、连续失败次数和积压量。
可以用 SQL 定期检查大表及其索引占用,作为容量复审的基础。
SELECT
    relname,
    pg_size_pretty(pg_total_relation_size(relid)) AS total_size
FROM pg_catalog.pg_statio_user_tables
ORDER BY pg_total_relation_size(relid) DESC
LIMIT 10;
预期结果
    relname    | total_size
---------------+-----------
 <VALUE>       | <VALUE>
结果中的表名和大小取决于实际数据库。手册应进一步规定谁负责观察这些指标、何时升级告警,以及达到哪个阈值后暂停生命周期任务。
明确异常处置优先级
异常处理要先止损,再恢复吞吐。复制延迟上升时先暂停高 WAL 操作;磁盘不足时先停止新增归档写入和大批量删除;任务连续失败时先冻结进度并保留证据,再判断是否可以幂等重试;校验不一致时禁止删除源数据。
手册还要写清回退边界。已经删除源数据但归档副本未经验证的场景,不应被定义为正常回退;真正可控的回退应发生在删除前,或依赖已验证且可恢复的归档副本。
定期复审手册本身
生命周期规则会随着数据增长、查询热度和基础设施变化失效,因此手册必须有复审周期。复审时至少比较最近一个周期的增长速度、归档积压、复制峰值延迟、磁盘最低余量、任务失败原因和实际恢复耗时。
如果归档窗口越来越长,应优先检查批次策略、分区粒度和目标存储吞吐;如果磁盘门禁频繁触发,应重新评估容量水位和在线保留期;如果异常处置依赖人工临场判断,说明手册还没有把决策条件写清。
一份可用的治理手册最终应做到三件事:正常情况下能稳定执行,异常情况下能立即停止扩大风险,复审时能用历史证据调整阈值。达到这三点,生命周期治理才从一次性脚本变成可长期运行的数据库运维机制。