
PostgreSQL / 系统课时
处理生命周期任务磁盘告警
处理生命周期任务磁盘告警
生命周期任务触发磁盘告警时,不能只盯着主表大小。临时文件、WAL、待重建索引以及迁移期间的源端与目标端双份数据都可能快速吃掉剩余空间。本课建立一套从确认增长来源、立即止损到恢复任务的排查路径。
学习目标
- 区分临时空间、WAL、索引和双份数据造成的磁盘增长
- 用 PostgreSQL 统计与操作系统指标定位主要占用来源
- 根据剩余空间和任务阶段制定暂停、清理与恢复步骤
先判断磁盘为什么在增长
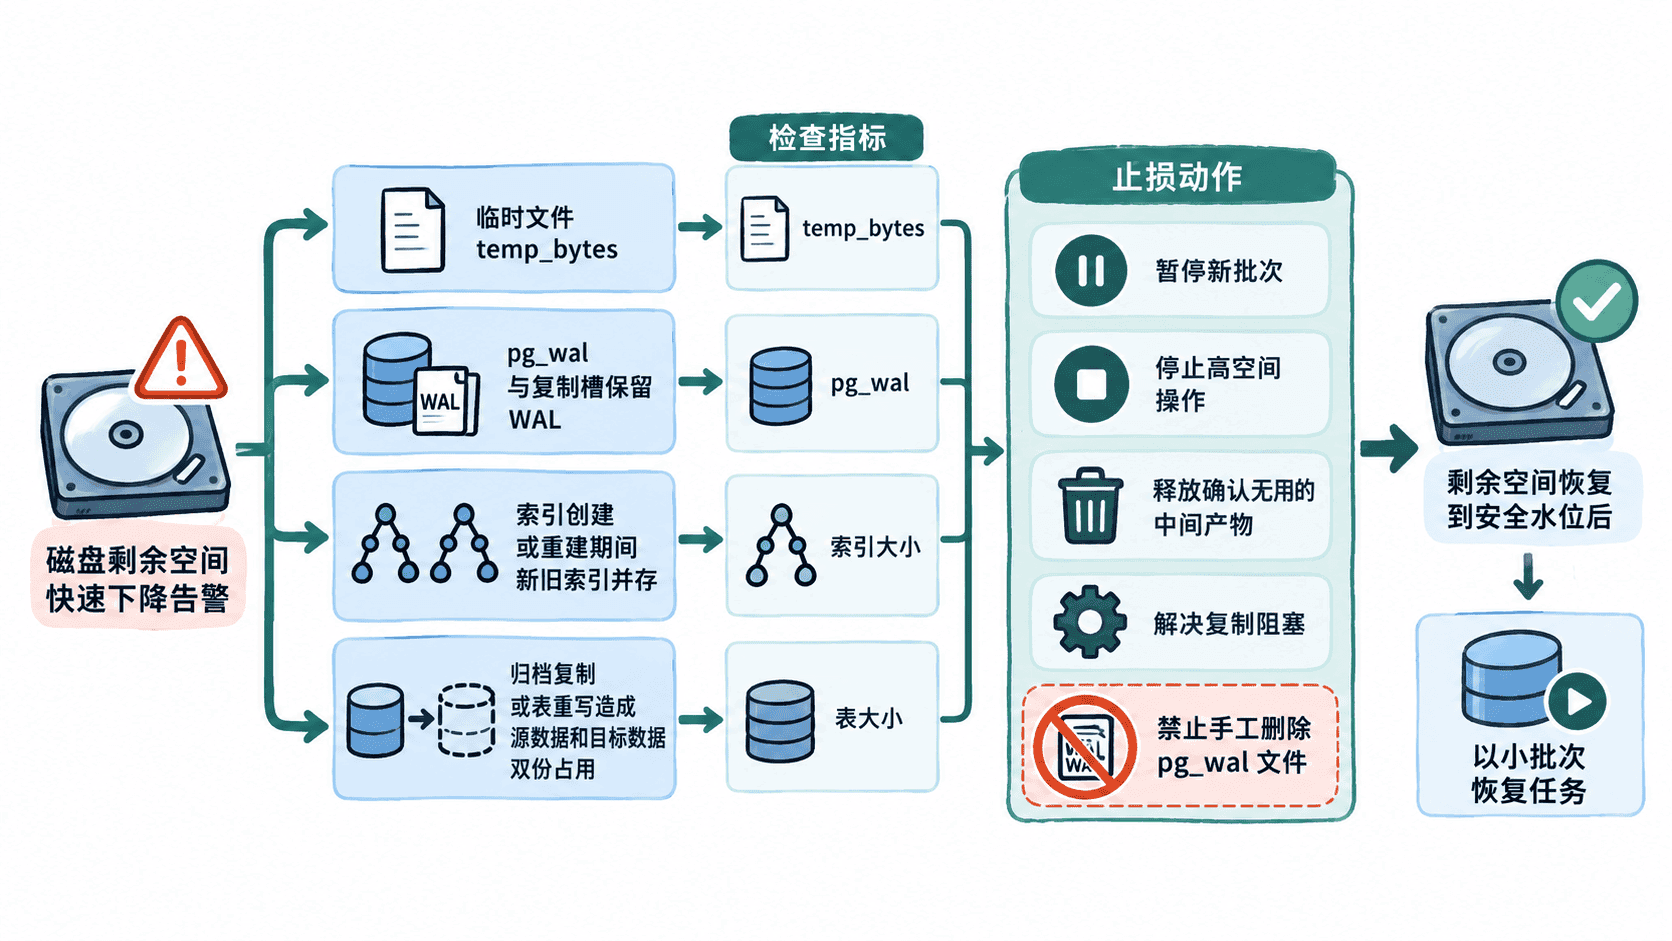
收到磁盘容量告警后,首先冻结生命周期任务的扩张动作,例如暂停新的归档批次、索引重建或大范围删除。不要立即删除文件或直接清空 pg_wal,因为后者会破坏数据库恢复能力。
生命周期任务常见的四类额外占用来源不同:大量排序或哈希可能产生临时文件;批量 INSERT、DELETE 和索引维护会产生 WAL;REINDEX、CREATE INDEX 等操作在完成前可能同时保留新旧结构;复制归档或表重写则可能让同一批业务数据暂时存在两份。
用一组查询确认主要占用
先从数据库内部检查临时文件累计量、当前 WAL 目录大小以及业务表和索引大小。下面的 SQL 假设正在当前业务库执行;读取 pg_ls_waldir() 通常需要足够的监控或超级用户权限。
SELECT datname,
       temp_files,
       pg_size_pretty(temp_bytes) AS temp_bytes
FROM pg_stat_database
WHERE datname = current_database();

SELECT pg_size_pretty(sum(size)) AS wal_size
FROM pg_ls_waldir();

SELECT pg_size_pretty(pg_relation_size('event_history')) AS heap_size,
       pg_size_pretty(pg_indexes_size('event_history')) AS index_size,
       pg_size_pretty(pg_total_relation_size('event_history')) AS total_size;
预期结果
 datname   | temp_files | temp_bytes
-----------+------------+------------
 <VALUE>   | <VALUE>    | <VALUE>

 wal_size
----------
 <VALUE>

 heap_size | index_size | total_size
-----------+------------+-----------
<VALUE> | <VALUE> | <VALUE>实际数值取决于当前库的数据量和工作负载。temp_bytes 是统计周期内累计写出的临时数据,不等于此刻仍占用的临时文件大小,因此还要结合操作系统目录容量和正在执行的 SQL 判断。
如果 WAL 明显异常,再检查复制槽。失联或长期落后的订阅端可能让旧 WAL 无法回收。
SELECT slot_name,
       active,
       restart_lsn,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retained_wal
FROM pg_replication_slots
WHERE restart_lsn IS NOT NULL
ORDER BY pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn) DESC;
预期结果
 slot_name | active | restart_lsn | retained_wal
-----------+--------+-------------+-------------
 <VALUE>   | <VALUE>| <VALUE>     | <VALUE>
如果某个槽不活跃且 retained_wal 持续增加,应先确认它对应的消费者是否仍然需要。不要因为磁盘紧张就直接删除仍承担恢复或迁移职责的复制槽。
按增长来源选择止损动作
临时空间异常时,应停止触发大排序、大哈希或并行度过高的归档查询,并检查是否存在长时间未结束的会话。必要时降低批次大小,让单个事务需要处理的数据集更小,而不是依赖不断提高 work_mem 来硬扛。
WAL 占用异常时,要区分“正在高强度产生”和“无法回收”。前者通常通过暂停批量写入、删除和索引操作快速降速;后者要处理复制槽、归档命令或备库延迟。只有确认消费者永久废弃后,才考虑按既定变更流程删除对应复制资源。
索引创建或重建期间磁盘突增时,应确认是否正处于新旧索引并存阶段。磁盘余量不足以完成操作时,优先中止尚未完成的重建并重新评估空间预算。对生产大表执行 REINDEX 或创建大型索引前,应预留至少能够容纳新结构及执行中间空间的容量。
归档复制和表重写造成双份数据时,不能在目标端尚未校验完成前为了腾空间提前删除源数据。正确顺序是暂停扩大复制范围,保留已经完成的批次,完成其完整性验证后再按批次清理源端。
恢复前重新设置安全水位
止损后,不要因为磁盘使用率暂时下降就立即恢复原来的吞吐。先估算一个批次的峰值额外空间,包括写入目标数据、WAL、索引增长和临时空间,并给数据库正常运行保留额外余量。
恢复时使用更小批次,只运行一个有限批次,然后重新检查文件系统剩余空间、WAL 增长、复制延迟以及目标端容量。只有连续几个批次都没有突破门限,才逐步提高吞吐。
磁盘告警真正需要治理的不是某个文件“太大”,而是生命周期动作的峰值空间没有受到门禁约束。把剩余空间检查加入每个批次之前,并把 WAL、临时空间、索引和双份数据分别计入预算,才能避免任务从容量治理工具变成新的容量故障源。