
PostgreSQL / 系统课时
设计安全的批量删除策略
设计安全的批量删除策略
当历史数据无法按整分区淘汰,只能使用 DELETE 时,最危险的做法是一次事务删除几千万行。本课把大删除拆成可暂停的小批次,并加入固定边界、独立提交、节流和重跑条件,让清理任务能在生产负载升高时及时停止并从剩余数据继续。
学习目标
- 用“小批次事务 + 节流”控制锁持有时间、WAL 峰值和复制压力
- 设计范围固定、失败后可继续执行的删除条件
- 通过每批受影响行数和剩余行数验证清理进度
先固定删除边界
批量删除应先固定一个不会随着任务运行而漂移的 cutoff,例如任务启动前已经确认的保留期边界。不要在每一批都重新计算 now() - interval '90 days',否则任务运行时间较长时,新进入过期区间的数据也会被纳入当前任务,本次清理范围会持续变化。
下面建立一个可重复运行的小型示例表,并把 2026-06-01 固定为本次删除边界。
DROP TABLE IF EXISTS audit_log;

CREATE TABLE audit_log (
  id bigint PRIMARY KEY,
  created_at date NOT NULL,
  payload text
);

INSERT INTO audit_log
SELECT g,
       DATE '2026-01-01' + ((g - 1) % 200),
       repeat('x', 100)
FROM generate_series(1, 20000) AS g;

CREATE INDEX audit_log_created_at_id_idx
ON audit_log (created_at, id);

SELECT count(*) AS expired_rows
FROM audit_log
WHERE created_at < DATE '2026-06-01';
预期结果
 expired_rows
--------------
        15100
索引 (created_at, id) 让候选行可以按固定条件和稳定顺序定位。真实生产表应优先使用业务主键或其他稳定唯一键作为删除关联键,不要依赖没有顺序保证的任意扫描结果。
每批只删除可控数量
PostgreSQL 的 DELETE 没有直接的 LIMIT 子句,可以先在 CTE 中选出一小批主键,再按主键删除。每次执行作为一个独立事务提交,可以避免单个事务持续持有大量行锁、集中产生过多 WAL,并减少长事务对 VACUUM 和版本回收的影响。
WITH victim AS (
  SELECT id
  FROM audit_log
  WHERE created_at < DATE '2026-06-01'
  ORDER BY created_at, id
  LIMIT 1000
)
DELETE FROM audit_log AS a
USING victim AS v
WHERE a.id = v.id;
预期结果
DELETE 1000重复执行时,每批最多删除 1000 行;最后一个非空批次可能少于 1000 行,之后返回 DELETE 0。只要 cutoff 和候选条件保持不变,已经删除的行不会再次成为候选,因此任务中断后可以从剩余目标行继续执行。
用脚本提交、节流并继续未完成任务
下面脚本每轮只执行一条删除语句。由于没有显式开启事务,psql 默认的自动提交会让每轮成功执行的语句独立提交;成功删除一批后暂停 0.2 秒。BATCH_SIZE 默认设置为 1000,并通过正常的 psql 变量语法 :batch_size 传入 LIMIT。
#!/usr/bin/env bash
set -euo pipefail

DATABASE_URL="${DATABASE_URL:-postgresql://localhost/postgres}"
BATCH_SIZE="${BATCH_SIZE:-1000}"
SLEEP_SECONDS="${SLEEP_SECONDS:-0.2}"
CUTOFF_DATE="${CUTOFF_DATE:-2026-06-01}"

if ! [[ "$BATCH_SIZE" =~ ^[1-9][0-9]*$ ]]; then
  echo "BATCH_SIZE must be a positive integer" >&2
  exit 1
fi

while true; do
  deleted="$(
    psql "$DATABASE_URL" -X -qAt -v ON_ERROR_STOP=1 \
      -v batch_size="$BATCH_SIZE" \
      -v cutoff_date="$CUTOFF_DATE" <<'SQL'
WITH victim AS (
  SELECT id
  FROM audit_log
  WHERE created_at < :'cutoff_date'::date
  ORDER BY created_at, id
  LIMIT :batch_size
),
deleted AS (
  DELETE FROM audit_log AS a
  USING victim AS v
  WHERE a.id = v.id
  RETURNING 1
)
SELECT count(*) FROM deleted;
SQL
  )"

  printf 'deleted=%s\n' "$deleted"

  if [[ "$deleted" == "0" ]]; then
    break
  fi

  sleep "$SLEEP_SECONDS"
done
预期输出
deleted=1000
deleted=1000
...
deleted=100
deleted=0
中间批次数量取决于待删除总量,实际输出行数可能不同。关键是最终出现 deleted=0,表示当前固定 cutoff 和删除条件下已经没有剩余目标行;进程如果中途终止,重新运行脚本会继续处理仍满足条件的行。若业务仍可能插入或修改 cutoff 之前的数据,则任务完成后仍需再次执行验收查询,不能把某一时刻的 deleted=0 当成永久不变的事实。
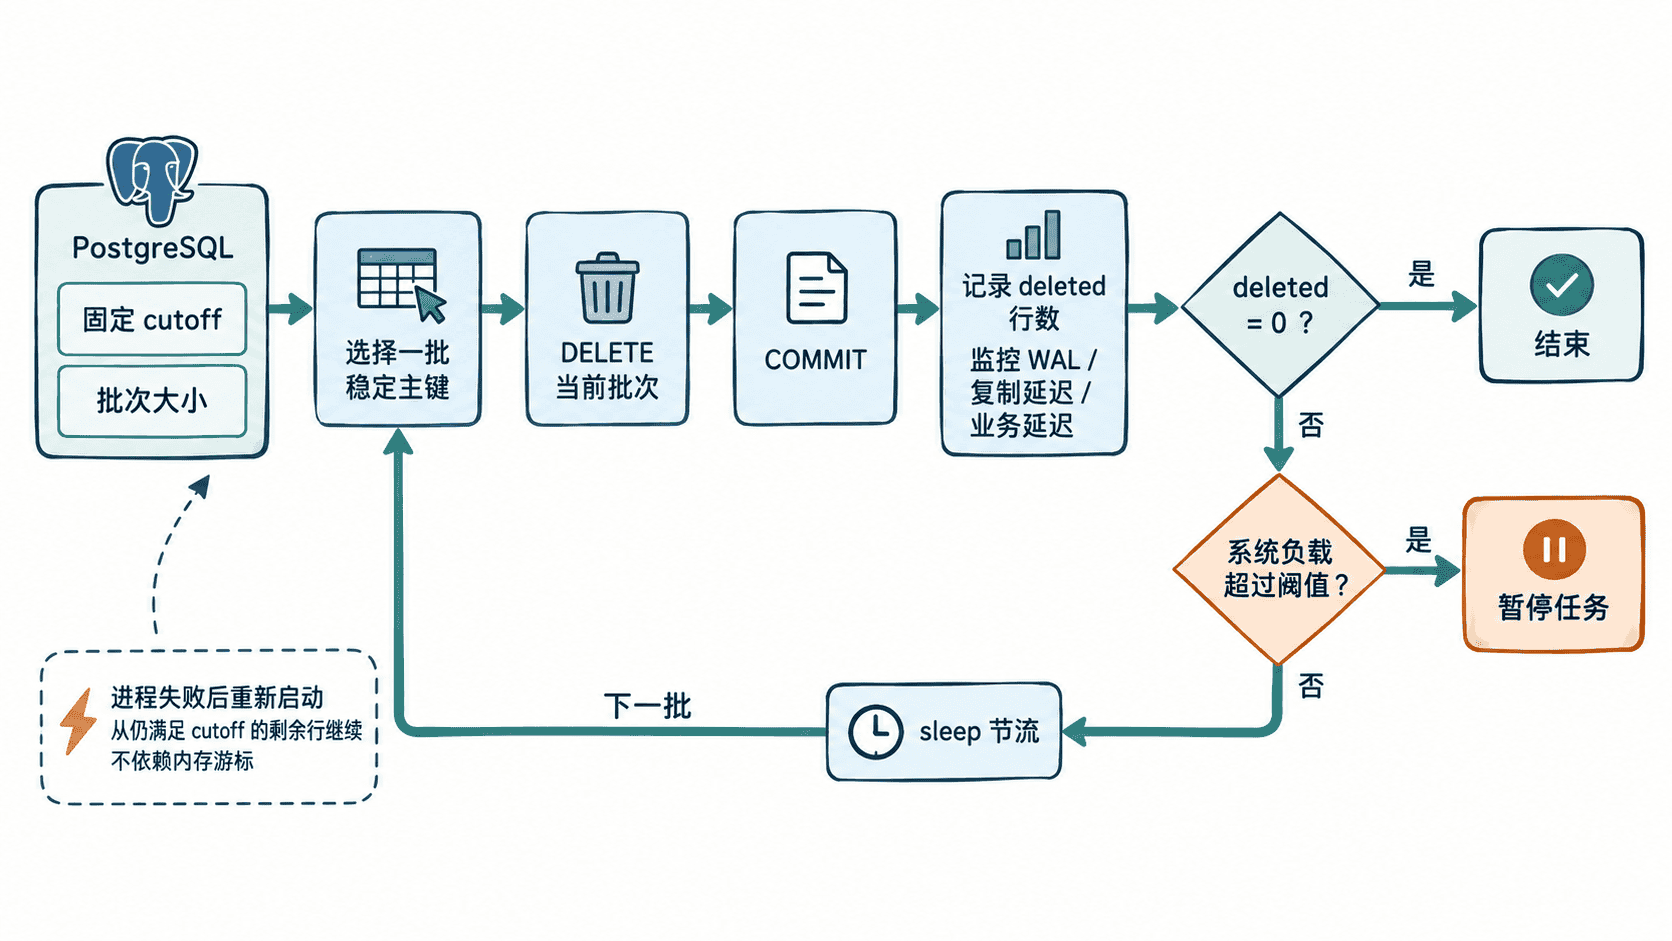
生产环境要同时看删除速度和副作用
只看“每分钟删多少行”会掩盖风险。批量删除期间至少观察数据库负载、WAL 产生速率、物理或逻辑复制延迟、长事务、锁等待,以及 autovacuum 是否有能力跟上 dead tuple 的增长。任一指标持续恶化,都应先减小批次或增加 sleep,而不是继续追求删除吞吐。
可以用下面的查询同时确认剩余目标行和当前表的 dead tuple 估算值。n_live_tup 与 n_dead_tup 来自统计信息,不是精确计数,适合观察趋势而不是作为严格验收值。
SELECT
  (SELECT count(*)
   FROM audit_log
   WHERE created_at < DATE '2026-06-01') AS remaining_rows,
  n_live_tup,
  n_dead_tup
FROM pg_stat_user_tables
WHERE relname = 'audit_log';
预期结果
 remaining_rows | n_live_tup | n_dead_tup
----------------+------------+------------
              0 |    <VALUE> |    <VALUE>
n_live_tup 与 n_dead_tup 的实际值受统计刷新和 VACUUM 时机影响,因此用 <VALUE> 表示动态结果。如果任务结束后 remaining_rows 仍大于 0,应检查 cutoff、候选条件、脚本退出逻辑以及任务是否被提前中止,不能只凭脚本退出就认定清理完成。
让任务可暂停比让任务更快更重要
安全批量删除的核心不是某个固定批次大小,而是把一次不可控的大事务改造成许多可观察、可提交、可暂停的小事务。固定 cutoff 保证本次范围不漂移,稳定唯一键保证每批可靠定位,deleted=0 提供自然终止条件,节流和监控则为生产负载保留回旋空间。如果历史数据规模已经大到需要长期依赖逐行脚本清理,应把它视为数据建模信号,后续生命周期设计应尽量让保留策略与时间分区边界对齐,把持续的逐行删除成本转换为更容易控制的整分区淘汰。