
PostgreSQL / 系统课时
构造持续增长的大表场景
构造持续增长的大表场景
生命周期治理演练需要一个既会增长、又能表现冷热访问差异的大表。本课创建带时间分布、租户维度和典型索引的样例数据,并记录治理前的容量与查询基线,后续归档、分区和清理效果才能有可比较的起点。
学习目标
- 构造具有明显时间分布的持续增长样例表
- 为近期查询和历史追溯建立具有代表性的索引负载
- 记录表容量与典型查询执行计划作为治理前基线
设计一个可治理的事件大表
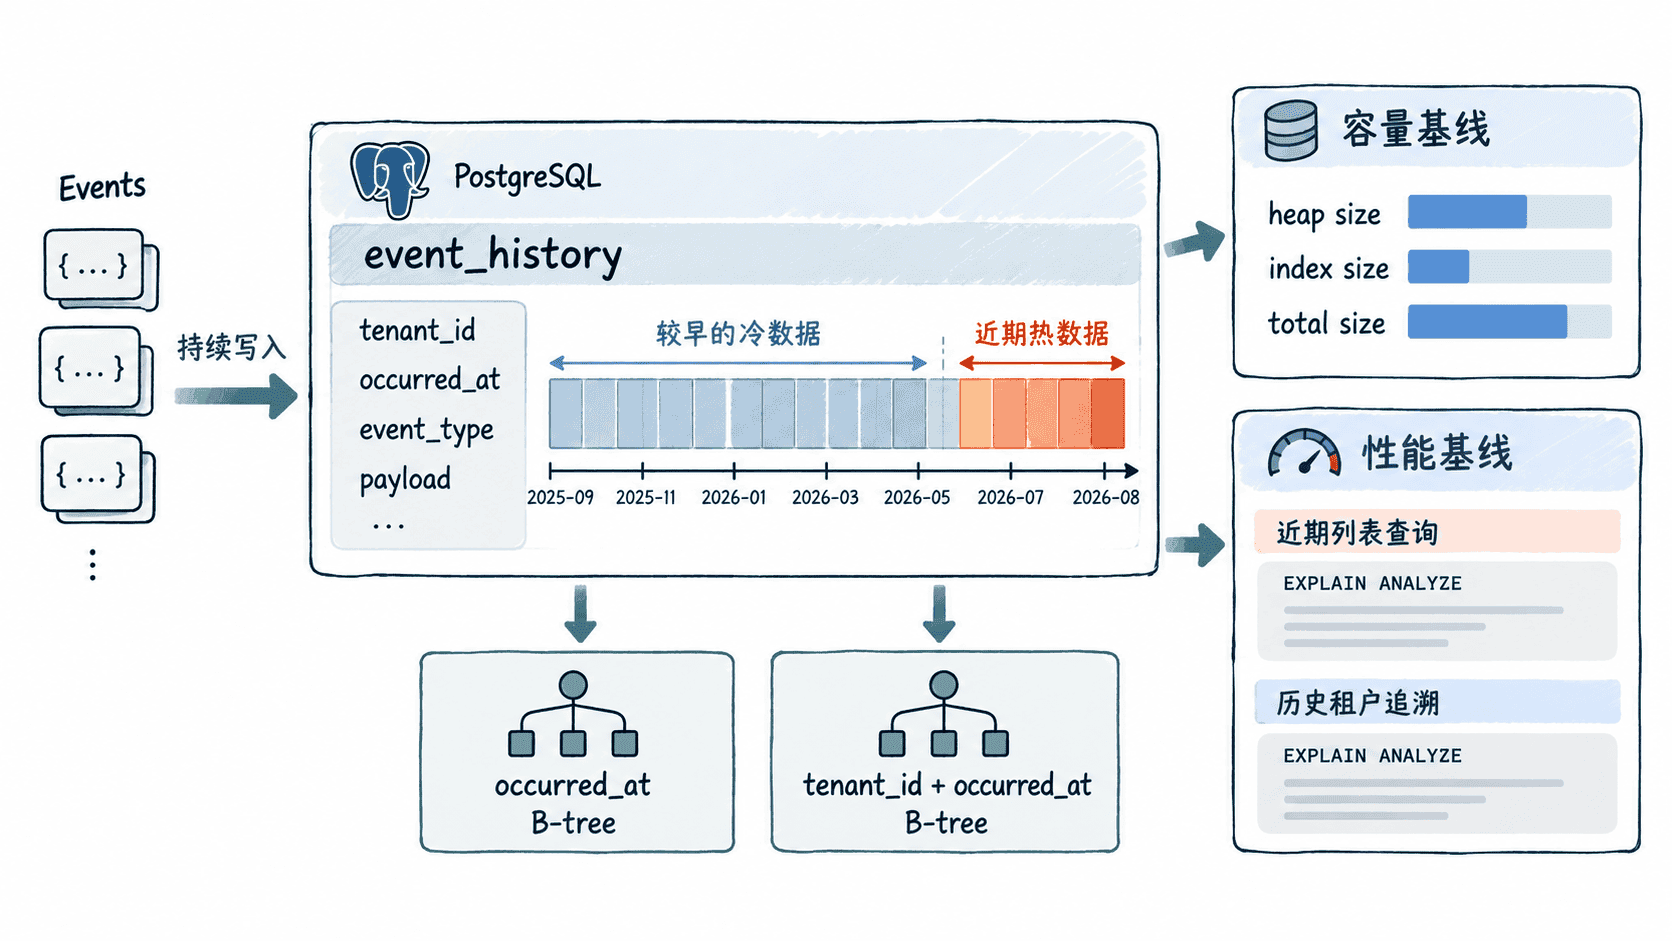
样例表需要同时满足三个条件:数据量足以让容量差异可观察,时间字段可以划分冷热边界,查询模式能够体现近期访问和历史追溯的不同成本。这里使用 event_history,以 occurred_at 表示生命周期时间,以 tenant_id 模拟多租户查询。
为了让后续实验可重复,本课使用固定时间区间生成历史数据,而不是依赖执行当天的日期。数据覆盖 2025 年 9 月到 2026 年 8 月,因此可以明确把 2026 年 7 月以后视为近期热数据,把更早的数据视为历史数据。
创建表并生成时间分布数据
下面的 SQL 会重新创建实验表并写入 100 万行数据。generate_series 提供稳定的行数,时间戳均匀分布在一年内;payload 增加单行体积,使表和索引的容量变化更容易观察。请只在实验环境运行。
DROP TABLE IF EXISTS event_history;

CREATE TABLE event_history (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    tenant_id integer NOT NULL,
    occurred_at timestamptz NOT NULL,
    event_type text NOT NULL,
    payload text NOT NULL
);

INSERT INTO event_history (tenant_id, occurred_at, event_type, payload)
SELECT
    1 + (g % 1000)::integer,
    timestamptz '2025-09-01 00:00:00+00'
        + (g % 365) * interval '1 day'
        + (g % 86400) * interval '1 second',
    CASE g % 4
        WHEN 0 THEN 'created'
        WHEN 1 THEN 'updated'
        WHEN 2 THEN 'viewed'
        ELSE 'archived'
    END,
    repeat(md5(g::text), 4)
FROM generate_series(1, 1000000) AS s(g);

CREATE INDEX idx_event_history_occurred_at
    ON event_history (occurred_at);

CREATE INDEX idx_event_history_tenant_time
    ON event_history (tenant_id, occurred_at);

ANALYZE event_history;
预期结果
DROP TABLE
CREATE TABLE
INSERT 0 1000000
CREATE INDEX
CREATE INDEX
ANALYZE
如果实验环境性能有限,可以降低 generate_series 的上限,但后续容量和查询基线必须使用同一数据规模,否则前后结果没有可比性。
建立容量基线
治理前先记录堆表、索引和整体占用。不要只记 pg_relation_size,因为生命周期治理经常改变索引占比,单看堆表无法反映真实磁盘收益。
SELECT count(*) AS rows,
       min(occurred_at) AS oldest_at,
       max(occurred_at) AS newest_at,
       pg_size_pretty(pg_relation_size('event_history')) AS heap_size,
       pg_size_pretty(pg_indexes_size('event_history')) AS index_size,
       pg_size_pretty(pg_total_relation_size('event_history')) AS total_size
FROM event_history;
预期结果
  rows   | oldest_at | newest_at | heap_size | index_size | total_size
---------+-----------+-----------+-----------+------------+-----------
 1000000 | <TIME>    | <TIME>    | <VALUE>   | <VALUE>    | <VALUE>
最早和最晚时间会落在设定的一年窗口内;具体容量受 PostgreSQL 版本、页布局和索引实现影响,因此使用 <VALUE> 表示实际测量值。后续每次归档或清理后都应再次执行同一查询,而不是凭文件系统感觉判断是否有效。
建立冷热查询性能基线
接着选两种有代表性的查询。第一种模拟应用读取最近一个月的事件,主要依赖时间索引;第二种模拟某个租户跨较长历史区间追溯数据,主要依赖复合索引。使用 EXPLAIN (ANALYZE, BUFFERS) 同时观察实际执行时间和缓存页访问。
EXPLAIN (ANALYZE, BUFFERS)
SELECT id, tenant_id, occurred_at, event_type
FROM event_history
WHERE occurred_at >= timestamptz '2026-08-01 00:00:00+00'
ORDER BY occurred_at DESC
LIMIT 100;

EXPLAIN (ANALYZE, BUFFERS)
SELECT id, occurred_at, event_type
FROM event_history
WHERE tenant_id = 42
  AND occurred_at >= timestamptz '2025-09-01 00:00:00+00'
  AND occurred_at < timestamptz '2026-07-01 00:00:00+00'
ORDER BY occurred_at;
预期结果
<QUERY PLAN USING idx_event_history_occurred_at OR AN EQUIVALENT INDEX PATH>
Planning Time: <TIME> ms
Execution Time: <TIME> ms

<QUERY PLAN USING idx_event_history_tenant_time OR AN EQUIVALENT INDEX PATH>
Planning Time: <TIME> ms
Execution Time: <TIME> ms
执行计划的节点名称和代价可能因 PostgreSQL 版本、缓存状态和统计信息而不同,因此基线重点不是追求某个固定毫秒数,而是保存执行时间、实际扫描行数、命中或读取的数据页数量以及所采用的访问路径。
模拟后续持续增长
初始 100 万行代表已经积累的历史数据。后续演练如果需要模拟每日增长,应只向时间轴尾部追加新数据,而不要重新随机覆盖历史区间。这样才能观察在线数据不断增加时,索引大小、查询路径和归档边界怎样变化。
衡量治理效果时至少保留三组基线:总行数与时间边界、堆表和索引容量、典型冷热查询的实际执行计划。只要后续实验始终使用相同统计口径,就能明确判断归档究竟减少了多少在线数据、节省了多少容量,以及近期查询是否真正获得改善。