
PostgreSQL / 系统课时
控制归档过程的锁与事务
控制归档过程的锁与事务
在线归档真正难的不是把历史行删掉,而是在持续业务流量下把每次操作限制在可控范围。本课把长事务、行锁、WAL、复制延迟和 I/O 竞争放到同一条链路中,形成可执行的批量提交与动态限速方法。
学习目标
- 识别大批量归档为什么会放大锁、WAL 和复制延迟
- 使用小事务与批量删除限制单次归档影响
- 根据事务时间、复制延迟和资源指标决定继续、降速或暂停
一次大事务为什么危险
将数百万历史行放在一个事务中处理,看起来能减少提交次数,却会扩大故障半径。事务执行越久,锁持有时间和回滚成本越高,也更容易与业务事务、VACUUM 或其他维护任务相互影响。删除产生的旧行版本不会因为提交而立刻从数据文件消失,后续仍需由 VACUUM 判断并回收可清理空间。
删除还会产生 WAL。主库不仅要完成扫描和数据页修改,还要写入 WAL,并由备库接收和回放。如果归档产生 WAL 的速度长期高于备库消费速度,复制延迟就会逐步积累。与此同时,大量扫描和写入还可能与正常查询争夺缓存、磁盘带宽与 CPU。
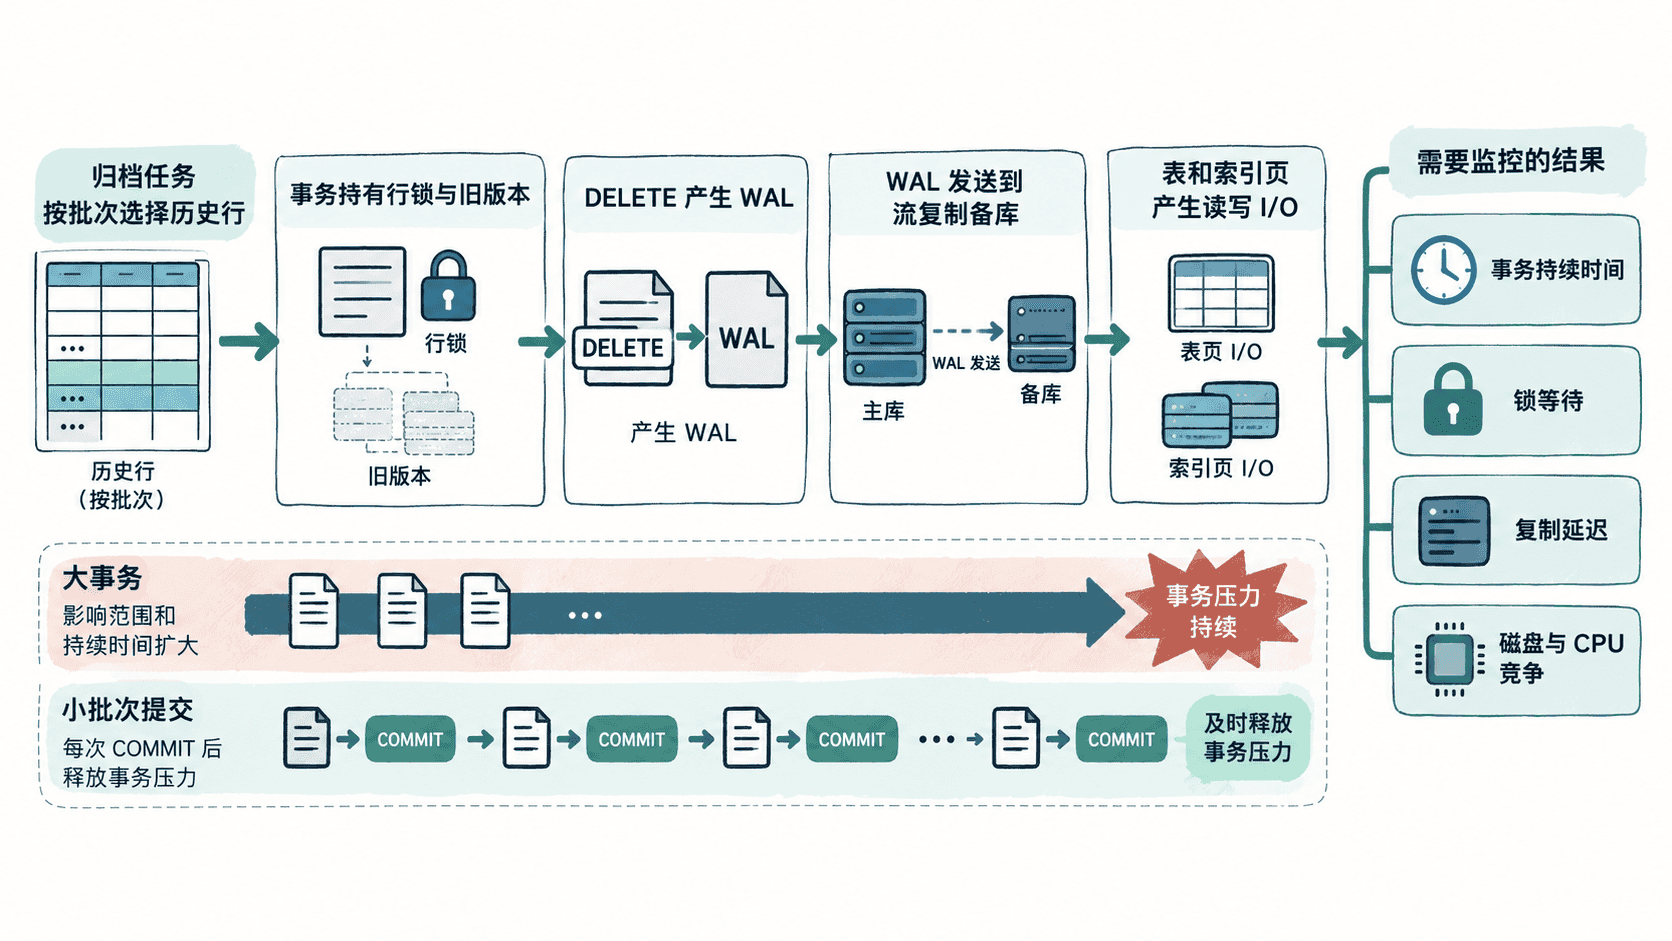
因此,在线归档不应只设定“每小时删多少行”,还应同时控制每批行数、单批事务时间、批次间隔以及暂停门槛。
用小事务限制单批影响
假设历史数据已经完成归档副本校验,现在需要从在线表 event_log 清理 archived_at 早于截止时间的数据。可以让每个事务只锁定和删除有限数量的行,并使用 SKIP LOCKED 避开正在被业务事务占用的记录。
BEGIN;

SET LOCAL lock_timeout = '2s';
SET LOCAL statement_timeout = '30s';

WITH batch AS (
    SELECT id
    FROM event_log
    WHERE archived_at < TIMESTAMPTZ '2025-01-01 00:00:00+00'
    ORDER BY archived_at, id
    FOR UPDATE SKIP LOCKED
    LIMIT 5000
), deleted AS (
    DELETE FROM event_log AS e
    USING batch AS b
    WHERE e.id = b.id
    RETURNING e.id
)
SELECT count(*) AS deleted_rows
FROM deleted;

COMMIT;
预期结果
 deleted_rows
--------------
 <VALUE>
(1 row)

COMMIT
<VALUE> 最大为 5000;最后一批通常小于该值,若部分候选行当时已被其他事务锁住,也可能更少。SKIP LOCKED 的作用不是保证严格按排序顺序清空,而是让归档任务跳过暂时不可获得的行锁,避免被少数热点记录长时间阻塞。
这里的两个超时承担不同职责:lock_timeout 限制等待锁的时间,statement_timeout 限制整条语句的执行时间。它们通过 SET LOCAL 只对当前事务生效,不会修改数据库的全局默认配置。
提交频率不是越高越好
批次越小,单次持锁时间和回滚成本通常越低,但提交过于频繁也会增加事务提交、WAL 刷写和任务调度开销。批大小应根据生产基线逐步调整,而不是固定照搬某个数字。
可以从较保守的批量开始,例如每批数千行。若单批能够稳定在目标时间内完成,复制延迟和磁盘负载仍有余量,再逐级提高批量;一旦单批耗时明显变长,应先检查查询计划、锁等待或 I/O,而不是继续增大批次。
归档循环还可以在每次提交后等待一个短间隔,为业务查询和备库回放留下恢复空间。这个间隔不必固定,可以随监控结果动态调整。
用反馈信号决定限速
归档任务至少要同时观察三组信号:数据库侧关注单批耗时、长事务和锁等待;复制侧关注 WAL 发送与回放是否持续落后;系统侧关注磁盘吞吐、I/O 等待和 CPU 是否接近业务容量上限。
运行归档时,可以用下面的 SQL 快速查看当前数据库中的长事务。示例中的 30 秒只是观察阈值,应按业务基线调整。
SELECT pid,
       now() - xact_start AS transaction_age,
       state,
       wait_event_type,
       wait_event
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
  AND now() - xact_start > interval '30 seconds'
ORDER BY xact_start;
预期结果
 pid   | transaction_age | state   | wait_event_type | wait_event
-------+-----------------+---------+-----------------+------------
 <PID> | <TIME>          | <VALUE> | <VALUE>         | <VALUE>
实际行数和字段值取决于当时的连接状态。若归档事务频繁出现在长事务列表中,应优先减小批量,并检查慢扫描或锁等待,而不是单纯缩短批次间隔。
建立继续、降速和暂停三档策略
稳定的在线归档器不应只有“运行”和“停止”两个状态。正常区间按计划执行;当复制延迟、I/O 或单批耗时接近警戒线时,减小批量并增加批次间隔;指标越过硬门槛时暂停归档,让在线业务和备库恢复。
限速策略还应具备迟滞,避免指标在阈值附近波动时频繁启停。例如触发暂停后,不要在复制延迟刚低于暂停线时立即恢复,而应等它回落到更安全的恢复线,并持续稳定一段观察窗口。
最终目标不是让归档尽快跑完,而是让归档吞吐始终服从在线业务的容量余量。只要每批事务足够短、超时可控,并由复制和资源指标反馈调节速度,历史数据清理就能从一次高风险的大操作变成可暂停、可恢复的小步推进过程。