
PostgreSQL / 系统课时
定义在线与归档查询边界
定义在线与归档查询边界
完成数据归档后,下一步不是让应用“自己决定查哪里”,而是明确哪些请求只允许访问在线热数据,哪些历史需求必须进入归档链路。本课通过查询分类、时间边界和响应目标建立一套可执行的冷热访问契约。
学习目标
- 按业务时效性划分在线查询与历史归档查询
- 为两类访问路径定义明确的时间范围和响应目标
- 通过查询入口约束避免普通在线请求无意扫描归档数据
从业务访问需求划分查询类型
冷热边界首先是访问语义,而不是表名。一个查询是否应该走在线链路,取决于用户是否需要低延迟、结果是否参与实时业务决策,以及请求覆盖的时间跨度。
例如订单详情、最近事件列表、在线风控检查通常要求低延迟,应该限定在热数据范围;审计追溯、历史报表和多年趋势分析对实时性要求较低,可以接受归档查询更长的响应时间。
可以先形成这样的服务约束:在线查询只覆盖当前保留窗口,例如最近 90 天,并以亚秒到数秒级为主要目标;超出在线窗口的请求明确进入历史查询入口,其响应时间和资源配额独立管理。实际天数和时延目标应根据业务 SLA 确定,而不是照搬固定值。
把时间边界落实到查询条件
假设在线表 event_online 只保留当前策略允许的热数据,业务接口还应显式携带时间范围,避免出现没有时间谓词的全表访问。
SELECT id, tenant_id, occurred_at, event_type
FROM event_online
WHERE tenant_id = 42
  AND occurred_at >= TIMESTAMPTZ '2026-09-01 00:00:00+00'
  AND occurred_at <  TIMESTAMPTZ '2026-09-08 00:00:00+00'
ORDER BY occurred_at DESC
LIMIT 100;
预期结果
 id   | tenant_id |      occurred_at       | event_type
------+-----------+------------------------+------------
 <ID> |        42 | <TIME>                 | <VALUE>
... | ... | ... | ...<ID>、<TIME> 和 <VALUE> 会随真实数据变化。关键不是示例中的具体日期,而是在线接口始终把查询约束在允许的热数据时间窗口内,使索引设计、容量和响应目标都具备稳定前提。
对于跨越保留窗口的历史请求,应让调用方进入独立归档入口,而不是悄悄把热表 SQL 改成同时扫描冷热两套数据。
设计两条明确的访问链路
在线查询和归档查询通常拥有不同的数据源、索引策略、并发预算和超时设置。把两者放在同一个无差别入口中,会让一个多年历史查询与线上交易查询争夺相同的数据库连接、CPU 和 I/O。
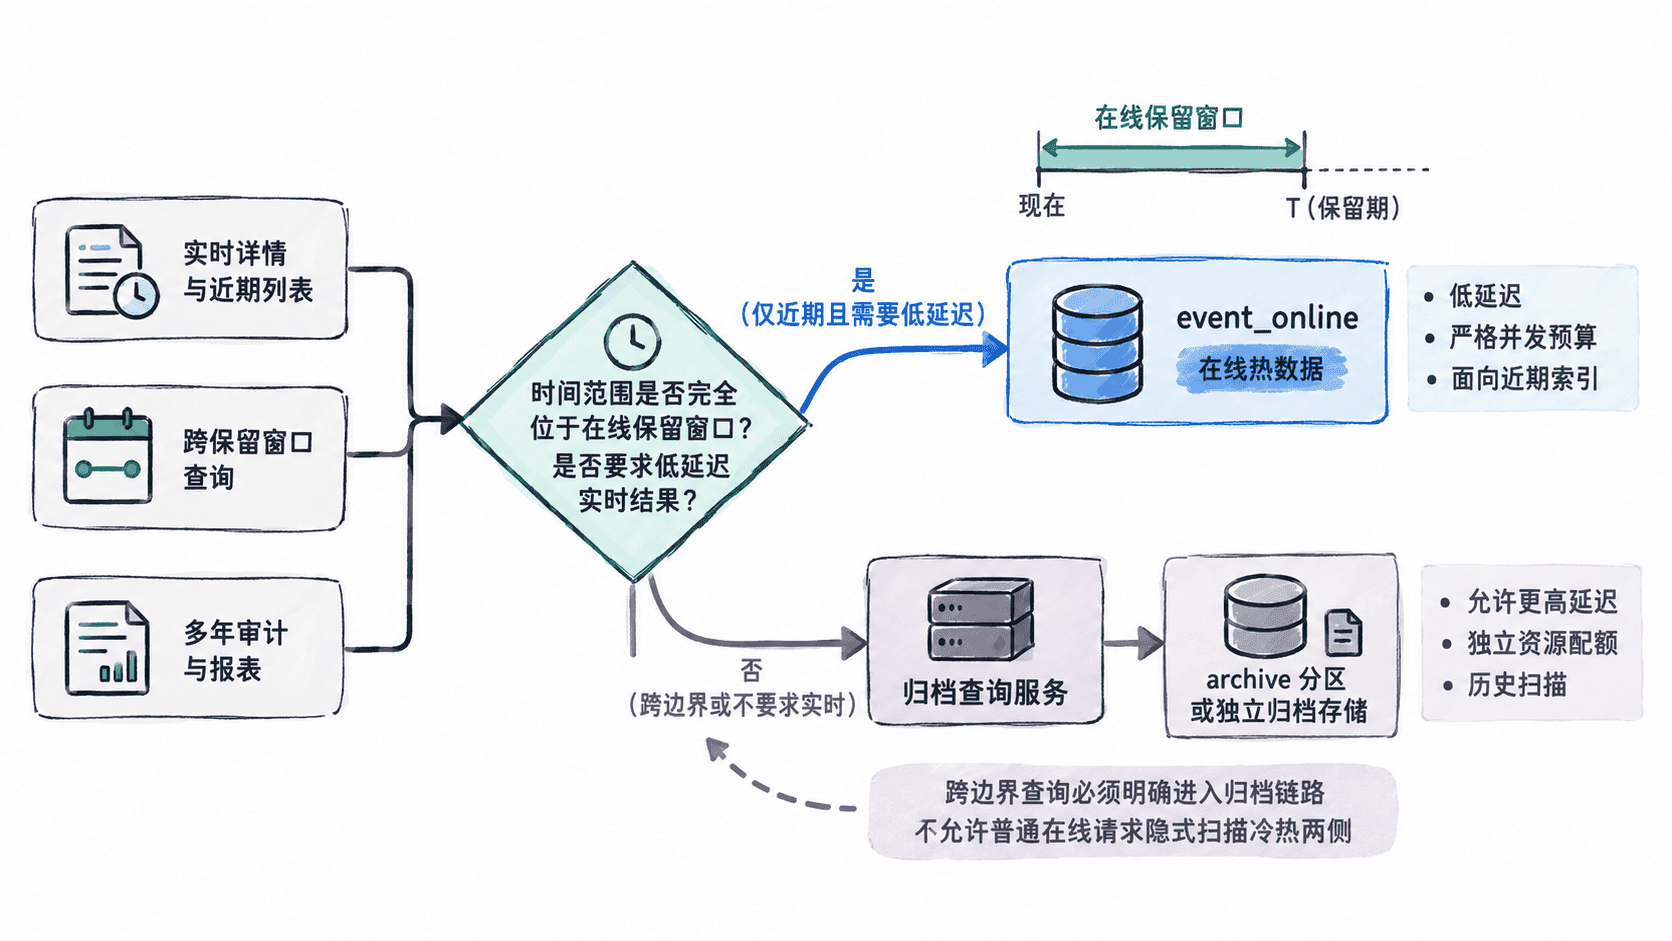
一个可执行的边界通常至少包含三个规则:请求时间范围、服务入口和响应目标。只有同时明确这三项,归档才真正从“数据搬走了”升级为“访问路径可治理”。
给历史查询单独设定响应目标
归档查询不代表可以无限慢。它仍然需要可衡量的服务目标,只是目标通常与在线查询不同。例如可以限制最大时间跨度、最大返回行数、并发任务数,并为同步查询和异步报表设置不同超时。
如果历史查询需要访问独立归档表,可先用简单聚合验证链路,而不是让应用直接执行任意 SQL。
SELECT date_trunc('month', occurred_at) AS month,
       count(*) AS event_count
FROM event_archive
WHERE tenant_id = 42
  AND occurred_at >= TIMESTAMPTZ '2025-01-01 00:00:00+00'
  AND occurred_at <  TIMESTAMPTZ '2026-01-01 00:00:00+00'
GROUP BY 1
ORDER BY 1;
预期结果
         month          | event_count
------------------------+------------
 <TIME>                 | <VALUE>
 ...                    | ...
<TIME> 和 <VALUE> 会随真实数据变化。这类查询可以接受比在线详情更高的延迟,但仍应有限制。若单次扫描可能持续数十分钟,更合适的方式通常是进入异步报表或任务系统,而不是占用同步 API 连接直到完成。
防止边界被应用代码绕过
真正危险的情况不是归档查询慢,而是普通在线代码可以无条件访问归档数据。应在接口、数据库权限或数据访问层至少设置一道硬边界,例如在线服务账号只访问热数据对象,历史查询由单独服务账号和连接池执行。
边界定义完成后,应能回答三个具体问题:什么时间范围属于在线数据,什么请求必须进入归档链路,以及每条链路允许消耗多少时间和资源。只要这三个答案仍然模糊,冷热分层就还只是存储结构变化,而不是可运营的数据生命周期方案。